Bonjour ! Dans la leçon précédente, nous avons appris à filtrer et trier les données dans un DataFrame. Ces compétences sont essentielles pour isoler les informations pertinentes. Cependant, les ensembles de données du monde réel sont rarement parfaits. Ils contiennent presque toujours des "trous" : des valeurs manquantes. Ignorer ces valeurs peut fausser complètement une analyse ou faire échouer un modèle de machine learning.
Aujourd'hui, nous allons nous attaquer à ce problème fondamental. L'objectif de cette leçon est d'apprendre à gérer les données manquantes en les détectant, en les supprimant ou en les remplaçant par des estimations judicieuses (un processus appelé imputation). Maîtriser ces techniques est une étape non négociable et absolument cruciale dans la préparation de données pour le machine learning.
1. Qu'est-ce qu'une valeur manquante et comment la détecter ?
Dans Pandas, les données manquantes sont le plus souvent représentées par une valeur spéciale : NaN, qui signifie "Not a Number". Il est important de comprendre que NaN n'est pas la même chose que la valeur 0 ou une chaîne de caractères vide "". C'est un marqueur spécifique pour indiquer l'absence de donnée.
Pour illustrer cela, créons un DataFrame avec quelques valeurs manquantes. Nous utiliserons numpy.nan pour les insérer manuellement.
import pandas as pd
import numpy as np

data = {
    'date': pd.to_datetime(['2023-10-01', '2023-10-02', '2023-10-03', '2023-10-04', '2023-10-05']),
    'temperature': [22.5, np.nan, 21.8, 22.0, np.nan],
    'humidite': [65, 68, np.nan, 72, 73],
    'evenement': ['Soleil', 'Pluie', 'Soleil', np.nan, 'Pluie']
}
df_meteo = pd.DataFrame(data)

print(df_meteo)
Résultat :
        date  temperature  humidite evenement
0 2023-10-01         22.5      65.0    Soleil
1 2023-10-02          NaN      68.0     Pluie
2 2023-10-03         21.8       NaN    Soleil
3 2023-10-04         22.0      72.0       NaN
4 2023-10-05          NaN      73.0     Pluie
Remarquez que Pandas a automatiquement converti la colonne temperature en type float pour pouvoir stocker la valeur NaN. C'est un comportement important : une colonne d'entiers (int) contenant ne serait-ce qu'une seule valeur manquante sera convertie en float64.
La première étape de toute analyse est de quantifier le problème. Pour cela, Pandas nous offre la méthode .isnull() (ou son alias .isna()), qui retourne un DataFrame de la même taille avec des booléens (True si la valeur est manquante, False sinon).
En enchaînant avec .sum(), on peut obtenir un décompte des valeurs manquantes par colonne, une commande que vous utiliserez constamment :
print(df_meteo.isnull().sum())
Résultat :
date           0
temperature    2
humidite       1
evenement      1
dtype: int64
Cette sortie nous informe clairement que nous avons 2 températures, 1 mesure d'humidité et 1 événement manquants.
La vidéo suivante de datagy vous montre très clairement comment utiliser cette technique pour identifier rapidement les valeurs manquantes dans un jeu de données.
Pandas Missing Values | Python Pandas Tutorial #6 | Pandas Dropna, Fillna, Impute Missing Values
Cette vidéo offre une introduction pratique et rapide aux concepts que nous abordons.
Regardez la première partie qui explique comment repérer et compter les valeurs nulles, de l'inspection initiale à l'utilisation de la commande .isna().sum().
2. Stratégie 1 : Supprimer les données manquantes
La solution la plus simple est de supprimer les lignes ou les colonnes qui contiennent des NaN. Pour cela, on utilise la méthode .dropna().
Supprimer les lignes (comportement par défaut)
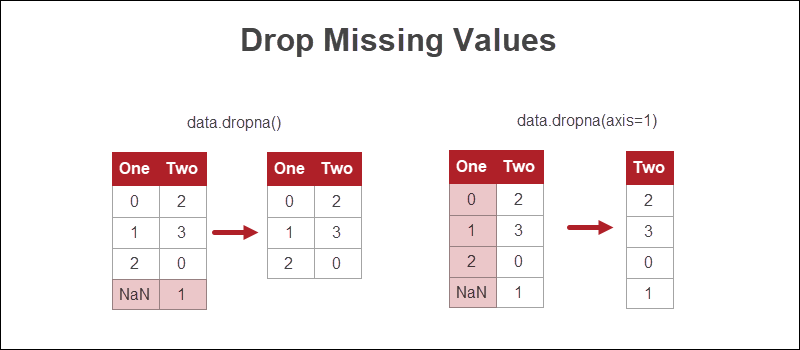
Par défaut, .dropna() supprime chaque ligne qui contient au moins une valeur NaN.
df_supprime = df_meteo.dropna()
print(df_supprime)
Résultat :
        date  temperature  humidite evenement
0 2023-10-01         22.5      65.0    Soleil
Attention ! Dans notre cas, nous avons perdu 80% de nos données. C'est souvent trop radical et peut biaiser votre analyse, surtout si les données ne manquent pas au hasard.
Supprimer les colonnes
On peut aussi supprimer les colonnes contenant des NaN en utilisant le paramètre axis=1.
df_supprime_cols = df_meteo.dropna(axis=1)
print(df_supprime_cols)
Résultat :
        date
0 2023-10-01
1 2023-10-02
2 2023-10-03
3 2023-10-04
4 2023-10-05
Ici, nous n'avons gardé que la colonne date, ce qui est encore moins utile. L'image ci-dessous illustre bien la différence entre la suppression par ligne et par colonne.
Contrôle plus fin
.dropna() offre des options pour être moins drastique :
how='all': Ne supprime une ligne/colonne que si toutes ses valeurs sontNaN.thresh=N: Conserve une ligne/colonne si elle a au moinsNvaleurs non-NaN.
Par exemple, pour ne garder que les lignes avec au moins 3 valeurs valides :
df_thresh = df_meteo.dropna(thresh=3)
print(df_thresh)
Résultat :
        date  temperature  humidite evenement
0 2023-10-01         22.5      65.0    Soleil
1 2023-10-02          NaN      68.0     Pluie
2 2023-10-03         21.8       NaN    Soleil
4 2023-10-05          NaN      73.0     Pluie
La ligne d'index 3 a été supprimée car elle n'avait que 2 valeurs valides (date et humidite).
Pour une exploration détaillée des options de dropna, le Python Data Science Handbook est une excellente référence.
Handling Missing Data | Python Data Science Handbook
Cet extrait du livre de Jake VanderPlas explique les fondements de la gestion des données manquantes dans Pandas.
Lisez les sections suivantes pour bien comprendre la logique de Pandas : La liste des méthodes clés pour opérer sur les valeurs nulles. La section "Detecting null values" qui revient sur l'utilisation de isnull(). Portez une attention particulière à la section "Dropping null values", qui détaille l'utilisation de dropna() avec ses paramètres axis, how et thresh.
3. Stratégie 2 : Remplir (imputer) les données manquantes
Supprimer des données est souvent un gâchis. Une approche plus fine consiste à remplacer les NaN par une valeur plausible. C'est ce qu'on appelle l'imputation. La méthode centrale pour cela est .fillna().
Remplir avec une valeur constante
La méthode la plus simple est de remplacer tous les NaN par une valeur fixe, comme 0.
# ATTENTION : exemple à but pédagogique, 0 n'est pas une bonne valeur ici !
df_zero = df_meteo.fillna(0)
print(df_zero)
Remplir une température ou une humidité manquante par 0 est incorrect car 0 est une mesure valide. On peut être plus spécifique en utilisant un dictionnaire :
df_rempli_specifique = df_meteo.fillna({
    'temperature': -1,  # Une valeur qui signale une erreur
    'humidite': -1,
    'evenement': 'Inconnu'
})
print(df_rempli_specifique)
C'est déjà mieux, mais pas idéal pour des modèles numériques.
Remplir avec des mesures statistiques
Une technique d'imputation très courante consiste à utiliser une mesure de tendance centrale de la colonne.
- Pour les données numériques sans valeurs extrêmes (outliers), on utilise souvent la moyenne (
mean()). - Si des outliers sont présents, la médiane (
median()) est plus robuste. - Pour les données catégorielles (texte), on utilise la valeur la plus fréquente, le mode (
mode()).
Voyons comment faire cela :
# Calculer la température moyenne
temp_moyenne = df_meteo['temperature'].mean()
print(f"Température moyenne : {temp_moyenne:.2f}")


# Remplacer les NaN de la colonne 'temperature' par la moyenne
df_meteo_impute = df_meteo.copy() # On travaille sur une copie
df_meteo_impute['temperature'].fillna(temp_moyenne, inplace=True)


# Pour 'evenement', on utilise le mode
event_mode = df_meteo['evenement'].mode()[0] # .mode() retourne une Series, on prend le 1er élément
df_meteo_impute['evenement'].fillna(event_mode, inplace=True)

print(df_meteo_impute)
Le paramètre inplace=True modifie le DataFrame directement, sans avoir besoin de le réassigner. Utilisez-le avec prudence. L'image ci-dessous montre le résultat d'une telle opération.

Remplir avec la propagation (forward/backward fill)
Pour les données séquentielles comme les séries temporelles, on peut supposer que la valeur manquante est similaire à la valeur précédente ou suivante.
method='ffill'(forward fill) : propage la dernière observation valide vers l'avant.method='bfill'(backward fill) : propage la prochaine observation valide vers l'arrière.
# Remplir en utilisant la valeur précédente
df_ffill = df_meteo.fillna(method='ffill')
print(df_ffill)
Résultat :
        date  temperature  humidite evenement
0 2023-10-01         22.5      65.0    Soleil
1 2023-10-02         22.5      68.0     Pluie
2 2023-10-03         21.8      68.0    Soleil
3 2023-10-04         22.0      72.0    Soleil
4 2023-10-05         22.0      73.0     Pluie
Remarquez comment la température du 1er octobre (22.5) a été utilisée pour le 2 octobre, et l'événement "Soleil" du 3 octobre a été propagé au 4 octobre.
La vidéo de codebasics est excellente pour visualiser ces différentes techniques de remplissage.
Python Pandas Tutorial 5: Handle Missing Data: fillna, dropna, interpolate
Cette vidéo montre de manière très claire comment implémenter les différentes stratégies de remplissage avec fillna.
Concentrez-vous sur ces deux parties : Remplissage simple et par dictionnaire : Regardez comment l'auteur remplit d'abord avec une valeur constante, puis de manière plus ciblée dans cette section. Propagation (ffill/bfill) : Observez la démonstration très claire du ffill et du bfill, y compris l'usage des paramètres axis et limit, ici.
4. Une méthode plus avancée : l'interpolation
Pour les données numériques, il existe une méthode encore plus intelligente : .interpolate(). Au lieu de simplement copier une valeur voisine, elle estime la valeur manquante en se basant sur les valeurs qui l'entourent, traçant en quelque sorte une ligne entre les points connus.
df_interp = df_meteo.copy()
df_interp['temperature'] = df_meteo['temperature'].interpolate()
print(df_interp)
Résultat :
        date  temperature  humidite evenement
0 2023-10-01         22.5      65.0    Soleil
1 2023-10-02         22.15     68.0     Pluie
2 2023-10-03         21.8       NaN    Soleil
3 2023-10-04         22.0      72.0       NaN
4 2023-10-05         22.0      73.0     Pluie
La température manquante du 2 octobre a été estimée à 22.15, la valeur à mi-chemin entre 22.5 et 21.8. C'est souvent une bien meilleure estimation que la moyenne globale ou une copie de la valeur précédente. La dernière valeur NaN n'est pas remplie car il n'y a pas de point après pour interpoler.
Exercice pratique
Mettons tout cela en pratique. Voici un DataFrame de notes d'étudiants, avec quelques "oublis".
import pandas as pd
import numpy as np

data_notes = {
    'Etudiant': ['Ahmed', 'Fatima', 'Youssef', 'Aisha', 'Mehdi'],
    'Maths': [15, 12, 18, np.nan, 11],
    'Physique': [13, np.nan, 17, 11, np.nan],
    'Statut': ['Admis', 'Admis', 'Admis', 'Redouble', np.nan]
}
df_notes = pd.DataFrame(data_notes)
Vos tâches :
- Affichez le nombre de valeurs manquantes pour chaque colonne.
- Créez un nouveau DataFrame
df_nettoyeen partant d'une copie dedf_notes. - Dans
df_nettoye, remplacez les notes de Maths manquantes par la médiane des notes de Maths. - Remplacez les notes de Physique manquantes par la moyenne des notes de Physique.
- Remplacez le Statut manquant par la valeur la plus fréquente (mode).
- Affichez le DataFrame
df_nettoyeet vérifiez qu'il ne contient plus de valeurs manquantes.
Solutions
# 1. Afficher le nombre de valeurs manquantes
print("1. Valeurs manquantes initiales:")
print(df_notes.isnull().sum())
print("\n" + "="*40 + "\n")


# 2. Créer une copie
df_nettoye = df_notes.copy()


# 3. Imputer les Maths avec la médiane
median_maths = df_nettoye['Maths'].median()
df_nettoye['Maths'].fillna(median_maths, inplace=True)


# 4. Imputer la Physique avec la moyenne
mean_physique = df_nettoye['Physique'].mean()
df_nettoye['Physique'].fillna(mean_physique, inplace=True)


# 5. Imputer le Statut avec le mode
mode_statut = df_nettoye['Statut'].mode()[0]
df_nettoye['Statut'].fillna(mode_statut, inplace=True)


# 6. Afficher le résultat et vérifier
print("6. DataFrame nettoyé :")
print(df_nettoye)
print("\nValeurs manquantes après nettoyage:")
print(df_nettoye.isnull().sum())
Résultat attendu :
1. Valeurs manquantes initiales:
Etudiant    0
Maths       1
Physique    2
Statut      1
dtype: int64

========================================

6. DataFrame nettoyé :
  Etudiant  Maths  Physique    Statut
0    Ahmed   15.0  13.000000     Admis
1   Fatima   12.0  13.666667     Admis
2  Youssef   18.0  17.000000     Admis
3    Aisha   13.5  11.000000  Redouble
4    Mehdi   11.0  13.666667     Admis

Valeurs manquantes après nettoyage:
Etudiant    0
Maths       0
Physique    0
Statut      0
dtype: int64
Conclusion
Félicitations ! Vous savez maintenant comment aborder l'un des problèmes les plus courants et les plus critiques en science des données. Le nettoyage des données n'est peut-être pas la partie la plus glamour, mais c'est là que la qualité et la fiabilité d'un projet se jouent.
Les points clés à retenir :
- Les données manquantes (
NaN) sont omniprésentes. La première étape est toujours de les identifier avec.isnull().sum(). - Supprimer (
.dropna()) est une option rapide mais dangereuse, car elle peut entraîner une perte d'information significative. - Remplir (
.fillna()) est généralement la meilleure approche. Le choix de la stratégie d'imputation (valeur fixe, moyenne, médiane, mode, propagation) dépend de la nature des données et du contexte de votre analyse. - Pour les données numériques, l'interpolation (
.interpolate()) offre souvent une estimation plus précise que les méthodes de remplissage simples.
Maintenant que nos données sont propres et complètes, nous pouvons commencer à poser des questions plus complexes. Dans la prochaine leçon, nous apprendrons à regrouper nos données en fonction de catégories pour calculer des statistiques agrégées. Par exemple, "quelle est la note moyenne en Maths pour les étudiants 'Admis' par rapport aux 'Redoublants' ?". C'est le pouvoir de la méthode .groupby(), un outil fondamental de l'analyse de données.