Bonjour ! Dans la leçon précédente, nous avons appris à localiser le "centre" d'un ensemble de données à l'aide de la moyenne, de la médiane et du mode. Cependant, comme nous l'avons évoqué, deux ensembles de données peuvent avoir exactement la même moyenne tout en étant très différents. L'un peut être étroitement regroupé autour de cette moyenne, tandis que l'autre peut être largement dispersé.
Aujourd'hui, nous allons nous concentrer sur la quantification de cette dispersion. Notre objectif est d'apprendre à calculer et à interpréter la variance et l'écart-type, deux des mesures de dispersion les plus importantes en statistiques et en apprentissage automatique. Comprendre la dispersion est essentiel pour évaluer la variabilité de vos données, ce qui a un impact direct sur la manière dont les modèles d'apprentissage automatique apprennent et généralisent.
Pourquoi la dispersion est-elle importante ?
Imaginez deux archers, Ali et Badr, qui tirent chacun cinq flèches sur une cible. Leurs résultats sont les suivants (en distance du centre en cm) :
- Ali : 1, 0, -1, 2, -2 (Moyenne = 0 cm)
- Badr : 10, -8, -12, 5, 5 (Moyenne = 0 cm)
Les deux ont une moyenne de 0, ce qui signifie qu'en moyenne, ils touchent le centre. Cependant, Ali est un archer beaucoup plus régulier et prévisible. Ses tirs sont tous regroupés près du centre. Badr est très irrégulier ; ses tirs sont très dispersés. L'écart-type nous donnera un nombre unique pour quantifier cette "régularité" ou "dispersion".
Cette image illustre bien l'idée de base : l'écart-type ("Écart-type" en français) mesure la dispersion des valeurs individuelles (les hauteurs des personnes) par rapport à la moyenne.

La Variance : Mesurer la dispersion au carré
Pour mesurer la dispersion, notre première intuition pourrait être de calculer la distance de chaque point de données à la moyenne () et d'en faire la moyenne. Le problème, comme nous l'avons vu avec les archers, est que certaines de ces distances (ou écarts) sont positives et d'autres négatives. Si nous les additionnons simplement, elles s'annuleront, nous donnant une dispersion proche de zéro même pour des données très étalées.
La solution consiste à mettre chaque écart au carré avant d'en faire la moyenne. Cela a deux avantages :
- Tous les écarts deviennent positifs.
- Les écarts plus grands (les valeurs les plus éloignées de la moyenne) sont pénalisés plus lourdement.
Ce "moyenne des écarts au carré" est ce que nous appelons la variance, notée (sigma au carré).
La vidéo suivante, en arabe, explique très clairement cette logique. Elle répond à la question fondamentale : "Pourquoi mettons-nous les écarts au carré ?".
Cette vidéo du canal EDu4LiFE donne une excellente intuition sur la signification de l'écart-type et la construction de sa formule.
Regardez les deux premières parties de la vidéo. La première, Définition, explique ce que l'écart-type représente. La seconde, La formule, explique pourquoi on ne peut pas simplement faire la moyenne des écarts et pourquoi on doit les mettre au carré.
Formellement, la variance d'une population est définie comme suit :
Où :
- est la variance de la population.
- est chaque valeur de l'ensemble de données.
- est la moyenne de la population.
- est le nombre total de valeurs dans la population.
La variance nous donne une mesure de la dispersion, mais son unité est le carré de l'unité des données d'origine (par exemple, cm², euros²). Ce n'est pas très intuitif à interpréter. C'est là que l'écart-type entre en jeu.
L'Écart-Type : La mesure de dispersion interprétable
L'écart-type (ou standard deviation en anglais), noté , est tout simplement la racine carrée de la variance.
En prenant la racine carrée, nous ramenons la mesure de dispersion à l'unité d'origine des données (cm, euros, etc.). L'écart-type peut donc être interprété comme la "distance typique" ou "l'écart moyen" des points de données par rapport à la moyenne.
- Un faible écart-type indique que les points de données sont très regroupés autour de la moyenne.
- Un écart-type élevé indique que les points de données sont très dispersés.
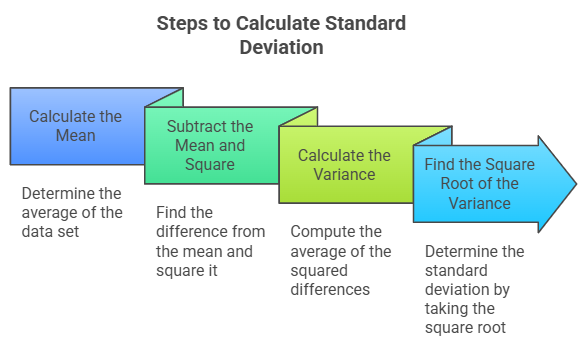
L'organigramme suivant résume parfaitement les étapes du calcul.
Population vs. Échantillon : Une distinction cruciale
Jusqu'à présent, nous avons supposé que nous avions les données de toute la population (par exemple, les notes de tous les élèves de France). En réalité, et surtout en apprentissage automatique, nous travaillons presque toujours avec un échantillon (un sous-ensemble de la population, par exemple les notes de 1000 élèves).
Lorsque nous calculons la variance ou l'écart-type à partir d'un échantillon, notre objectif est d'estimer la variance ou l'écart-type de la population entière. Il s'avère que si nous utilisons la même formule qu'auparavant (en divisant par , la taille de l'échantillon), nous sous-estimons systématiquement la véritable dispersion de la population.
Pour corriger ce biais, lorsque nous travaillons avec un échantillon, nous divisons par au lieu de . C'est ce qu'on appelle la correction de Bessel.
La formule de la variance de l'échantillon () est :
Et l'écart-type de l'échantillon () est :
Où est la moyenne de l'échantillon et est la taille de l'échantillon.
La vidéo StatQuest ci-dessous est l'une des meilleures ressources pour comprendre intuitivement pourquoi cette correction est nécessaire.
Calculating the Mean, Variance and Standard Deviation, Clearly Explained!!!
Cette vidéo de StatQuest with Josh Starmer explique avec une clarté remarquable la différence entre le calcul pour une population et l'estimation à partir d'un échantillon.
Concentrez-vous sur la section qui explique l'estimation à partir d'un échantillon, "Estimating from a sample". L'animateur explique pourquoi nous utilisons la moyenne de l'échantillon (\bar{x}) au lieu de la moyenne de la population (\mu) et pourquoi la division par n-1 est nécessaire pour obtenir une estimation non biaisée.
En pratique, en apprentissage automatique, vous utiliserez presque toujours les formules de l'échantillon (division par ).
Mettre en pratique : Le calcul pas à pas
Maintenant que nous comprenons la théorie, suivons un exemple de calcul complet. L'article de Khan Academy, en français, est parfait pour cela. Il vous guidera à travers le calcul pour la population et l'échantillon.
Résumé : écart-type de la population et écart-type de l'échantillon
Cet article de Khan Academy détaille les étapes de calcul de l'écart-type pour une population et un échantillon avec des exemples clairs.
Commencez par lire la section Exemple : Écart-type de la population pour suivre les 6 étapes sur un exemple concret de notes. Ensuite, lisez la section suivante Exemple : Écart-type de l'échantillon. Portez une attention particulière à l'étape 5, où la division se fait par n-1 = 3 et non par n = 4.
Conclusion
Dans cette leçon, nous avons ajouté deux outils statistiques fondamentaux à notre boîte à outils : la variance et l'écart-type. Vous comprenez maintenant non seulement comment les calculer, mais aussi ce qu'ils représentent et pourquoi la distinction entre population et échantillon est si importante.
Voici les points clés à retenir :
- La variance et l'écart-type sont des mesures de la dispersion des données autour de la moyenne.
- La variance est la moyenne des écarts au carré, mais ses unités sont difficiles à interpréter.
- L'écart-type est la racine carrée de la variance. Il est exprimé dans les mêmes unités que les données, ce qui en fait une mesure de dispersion plus intuitive.
- Il existe une distinction essentielle entre les formules pour la population (division par ) et pour l'échantillon (division par ). En apprentissage automatique, nous utilisons presque toujours la formule de l'échantillon.
Après avoir appris à décrire le centre (tendance centrale) et la dispersion de nos données, nous sommes prêts à aborder l'incertitude. Dans la prochaine leçon, nous entrerons dans le domaine des probabilités. Les probabilités sont le langage mathématique qui nous permet de raisonner sur le hasard et l'incertitude, une compétence fondamentale pour comprendre comment les modèles d'apprentissage automatique font des prédictions.