Bonjour ! Dans la leçon précédente, nous avons appris la compétence essentielle de sauvegarder et charger les poids d'un modèle avec state_dict. C'est la clé pour réutiliser un modèle sans avoir à le ré-entraîner à chaque fois. Maintenant que nous avons un modèle entraîné et chargé, l'étape finale et la plus gratifiante est de l'utiliser pour faire ce pour quoi il a été conçu : faire des prédictions sur de nouvelles données.
Cette leçon conclut notre module sur l'entraînement des réseaux de neurones en se concentrant sur ce processus, souvent appelé inférence. Nous allons assembler tout ce que nous avons appris pour utiliser un modèle entraîné afin de faire des prédictions sur des données qu'il n'a jamais vues. Vous verrez que si Scikit-learn simplifie cela avec une seule méthode .predict(), PyTorch nous donne plus de contrôle, ce qui nécessite de suivre un processus explicite en plusieurs étapes.
Le diagramme ci-dessous illustre le flux de travail complet en PyTorch. Jusqu'à présent, nous avons couvert la préparation des données, la création et l'entraînement du réseau. Aujourd'hui, nous nous concentrons sur la dernière étape : "Get Predictions".
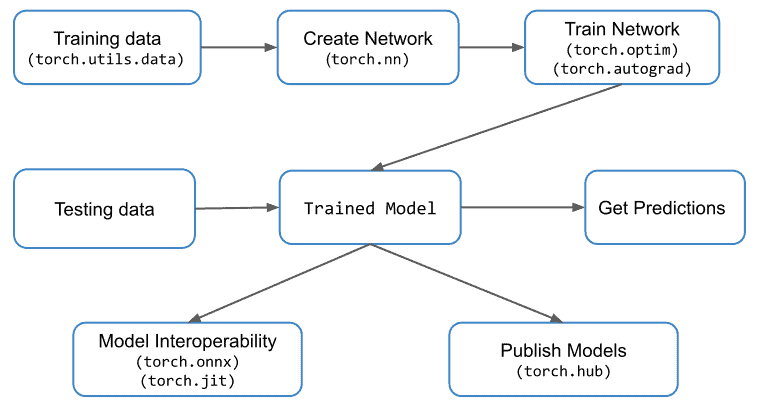
1. Les étapes clés de l'inférence
Faire une prédiction avec un modèle PyTorch chargé est un processus simple mais qui requiert de la rigueur. Voici les étapes que nous allons suivre :
- Charger le modèle entraîné : Nous réutilisons ce que nous avons vu dans la leçon précédente. On instancie d'abord l'architecture du modèle, puis on charge les poids sauvegardés avec
load_state_dict(). - Passer en mode évaluation : C'est une étape cruciale et non négociable. On doit appeler
model.eval(). - Préparer les données d'entrée : Les nouvelles données doivent être transformées en un tenseur PyTorch, avec la bonne forme (
shape) et sur le bon appareil (device). - Désactiver le calcul des gradients : Pour l'inférence, le calcul des gradients est inutile et coûteux. Nous utilisons un gestionnaire de contexte pour le désactiver.
- Faire la prédiction : On passe simplement le tenseur d'entrée au modèle.
- Interpréter la sortie : Le modèle renvoie des valeurs brutes (logits). Nous devons les convertir en une prédiction compréhensible (par exemple, une classe ou une valeur numérique).
Explorons ces étapes en détail.
2. Mettre le modèle en ordre de marche : eval() et inference_mode()
Avant toute prédiction, deux commandes sont essentielles.
model.eval() : Pourquoi est-ce si important ?
Comme nous l'avons vu, appeler model.eval() indique à PyTorch que nous passons de la phase d'entraînement à la phase d'évaluation. Cela a deux effets principaux sur le comportement du modèle :
- Désactivation du Dropout : Les couches de dropout, qui désactivent aléatoirement des neurones pendant l'entraînement pour prévenir le surapprentissage, sont complètement désactivées. Pour la prédiction, nous voulons utiliser la pleine capacité du réseau.
- Comportement de la Normalisation par lots (Batch Norm) : Les couches de
BatchNormcessent d'utiliser les statistiques (moyenne et écart-type) du mini-lot de données actuel et utilisent à la place les statistiques globales apprises sur l'ensemble des données d'entraînement. C'est fondamental pour obtenir des prédictions cohérentes et stables.
La vidéo suivante explique très clairement pourquoi model.eval() est indispensable pour obtenir des prédictions justes.
14- Pytorch: What is model.eval?
Cette vidéo de MLDawn explique en détail l'importance de model.eval() pour l'inférence.
Regardez la première partie de la vidéo expliquant le rôle de model.eval(). Concentrez-vous sur la manière dont il affecte le dropout et la normalisation par lots, deux composants que vous rencontrerez très souvent.
torch.inference_mode() : Prédire efficacement
Lorsque nous faisons une prédiction, nous n'avons pas besoin de calculer les gradients, car nous ne mettons pas à jour les poids du modèle. PyTorch nous offre un moyen de désactiver ce calcul pour économiser de la mémoire et accélérer le processus.
La méthode moderne et recommandée est d'utiliser le gestionnaire de contexte with torch.inference_mode():. Dans du code plus ancien, vous pourriez voir with torch.no_grad():. Les deux ont un objectif similaire, mais inference_mode() est plus récent et optimisé pour être encore plus rapide.
L'article suivant vous guidera à travers la mise en place d'un modèle pour la prédiction, en utilisant model.eval() et torch.no_grad().
Making Predictions with a Trained PyTorch Model | CodeSignal Learn
Cet article de CodeSignal décompose le processus de prédiction en étapes claires et simples.
Lisez les sections "Switching the Model to Evaluation Mode" et "Using the Model for Predictions". Elles expliquent l'importance de model.eval() et comment utiliser torch.no_grad() pour une inférence efficace.
3. De la donnée brute à la prédiction
Maintenant que le modèle est prêt, voyons comment lui fournir des données et interpréter sa réponse.
Préparer les données d'entrée
Votre modèle a été entraîné avec des tenseurs d'une forme spécifique (par exemple, [batch_size, num_features]). Toute nouvelle donnée doit respecter ce format. Si vous voulez prédire pour une seule instance (par exemple, un seul client, une seule image), vous devez tout de même la transformer en un "lot" d'une seule instance.
Par exemple, si votre modèle attend une entrée de forme [batch_size, 10], et que vous avez une nouvelle donnée sous forme de liste Python de 10 features [f1, f2, ..., f10], le processus sera :
- Convertir la liste en tenseur :
new_data = torch.tensor([f1, f2, ..., f10]). - Ajouter une dimension de lot :
new_data = new_data.unsqueeze(dim=0). Le tenseur aura maintenant la forme[1, 10], ce qui est compatible avec le modèle.
Interpréter la sortie du modèle
Le modèle renvoie des tenseurs de sortie bruts, appelés logits. Ce ne sont pas directement des probabilités ou des classes. C'est à nous de les transformer.
- Pour la classification binaire (par ex.,
0ou1) : Le modèle a typiquement une seule sortie. On applique une fonction sigmoïde pour transformer le logit en une probabilité entre 0 et 1. Si la probabilité est > 0.5, on prédit la classe1, sinon la classe0. - Pour la classification multi-classes (par ex.,
0,1, ou2) : Le modèle a autant de sorties que de classes. On applique une fonction softmax pour transformer les logits en une distribution de probabilités. La classe prédite est celle qui correspond à l'indice de la plus haute probabilité (torch.argmax). - Pour la régression : La sortie du modèle est directement la valeur prédite. Aucune transformation n'est nécessaire.
L'article de CodeSignal que vous venez de lire illustre bien ce processus.
Making Predictions with a Trained PyTorch Model | CodeSignal Learn
Cette section explique comment donner un sens aux sorties brutes du modèle.
Lisez la section "Interpreting Model Outputs". Elle montre comment, pour un problème de classification binaire, on transforme une probabilité en une étiquette de classe finale à l'aide d'un seuil.
La vidéo suivante de John Elder est une démonstration pratique de ce processus complet pour un problème de classification multi-classes.
Evaluate NEW Data On The Network - Deep Learning with PyTorch 8
Cette vidéo de John Elder montre concrètement comment faire une prédiction sur une nouvelle donnée avec un modèle entraîné sur le jeu de données Iris.
Regardez ces passages clés : Création de la donnée : Il crée une nouvelle donnée sous forme de torch.tensor. Faire la prédiction : Il utilise torch.no_grad() et passe la donnée au modèle. Interpréter la sortie : Il explique comment trouver la classe prédite en regardant la valeur la plus élevée dans le tenseur de sortie.
4. Un exemple complet et une astuce pratique
Mettons tout cela ensemble dans un pseudo-code que vous pouvez adapter.
# 1. Charger le modèle
# Supposons que ModelClass est la classe de votre réseau
model = ModelClass(...)
model.load_state_dict(torch.load("my_model_weights.pth"))


# 2. Passer en mode évaluation
model.eval()


# 3. Préparer les nouvelles données (exemple pour une seule instance avec 10 features)
new_data_point = [1.0, 2.5, ..., 0.5]
new_tensor = torch.tensor(new_data_point, dtype=torch.float).unsqueeze(0) # Ajout de la dimension de lot


# 4. Faire la prédiction dans le contexte d'inférence
with torch.inference_mode():
    prediction_logits = model(new_tensor)


# 5. Interpréter la sortie (exemple pour une classification multi-classes)
prediction_probs = torch.softmax(prediction_logits, dim=1)
predicted_class = torch.argmax(prediction_probs, dim=1)

print(f"Logits bruts: {prediction_logits}")
print(f"Probabilités: {prediction_probs}")
print(f"Classe prédite: {predicted_class.item()}")
Astuce : Gérer les données sur GPU
Un piège courant survient lorsque vous utilisez des bibliothèques comme Matplotlib ou NumPy pour analyser ou visualiser vos résultats. Ces bibliothèques ne peuvent pas travailler directement avec des tenseurs qui se trouvent sur un GPU. Vous devez d'abord ramener le tenseur sur le CPU.
La séquence tenseur.cpu().detach().numpy() est votre meilleure amie ici :
.cpu(): Crée une copie du tenseur sur le CPU..detach(): Détache le tenseur du graphe de calcul (nécessaire si le gradient était suivi)..numpy(): Convertit le tenseur CPU en un tableau NumPy.
Le tutoriel learnpytorch.io explique très bien cette nécessité.
01. PyTorch Workflow Fundamentals
Ce tutoriel de learnpytorch.io montre un flux de travail complet, y compris l'inférence, et aborde des points pratiques importants.
Concentrez-vous sur deux aspects. D'abord, dans la section "4. Making predictions with a trained PyTorch model", lisez le passage qui commence par "There are three things to remember". Il résume bien les étapes. Ensuite, dans la section "6.4 Making predictions", lisez la note importante concernant les bibliothèques de data science. Elle explique pourquoi et comment utiliser .cpu().
Conclusion
Félicitations ! Vous avez atteint la fin de ce module et maîtrisez désormais le cycle de vie complet d'un modèle de deep learning avec PyTorch : de la définition de l'architecture et la préparation des données, à l'entraînement, l'évaluation, la sauvegarde, le chargement et enfin, la prédiction.
Points clés à retenir :
- Le processus d'inférence est une séquence d'étapes rigoureuses :
load_state_dict,model.eval(), préparation du tenseur,torch.inference_mode(), et interprétation de la sortie. model.eval()est crucial pour garantir que les couches comme leDropoutetBatchNormse comportent correctement lors des prédictions.with torch.inference_mode():est le moyen moderne et efficace de désactiver le calcul des gradients pour accélérer l'inférence.- Les données d'entrée doivent toujours être des tenseurs avec la forme (
shape) et le type de données (dtype) attendus par le modèle. - Les sorties brutes du modèle (logits) doivent être converties en prédictions interprétables via des fonctions comme
softmaxou des seuils.
Dans le prochain module, nous allons nous appuyer sur ces fondations pour explorer des architectures de deep learning plus avancées. Nous commencerons par les Réseaux de Neurones Convolutifs (CNNs), la technologie qui a révolutionné la vision par ordinateur et le traitement des images.