Bonjour ! Dans la leçon précédente, nous avons franchi une étape majeure en entraînant de bout en bout un réseau de neurones sur des données tabulaires. Vous avez assemblé toutes les pièces du puzzle PyTorch : la préparation des données, la définition du modèle, la boucle d'entraînement et la boucle d'évaluation.
Aujourd'hui, nous allons nous attaquer à un problème très courant en apprentissage profond : le surapprentissage (overfitting). Cela se produit lorsqu'un modèle devient si bon pour mémoriser les données d'entraînement qu'il perd sa capacité à généraliser sur de nouvelles données qu'il n'a jamais vues. L'objectif de cette leçon est d'apprendre à appliquer une technique de régularisation très efficace et populaire, le dropout, pour prévenir ce phénomène et construire des modèles plus robustes.
1. Qu'est-ce que le Dropout ? L'intuition
Imaginez que vous prépariez un examen en étudiant avec un groupe. Si, à chaque session de révision, certains membres du groupe sont absents au hasard, vous ne pouvez pas compter sur une seule personne pour connaître toutes les réponses. Chaque membre est obligé de développer une compréhension plus solide et plus indépendante du sujet. Le dropout applique une idée similaire aux réseaux de neurones.
Pendant la phase d'entraînement, le dropout "désactive" ou "ignore" aléatoirement un certain nombre de neurones à chaque passage (passe avant et arrière). Cela force le réseau à ne pas devenir trop dépendant de quelques neurones spécifiques. Il doit apprendre des représentations plus redondantes et plus robustes, ce qui améliore sa capacité à généraliser.
Regardez cette courte vidéo d'Andrew Ng qui explique cette intuition de manière très claire.
Understanding Dropout (C2W1L07)
Cette vidéo de DeepLearningAI explique pourquoi le fait de désactiver aléatoirement des neurones aide à la régularisation.
Concentrez-vous sur les deux premières parties : L'intuition principale, qui explique comment le dropout force un neurone à ne pas dépendre d'une seule entrée. La connexion à la régularisation L2, qui mentionne que le dropout a un effet similaire de "réduction des poids" (shrinking weights).
L'image ci-dessous illustre parfaitement ce concept. À gauche, pendant l'entraînement, certains neurones (en blanc) sont temporairement désactivés. Leurs connexions sont inactives. À droite, pendant l'évaluation (ou l'inférence), tous les neurones sont actifs pour faire la prédiction.

2. Comment le Dropout est implémenté en pratique
Si nous désactivions simplement des neurones pendant l'entraînement, la somme totale des activations serait plus faible qu'en mode évaluation où tous les neurones sont actifs. Cela créerait un décalage. Pour compenser, les librairies modernes comme PyTorch utilisent une technique appelée Inverted Dropout (dropout inversé).
L'idée est simple : au lieu de réduire la voilure au moment du test, on augmente l'activité des neurones restants pendant l'entraînement. Plus précisément, les sorties des neurones qui ne sont pas désactivés sont mises à l'échelle (multipliées par un facteur) pendant l'entraînement. Ainsi, l'espérance (la valeur moyenne attendue) de la sortie de la couche reste la même en mode entraînement et en mode évaluation. Cela rend le passage à l'évaluation transparent et plus efficace, car aucune opération supplémentaire n'est nécessaire.
Le professeur Sebastian Raschka explique ce mécanisme de manière concise dans la vidéo suivante.
Cette vidéo explique le concept de dropout inversé, qui est l'approche standard utilisée dans PyTorch.
Regardez le début de la vidéo jusqu'à 03:39. Il explique pourquoi la mise à l'échelle est nécessaire et pourquoi elle est effectuée pendant l'entraînement plutôt que pendant le test.
3. Appliquer le Dropout dans PyTorch
Heureusement, PyTorch rend l'ajout du dropout extrêmement simple grâce à la couche torch.nn.Dropout.
L'article suivant de DataCamp fournit un excellent guide pratique. Nous allons nous en servir pour comprendre comment intégrer le dropout dans un modèle et observer son effet.
Dropout Regularization Using PyTorch: A Hands-On Guide
Cet article explique les bases du dropout et son implémentation dans PyTorch.
Commencez par lire l'introduction jusqu'à la fin de la liste pour consolider votre compréhension des avantages du dropout (prévention du surapprentissage, meilleure généralisation, réduction de la co-adaptation). Ensuite, lisez la section "Understanding the Dropout Layer in PyTorch" dans son intégralité. Elle présente la classe torch.nn.Dropout(p) et son paramètre principal p, qui est la probabilité qu'un neurone soit mis à zéro. Elle souligne également un point crucial : le dropout n'est actif que pendant l'entraînement.
Pour l'ajouter à un de vos modèles, il suffit de l'instancier dans la méthode __init__ et de l'appliquer dans la méthode forward, généralement après la fonction d'activation d'une couche cachée.
import torch.nn as nn

class SimpleClassifierWithDropout(nn.Module):
    def __init__(self, num_features):
        super(SimpleClassifierWithDropout, self).__init__()
        self.layer_1 = nn.Linear(num_features, 64)
        self.layer_2 = nn.Linear(64, 32)
        self.layer_out = nn.Linear(32, 1)

        self.relu = nn.ReLU()
        self.sigmoid = nn.Sigmoid()


        # On définit la couche de dropout. p=0.5 signifie que chaque neurone
        # a 50% de chance d'être désactivé à chaque passage.
        self.dropout = nn.Dropout(p=0.5)

    def forward(self, x):
        x = self.relu(self.layer_1(x))


        # On applique le dropout après la première couche cachée
        x = self.dropout(x)
        x = self.relu(self.layer_2(x))


        # On pourrait aussi en appliquer un ici
        x = self.sigmoid(self.layer_out(x))
        return x
Le rôle crucial de model.train() et model.eval()
Comme vous l'avez appris dans les leçons précédentes, ces deux commandes sont très importantes. Avec le dropout, elles deviennent essentielles.
model.train(): Place le modèle en mode entraînement. Cela active les couches de dropout (et d'autres couches spécifiques à l'entraînement comme la normalisation par lots).model.eval(): Place le modèle en mode évaluation. Cela désactive les couches de dropout pour que le réseau utilise toute sa capacité pour faire des prédictions.
Oublier de passer en mode eval pendant la validation ou le test est une erreur très fréquente qui conduit à des performances d'évaluation inutilement mauvaises et instables.
La vidéo de Sebastian Raschka souligne également ce point.
Revenons à la vidéo pour voir l'importance de model.train() et model.eval().
Regardez la courte section de 06:14 à 07:29 qui explique comment ces deux modes contrôlent le comportement de la couche de dropout.
4. Observer l'effet du Dropout
Maintenant, voyons le dropout en action. L'article de DataCamp que nous avons commencé à lire compare un modèle avec et sans dropout. Bien qu'il utilise un réseau convolutif (CNN) sur des images (ce qui anticipe un peu notre prochain module), le principe de régularisation et la manière d'ajouter la couche nn.Dropout sont exactement les mêmes que pour le classifieur que nous avons construit.
Dropout Regularization Using PyTorch: A Hands-On Guide
Cette partie de l'article met en œuvre et compare deux modèles.
Parcourez les sections suivantes pour voir une démonstration complète : Regardez la définition du modèle dans "Model definition with dropout". Repérez l'ajout de self.dropout = nn.Dropout(p=0.5) dans __init__ et de x = self.dropout(...) dans la méthode forward. Observez les résultats dans la section "Comparing the effect of dropout". Analysez les graphiques : La perte d'entraînement (Training Loss) du modèle avec dropout est généralement plus élevée. C'est normal, car l'entraînement est rendu plus difficile. Le plus important : l'écart entre les performances d'entraînement et de validation est réduit. La courbe de "Validation Accuracy" du modèle avec dropout est souvent plus stable et parfois même plus élevée, ce qui indique une meilleure généralisation.
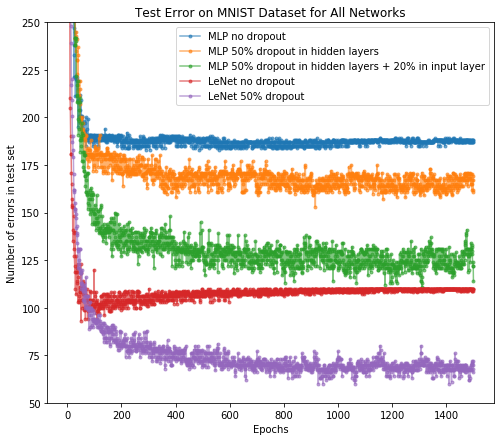
Le graphique ci-dessous, tiré d'une autre expérience, montre un résultat similaire. Il compare les taux d'erreur sur l'ensemble de test pour différents modèles. Vous pouvez voir que les versions avec dropout (en orange, vert et violet) atteignent un taux d'erreur plus faible et plus stable que leurs homologues sans dropout (en bleu et rouge).
5. Quand et comment utiliser le Dropout ?
Le dropout est un outil puissant, mais il ne faut pas l'utiliser aveuglément. Voici quelques conseils pratiques :
- Utilisez-le lorsque vous surapprenez. Le premier signe est un écart important entre votre précision d'entraînement et votre précision de validation. Si votre modèle ne surapprend pas, le dropout peut inutilement ralentir l'entraînement et même nuire aux performances.
- Commencez avec des valeurs communes. Une probabilité
pentre 0.2 et 0.5 est un bon point de départ pour les couches cachées. - Ajustez
pcomme un hyperparamètre. Vous pouvez utiliser des taux de dropout différents pour différentes couches. Les couches plus grandes (avec plus de neurones) sont plus susceptibles de surapprendre et peuvent bénéficier d'un taux de dropout plus élevé. - Le dropout peut nécessiter plus d'époques d'entraînement. Comme le dropout rend la tâche d'apprentissage plus difficile, le modèle peut avoir besoin de plus de temps pour converger.
Andrew Ng résume bien le rôle du dropout comme technique de régularisation.
Understanding Dropout (C2W1L07)
Cette dernière partie de la vidéo de DeepLearningAI donne des conseils pratiques sur l'utilisation du dropout.
Regardez cette section qui commence à 05:07. Elle souligne que le dropout est avant tout une technique de régularisation et discute de son principal inconvénient : il peut rendre la courbe de la fonction de coût moins lisse et plus difficile à interpréter pendant l'entraînement.
Conclusion
Aujourd'hui, vous avez ajouté une technique fondamentale à votre boîte à outils d'apprentissage profond. Le surapprentissage est un défi constant, et le dropout est l'une des solutions les plus simples et efficaces pour le combattre.
Points clés à retenir :
- Le dropout est une technique de régularisation qui désactive aléatoirement des neurones pendant l'entraînement pour empêcher le modèle de surapprendre.
- Il force le réseau à apprendre des caractéristiques plus robustes et distribuées, améliorant sa capacité de généralisation.
- Dans PyTorch, on l'implémente avec la couche
nn.Dropout(p), oùpest la probabilité de mise à zéro d'un neurone. - Il est impératif d'utiliser
model.train()pour activer le dropout etmodel.eval()pour le désactiver pendant la validation et le test. - L'effet du dropout se manifeste par une réduction de l'écart entre les performances sur les données d'entraînement et de validation.
Dans la prochaine leçon, nous aborderons une étape logistique essentielle : comment sauvegarder et charger un modèle entraîné. Après avoir passé du temps à entraîner un modèle performant, vous voudrez pouvoir le réutiliser sans avoir à tout recommencer