Olá! Bem-vindo de volta ao nosso curso.
Nas últimas lições, exploramos como tornar nossas aplicações resilientes a falhas de comunicação usando os padrões Retry e Circuit Breaker. Construímos serviços que podem se recuperar de problemas transitórios e se proteger de falhas em cascata. No entanto, ter uma aplicação robusta é apenas metade da batalha. Quando os sistemas se tornam complexos e distribuídos, como podemos entender o que está acontecendo dentro deles? Como diagnosticamos lentidão ou erros que abrangem múltiplos serviços?
Esta lição marca o início de um novo e crucial módulo sobre Observabilidade. O nosso objetivo de aprendizagem para hoje é: Descrever os três pilares da observabilidade (logs, traces, métricas) e como o Aspire os implementa através do OpenTelemetry. Vamos descobrir como o .NET Aspire nos fornece, desde o início, as ferramentas para ter uma visão profunda do comportamento de nossas aplicações.
O Que é Observabilidade? Os Três Pilares
Frequentemente confundida com monitoramento, a observabilidade é um conceito mais amplo. Enquanto o monitoramento nos diz se um sistema está funcionando (ex: o uso da CPU está alto, o serviço está respondendo com erros), a observabilidade nos permite fazer perguntas arbitrárias sobre o estado do sistema sem precisar prever essas perguntas com antecedência. Ela nos dá a capacidade de entender por que o sistema está se comportando de uma certa maneira.
A observabilidade moderna é sustentada por três tipos principais de dados de telemetria, conhecidos como os "três pilares".

-
Logs (Registros): São registros de eventos, com carimbo de data/hora, que ocorreram dentro de um serviço. Eles fornecem o contexto mais detalhado sobre um evento específico, como um erro, uma transação de negócios ou o início de uma operação. São a primeira ferramenta que um desenvolvedor procura para depurar um problema específico.
-
Metrics (Métricas): São medições numéricas agregadas ao longo do tempo. Pense nelas como a "saúde" geral do seu sistema. Exemplos incluem a taxa de solicitações por segundo, o uso de CPU e memória, a contagem de erros ou a latência média de uma API. As métricas são eficientes para armazenar e consultar, tornando-as ideais para dashboards e sistemas de alerta.
-
Traces (Rastreamentos): Em um sistema de microsserviços, um único pedido do usuário pode viajar por dezenas de serviços diferentes. Um trace segue a jornada completa desse pedido, mostrando cada "salto" entre os serviços (chamado de span), quanto tempo cada etapa levou e como eles se conectam. Os traces são indispensáveis para diagnosticar problemas de latência e entender as interações em sistemas distribuídos complexos.
Para obter uma visão geral clara e concisa de cada pilar, assista aos primeiros minutos do vídeo a seguir.
Metrics, Logs and Traces: What To Observe and Why
Este vídeo do canal Tech Upskill, intitulado 'Metrics, Logs and Traces: What To Observe and Why', oferece uma excelente explicação conceitual dos três pilares e das ferramentas comumente associadas a cada um.
Assista do início até 06:24. Preste atenção à forma como o apresentador define cada pilar e o tipo de problema que cada um ajuda a resolver. Observe também as ferramentas que ele menciona (Prometheus/Grafana para métricas, ELK para logs, Jaeger para traces), pois isso lhe dará um contexto sobre o ecossistema de observabilidade.
O Padrão Universal: OpenTelemetry (OTel)
Se cada serviço gera logs, métricas e traces em seu próprio formato, como podemos unificar tudo isso para ter uma visão coerente do sistema? E se quisermos mudar nossa ferramenta de visualização (por exemplo, de Jaeger para Grafana) — teríamos que reescrever toda a instrumentação em nosso código?
É aqui que entra o OpenTelemetry (OTel).
OpenTelemetry é um framework de código aberto, mantido pela Cloud Native Computing Foundation (CNCF), que fornece um conjunto padronizado de APIs, SDKs e ferramentas para instrumentar, gerar, coletar e exportar dados de telemetria. Em suma, é um padrão universal para observabilidade.
O fluxo de trabalho do OTel geralmente se parece com isto:
- Instrumentação: Seu código de aplicação (ou as bibliotecas que ele usa, como ASP.NET Core) é instrumentado com o SDK do OpenTelemetry para gerar dados de telemetria.
- Exportação: Os dados gerados são enviados para um exporter. Esse componente sabe como formatar e enviar os dados para um destino específico.
- Coleta/Visualização: O destino pode ser um collector do OpenTelemetry (um serviço que pode receber, processar e encaminhar dados) ou diretamente para um backend de observabilidade (como Jaeger, Prometheus, ou o próprio .NET Aspire Dashboard).
A comunicação entre esses componentes geralmente usa o OpenTelemetry Protocol (OTLP), um protocolo unificado para transmitir logs, métricas e traces.
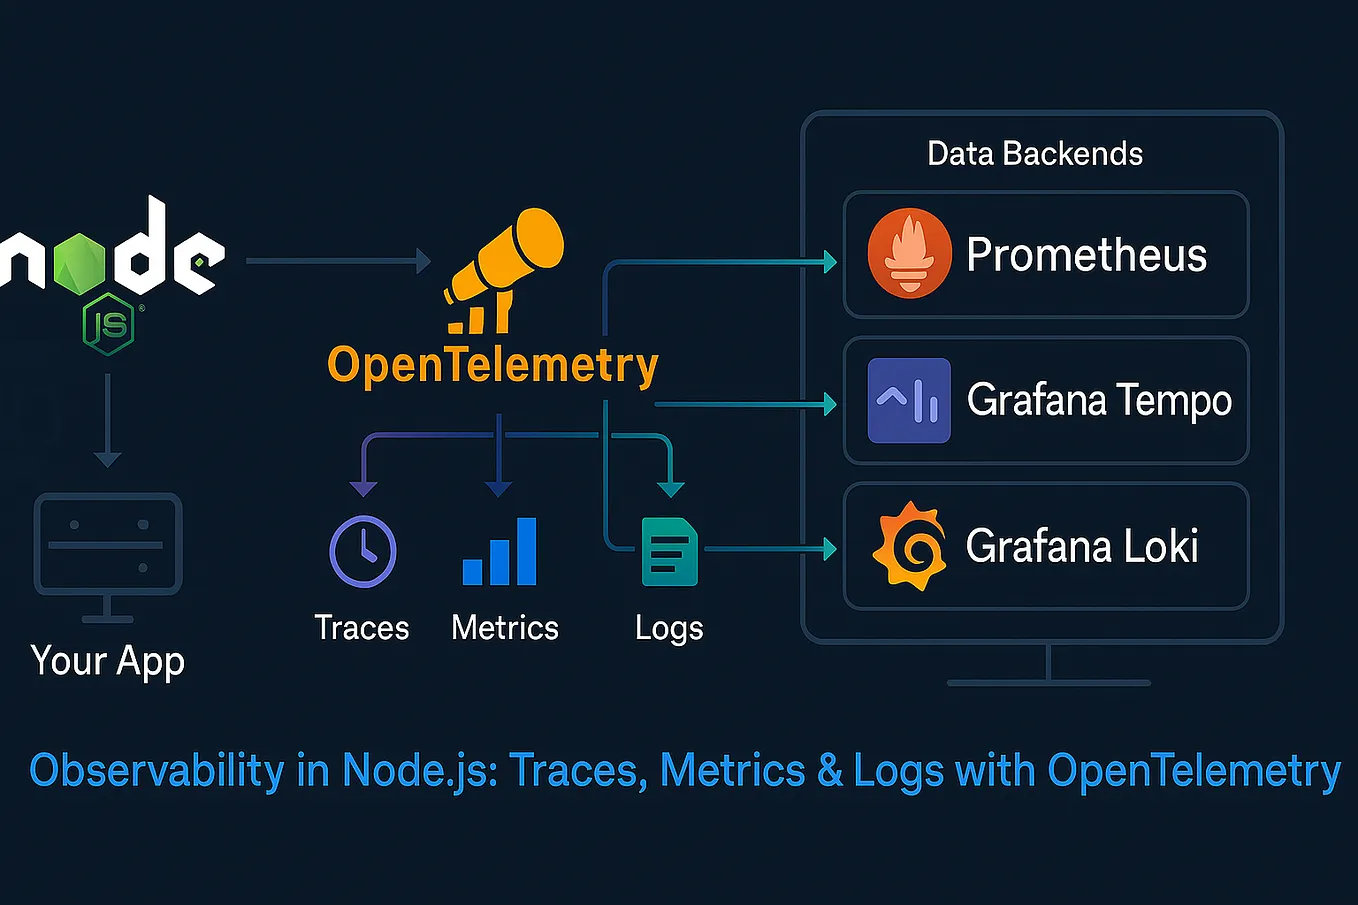
A documentação oficial do Aspire resume bem esse conceito.
A página de documentação oficial do .NET Aspire sobre Telemetria explica sucintamente os três pilares e a integração com o OpenTelemetry.
Leia as seções 'The three pillars of observability' e 'Aspire OpenTelemetry integration'. Foque em como a documentação define cada pilar e introduz o .NET OpenTelemetry SDK como a base para a observabilidade no Aspire.
Como o .NET Aspire Implementa Observabilidade
A grande vantagem do .NET Aspire é que ele torna a adoção do OpenTelemetry incrivelmente simples e automática. Você não precisa configurar manualmente cada peça do quebra-cabeça.
Lembre-se do projeto ServiceDefaults que discutimos em lições anteriores. Ele contém o segredo para a mágica da observabilidade do Aspire. Dentro do método de extensão AddServiceDefaults, há uma chamada para ConfigureOpenTelemetry.
Este método:
- Habilita os Três Pilares: Configura os provedores para coletar logs, métricas e traces.
- Adiciona Instrumentação Automática: Inclui pacotes de instrumentação para bibliotecas comuns do .NET, como:
- ASP.NET Core: Para traces e métricas de requisições HTTP recebidas.
- HTTP Client: Para traces e métricas de requisições HTTP enviadas.
- Entity Framework Core: Para traces de chamadas ao banco de dados.
- Configura o Exporter: Adiciona um OTLP exporter que envia todos os dados de telemetria para um endpoint configurado.
Durante o desenvolvimento local, o AppHost do Aspire define automaticamente a variável de ambiente OTEL_EXPORTER_OTLP_ENDPOINT para cada serviço, apontando para o .NET Aspire Dashboard. O Dashboard atua como um coletor e visualizador em tempo real para todos os dados de telemetria da sua aplicação.
O vídeo a seguir, de Milan Jovanović, demonstra de forma prática como configurar o OpenTelemetry em uma aplicação .NET e visualizá-lo no Aspire Dashboard. Embora ele comece com uma configuração manual, isso lhe dará uma apreciação ainda maior do que o Aspire faz por você automaticamente.
A practical introduction to OpenTelemetry for .NET developers (+ Aspire Dashboard)
Este vídeo, 'A practical introduction to OpenTelemetry for .NET developers', é um guia prático completo. Vamos nos concentrar em como ele configura e depois visualiza os dados.
Assista aos seguintes trechos: Introdução (00:00 - 01:11): Entenda a visão geral do OTel. Configuração do Exporter e Dashboard (04:53 - 08:57): Preste atenção em como ele configura um docker-compose.yml com o Aspire Dashboard e define o endpoint do exporter. O Aspire gerencia essa configuração para você, mas é fundamental entender como a conexão funciona. Visualização no Dashboard (08:57 - 11:11): Observe como ele interage com a interface do dashboard para ver logs estruturados, traces distribuídos e métricas. Veja como a correlação entre logs e traces (via Trace ID) funciona na prática.
O artigo de blog "Observability in .NET" também fornece um excelente resumo escrito, com exemplos de código que reforçam o que o vídeo mostra.
Observability in .NET: Mastering Logs, Metrics, and Traces ...
Este artigo de Pedro Reusing é um excelente complemento textual, mostrando a configuração do OTel e a integração com o Aspire Dashboard.
Leia as seções 'Using Docker Compose with .NET Aspire for Full Observability' e 'Visualizing Logs, Traces, and Metrics in the .NET Aspire Dashboard'. Compare o docker-compose.yml do artigo com a explicação do vídeo. Observe a importância da variável de ambiente OTEL_EXPORTER_OTLP_ENDPOINT.
Teste seu entendimento!
Imagine uma aplicação Aspire com dois serviços: Frontend.API e Products.API. Um usuário faz uma requisição para um endpoint em Frontend.API, que por sua vez chama um endpoint em Products.API para buscar informações de um banco de dados PostgreSQL. A requisição está demorando mais do que o esperado.
Usando seu conhecimento sobre os três pilares, descreva como você usaria o Aspire Dashboard para diagnosticar o problema de latência. O que você procuraria em cada um dos pilares (Traces, Metrics, Logs)?
Show answer
-
Traces (Ponto de Partida): Eu começaria na aba de Traces do Aspire Dashboard. Procuraria pelo trace correspondente à requisição lenta. O trace me mostraria um diagrama de Gantt com os spans de cada operação:
- Um span para a requisição inteira no
Frontend.API. - Aninhado a ele, um span para a chamada
HttpClientpara oProducts.API. - Dentro do
Products.API, um span para a sua própria lógica de negócios e um span aninhado para a consulta ao banco de dados PostgreSQL (graças à instrumentação do EF Core).
Observando a duração de cada span, eu poderia identificar imediatamente qual parte é o gargalo: é a chamada de rede entre os serviços? É a consulta ao banco de dados? É o processamento noProducts.API?
- Um span para a requisição inteira no
-
Metrics (Confirmação e Contexto): Após identificar o gargalo no trace (digamos, a consulta ao banco), eu iria para a aba de Metrics. Lá, eu procuraria por métricas relacionadas ao
Products.APIe ao banco de dados, como:http.server.request.durationpara oProducts.API: A latência está alta para todas as requisições ou apenas para este tipo?- Uso de CPU/memória do container do
Products.API: O serviço está sobrecarregado? - Conexões ativas do banco de dados: Há contenção de pool de conexões?
-
Logs (Detalhes Finos): Com o gargalo identificado e contextualizado, eu iria para a aba de Logs. O trace já me daria um
TraceId. Eu usaria esse ID para filtrar todos os logs de ambos os serviços que pertencem àquela requisição específica. Isso me permitiria ver logs detalhados, como a própria query SQL gerada pelo EF Core, logs de aviso sobre índices ausentes, ou qualquer outra informação de depuração que ajude a entender por que aquela consulta específica está lenta.
Conclusão
Nesta lição, estabelecemos a base para entender como monitorar e depurar aplicações modernas construídas com .NET Aspire.
Principais Pontos:
- A observabilidade nos permite entender o comportamento interno de um sistema através de seus dados externos, organizados em três pilares: Logs, Métricas e Traces.
- OpenTelemetry (OTel) é o padrão da indústria para instrumentar, coletar e exportar dados de telemetria de forma agnóstica a fornecedores.
- O .NET Aspire abraça totalmente o OpenTelemetry, fornecendo uma configuração "pronta para usar" através do projeto
ServiceDefaults. - Por padrão, os serviços Aspire são automaticamente instrumentados e exportam seus dados de telemetria para o .NET Aspire Dashboard durante o desenvolvimento local, oferecendo uma visão integrada e poderosa dos três pilares.
Próxima Lição:
Agora que compreendemos o que são os três pilares e como o Aspire os habilita, vamos mergulhar mais fundo em cada um deles. Na próxima lição, focaremos em Logs Estruturados, explorando como implementá-los corretamente em nossos serviços e como usar os recursos do Aspire Dashboard para visualizar e correlacionar logs de forma eficaz.