Olá! Bem-vindo de volta.
Na lição anterior, vimos como o padrão de repetição (Retry) é uma excelente primeira linha de defesa contra falhas transitórias. Ao configurar o HttpClient para tentar novamente uma solicitação falha, aumentamos significativamente a robustez da comunicação entre serviços. No entanto, o padrão de repetição tem uma limitação crítica: o que acontece se um serviço não estiver apenas lento, mas completamente indisponível por um período prolongado? Continuar tentando indefinidamente apenas desperdiça recursos valiosos (threads, conexões, CPU) no serviço cliente e pode, no pior dos casos, levar a uma falha em cascata, derrubando o próprio cliente.
É aqui que entra uma estratégia de resiliência mais sofisticada. O objetivo de aprendizagem de hoje é: implementar um padrão de circuit breaker padrão para lidar com serviços com falha usando Polly através dos Service Defaults do Aspire.
Vamos construir sobre o padrão Retry, adicionando uma camada de proteção que impede que nossa aplicação se esgote tentando se comunicar com um serviço que está comprovadamente fora do ar.
O Padrão Circuit Breaker
O nome do padrão vem de uma analogia direta com os disjuntores elétricos em sua casa. Se um aparelho defeituoso causa um curto-circuito, o disjuntor "abre" para interromper o fluxo de eletricidade e proteger o resto do sistema elétrico de danos.
No software, o padrão Circuit Breaker funciona de forma semelhante. Ele atua como um proxy para operações que podem falhar, como chamadas de rede. Ele monitora o número de falhas e, se elas excederem um certo limiar, o disjuntor "abre o circuito", fazendo com que todas as chamadas subsequentes para aquele serviço falhem imediatamente, sem sequer tentar a operação real. Isso evita o desperdício de recursos e permite que o sistema lide com a falha de forma mais elegante.
O padrão Circuit Breaker é um padrão com estado (stateful) e opera em três estados principais:
- Fechado (Closed): O estado padrão. As solicitações fluem normalmente para o serviço de destino. O disjuntor monitora as falhas. Se o número de falhas em uma janela de tempo exceder um limite, ele transita para o estado Aberto.
- Aberto (Open): O circuito está "aberto". As solicitações para o serviço de destino falham imediatamente, sem serem executadas (geralmente lançando uma
BrokenCircuitException). Após um tempo de espera configurado (break duration), o disjuntor transita para o estado Meio-Aberto. - Meio-Aberto (Half-Open): Neste estado, o disjuntor permite que uma única solicitação de "sondagem" (probe) passe para o serviço de destino.
- Se esta solicitação for bem-sucedida, o disjuntor assume que o serviço se recuperou e volta para o estado Fechado.
- Se a solicitação falhar, ele assume que o serviço ainda está com problemas e retorna para o estado Aberto, reiniciando o tempo de espera.
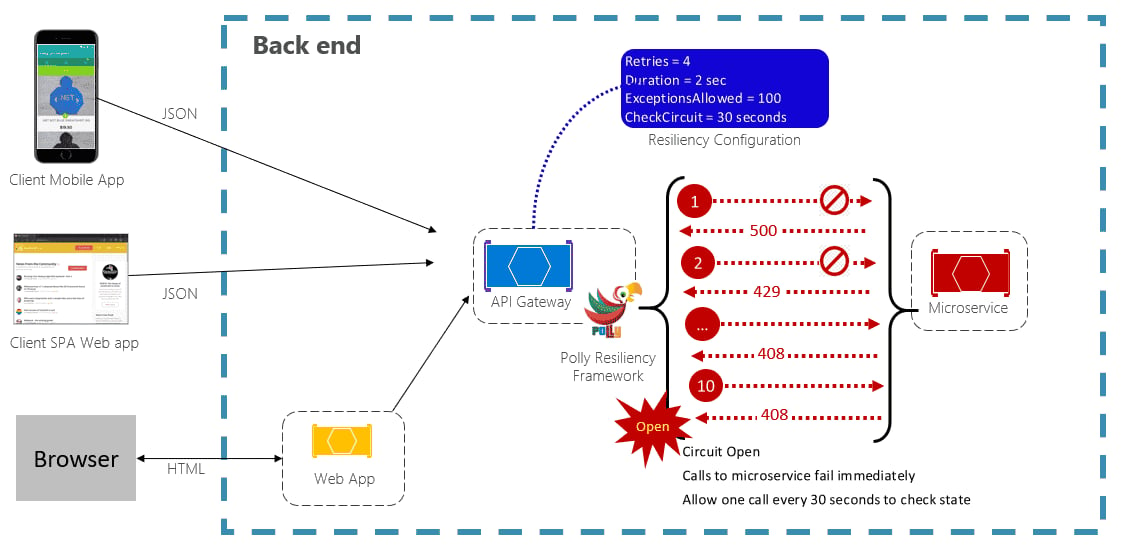
Implementando um Circuit Breaker com Polly
Assim como o padrão Retry, a implementação do Circuit Breaker em .NET é feita através da biblioteca Polly, usando a nova API Microsoft.Extensions.Http.Resilience. Para entender como o Aspire nos ajuda, vamos primeiro ver como configuraríamos um circuit breaker manualmente.
Ao construir um pipeline de resiliência, podemos adicionar a estratégia AddCircuitBreaker e configurar suas opções:
FailureRatio: A proporção de falhas que deve acionar a abertura do circuito (ex: 0.5 para 50%).SamplingDuration: A janela de tempo durante a qual as falhas são contadas.MinimumThroughput: O número mínimo de solicitações que devem passar na janela deSamplingDurationantes que o disjuntor possa abrir. Isso evita que o circuito abra com poucas falhas em um tráfego baixo.BreakDuration: O tempo que o circuito permanecerá no estado Aberto antes de tentar a transição para Meio-Aberto.
O vídeo a seguir demonstra de forma excelente como simular uma falha de serviço e ver o Circuit Breaker em ação.
Make Your HttpClient Resilient - Circuit Breaker, Retry, Timeout
Vamos voltar ao vídeo de Milan Jovanović, 'Make Your HttpClient Resilient'. Desta vez, vamos nos concentrar na seção onde ele introduz o padrão Circuit Breaker em seu pipeline de resiliência.
Assista ao trecho de 14:03 a 16:50. Observe como ele adiciona AddCircuitBreaker ao pipeline e configura suas opções. Preste especial atenção à saída no console: quando o circuito abre, as falhas se tornam quase instantâneas, retornando a BrokenCircuitException em vez de esperar por um timeout.
Para uma referência mais detalhada sobre a configuração manual, a documentação da Microsoft é o lugar ideal.
Build resilient HTTP apps: Key development patterns - .NET
A documentação oficial 'Build resilient HTTP apps' mostra como adicionar e configurar manipuladores de resiliência personalizados, incluindo um exemplo detalhado para o Circuit Breaker.
Leia a seção 'Add custom resilience handlers'. Concentre-se no bloco de código onde builder.AddCircuitBreaker é chamado. Analise as opções sendo configuradas e como elas se relacionam com os conceitos que discutimos (SamplingDuration, FailureRatio, etc.).
A Magia do Aspire: AddStandardResilienceHandler Novamente
Como você deve suspeitar, assim como no padrão Retry, o .NET Aspire já faz o trabalho pesado por nós. O método AddStandardResilienceHandler(), que é chamado por padrão no projeto ServiceDefaults, configura um pipeline de resiliência que já inclui um Circuit Breaker.
Isso significa que, por padrão, toda comunicação HttpClient em um projeto Aspire não apenas tem uma política de repetição, mas também está protegida por um circuit breaker.
Vamos consultar a documentação para ver quais são os padrões do Circuit Breaker no manipulador padrão.
Build resilient HTTP apps: Key development patterns - .NET
Vamos revisitar a documentação 'Build resilient HTTP apps', mas desta vez com foco nos detalhes do Circuit Breaker dentro do manipulador padrão.
Releia a seção 'Standard resilience handler defaults' e localize a linha da tabela referente à estratégia 'Circuit breaker'. Anote os valores padrão para 'Failure ratio', 'Min throughput', 'Sampling duration' e 'Break duration'.
Como você viu, a política padrão do Circuit Breaker é:
| Ordem | Estratégia | Padrões do Circuit Breaker |
|---|---|---|
| 4 | Circuit breaker | Failure ratio: 0.1 (10%) Min throughput: 100 Sampling duration: 30s Break duration: 5s |
Esses são padrões muito sensatos para a maioria dos cenários, protegendo seu sistema de forma robusta sem a necessidade de qualquer configuração manual. A confirmação de que o AddStandardResilienceHandler inclui um circuit breaker também é bem destacada em artigos da comunidade.
Migrating an existing project to .NET Aspire - Part 2
Este artigo de Maarten Kok, 'Migrating an existing project to .NET Aspire - Part 2', discute como o Aspire simplifica o boilerplate do HttpClient e menciona explicitamente o Circuit Breaker.
Leia a subseção 'Retry policies'. O texto confirma que o .AddStandardResilienceHandler() configura o HttpClient com 'timeouts, a circuit breaker, and retries'.
O Pipeline de Resiliência Completo
É importante entender que essas estratégias não são mutuamente exclusivas; elas são encadeadas para formar um pipeline de resiliência robusto. No caso do AddStandardResilienceHandler, a ordem é crucial:
Rate Limiter -> Total Timeout -> Retry -> Circuit Breaker -> Attempt Timeout

Essa combinação é poderosa:
- O Retry tenta lidar com falhas transitórias.
- O Circuit Breaker observa as falhas (incluindo as falhas após todas as tentativas do Retry) e protege o sistema de falhas mais duradouras.
Teste seu entendimento!
Um serviço em seu aplicativo Aspire está sobrecarregado e começa a falhar com erros 503 Service Unavailable. A configuração padrão do AddStandardResilienceHandler está ativa.
- Descreva a sequência de eventos que acontecerá a partir da primeira chamada falha do
HttpClient, considerando as estratégias de Retry e Circuit Breaker. - Após várias chamadas falhas, o Circuit Breaker finalmente entra no estado "Aberto". O que acontece quando um
HttpClienttenta fazer uma nova chamada para o serviço afetado? Por quanto tempo isso vai durar, de acordo com a política padrão? - O que acontece após esse período de tempo?
Show answer
- Para uma chamada que falha com um
503:- A estratégia Retry será acionada. Ela tentará reenviar a solicitação mais 3 vezes, com backoff exponencial.
- Se todas as tentativas falharem, a falha final será registrada pela estratégia Circuit Breaker.
- O Circuit Breaker conta essa falha em sua janela de amostragem de 30 segundos. Quando a taxa de falhas ultrapassar 10% (com um mínimo de 100 solicitações na janela), ele abrirá.
- Quando o circuito está "Aberto", qualquer nova chamada do
HttpClientpara aquele serviço falhará instantaneamente, lançando umaBrokenCircuitException. Isso acontecerá sem sequer tentar enviar a solicitação pela rede. De acordo com a política padrão, o circuito permanecerá aberto por 5 segundos (BreakDuration). - Após 5 segundos, o circuito transita para o estado "Meio-Aberto". Ele permitirá que uma única solicitação de teste passe. Se essa solicitação for bem-sucedida, o circuito se fechará e o fluxo normal será restaurado. Se falhar, o circuito voltará ao estado "Aberto" por mais 5 segundos.
Conclusão
Nesta lição, adicionamos o padrão Circuit Breaker ao nosso arsenal de resiliência. Ele é um complemento vital para o padrão Retry, protegendo nossos sistemas de falhas em cascata ao isolar serviços que estão cronicamente indisponíveis.
Principais Pontos:
- O padrão Circuit Breaker previne falhas em cascata ao interromper as chamadas para um serviço que está falhando persistentemente.
- Ele opera em três estados: Fechado, Aberto e Meio-Aberto, permitindo a recuperação automática quando o serviço dependente volta ao normal.
- Polly fornece a implementação
AddCircuitBreaker, mas o .NET Aspire simplifica tudo ao incluir um Circuit Breaker pré-configurado e robusto dentro doAddStandardResilienceHandler, que é habilitado por padrão. - As estratégias de Retry e Circuit Breaker trabalham em conjunto para criar uma aplicação altamente resiliente a diferentes tipos de falhas de comunicação.
Próxima Lição:
Até agora, implementamos mecanismos para que nossos serviços se comuniquem de forma confiável e se recuperem de falhas. Mas como podemos ver esses mecanismos em ação? Como diagnosticamos problemas complexos em um sistema com dezenas de serviços? Na próxima lição, iniciaremos um novo módulo focado em Observabilidade, explorando os três pilares que o Aspire facilita: logs, traces e métricas.