Recommended resources
The freely available resources this lesson will direct you to.
Olá! Na lição anterior, você calculou a WER comparando a saída do reconhecimento de fala com uma referência conferida. Essa medida revela divergências depois da comparação. Mas, durante a produção de uma transcrição, um sistema pode exibir outro número, chamado escore de confiança, para sinalizar o quanto considera segura a própria saída.
Nesta última lição do módulo de fundamentos, você aprenderá a usar esse sinal sem transformá-lo em certificado de acerto. A distinção importa especialmente quando uma palavra aparentemente pequena — como “não” — altera o sentido de um registro.
O que o escore informa
Imagine que o ASR produziu “O parecer foi aprovado” e atribuiu confiança de à palavra “aprovado”. A leitura apressada seria: “Há de certeza de que essa palavra está correta”. Esse significado não vem garantido com o número.
Um escore de confiança é uma estimativa produzida pelo sistema. Conforme o serviço e a forma como ele calcula sua saída, pode se referir a uma palavra, a um trecho ou a uma hipótese de transcrição. Em termos práticos, costuma indicar quão favorável foi a avaliação interna da saída escolhida; não é uma verificação independente do que foi dito no áudio. Sistemas distintos podem calcular e apresentar escores de maneiras diferentes.
Leia a introdução e a seção “Calibration” de Confidence scores in speech recognition, da The Voice AI Wiki. O texto ajuda a separar a preferência interna do reconhecedor da correção observada quando alguém confere o áudio.
Confidence scores in speech recognition: what they actually tell you | The Voice AI Wiki
Leia a abertura de “Confidence scores in speech recognition” e a seção “Calibration”, da The Voice AI Wiki, para entender por que um número alto não constitui, por si só, uma promessa de acerto.
Na abertura, comece pela explicação de que, sem calibração, o escore reflete a preferência interna do modelo. Leia a explicação inicial. Em “Calibration”, localize a frase que define um sistema bem calibrado como aquele cujas palavras com escore 0.9 estão corretas em cerca de 90% dos casos; prossiga por a discussão da calibração. Observe também a ressalva sobre comparar escores de sistemas diferentes.
É útil pensar no escore como uma resposta à pergunta “Como o sistema avaliou esta saída?”, e não como resposta definitiva a “O que foi efetivamente dito?”. Mesmo essa primeira leitura depende da implementação: um serviço pode combinar sinais e contexto ao selecionar a transcrição apresentada.
A documentação do Google Cloud Speech-to-Text oferece um exemplo concreto. Na versão documentada, o valor de confiança vai de a e estima a correção do reconhecimento. Ainda assim, o resultado classificado como melhor pode não ter a maior confiança: a escolha considera outros sinais, como o contexto da frase. Portanto, “hipótese escolhida” e “hipótese de maior escore” não são conceitos necessariamente idênticos.
Cloud Speech-to-Text overview | Google Cloud Documentation
Leia a seção “Confidence values”, na documentação do Google Cloud Speech-to-Text, como exemplo de uma definição específica de fornecedor — não como regra universal para todos os sistemas de ASR.
Na seção “Confidence values”, comece pela definição do intervalo de 0.0 a 1.0. Em seguida, leia a explicação do campo, até o exemplo de palavra rara reconhecida corretamente, mas com valor de confiança menor. Concentre-se na diferença entre estimar a correção e determinar qual hipótese aparece em primeiro lugar.
Quando um número pode ser lido como probabilidade?
Para interpretar como uma estimativa probabilística confiável, é preciso examinar a calibração. Suponha que, em uma amostra conferida, reunimos muitas palavras às quais um sistema atribuiu escores próximos de . Se cerca de dessas palavras estiverem corretas, o comportamento é compatível com boa calibração nessa faixa e nessas condições. Se apenas estiverem corretas, o sistema estará superestimando a própria certeza nessa faixa.
O vídeo Model Calibration, do canal TwinEd Productions, mostra visualmente como comparar faixas de escores com a frequência de acertos observada. O exemplo usa imagens, não fala; transfira o raciocínio para palavras transcritas e conferidas no áudio.
Model Calibration | Machine Learning
Assista ao trecho de “Model Calibration”, do canal TwinEd Productions, para visualizar a diferença entre emitir um escore e demonstrar que ele corresponde à frequência real de acertos.
Veja a pergunta central sobre interpretar saídas entre 0 e 1 como probabilidades. Depois, acompanhe a comparação entre faixas de escores e resultados observados. No contexto desta lição, substitua mentalmente cada imagem classificada por uma palavra do ASR cuja correção foi conferida.
Essa comparação exige vários casos com resultado conhecido, não a inspeção de um único escore. Por exemplo, se 100 palavras receberam escores em torno de e 78 estavam corretas, a fração observada de acertos nesse grupo foi , não . Os valores do exemplo são ilustrativos: para avaliar um sistema real, seria necessário conferir uma amostra adequada de áudio e observar diferentes faixas de confiança.
Há duas cautelas importantes:
- Calibração é uma propriedade de grupos de previsões. Mesmo que aproximadamente das palavras com escore estejam corretas, algumas estarão erradas. Boa calibração não identifica quais são essas palavras nem garante o acerto de uma palavra isolada.
- As condições de uso importam. Um comportamento observado em gravações limpas pode não se repetir em fala sobreposta, áudio distante ou vocabulário pouco frequente. É preciso verificar se a avaliação representa os áudios em que o escore será usado.
Confiança e WER respondem a perguntas diferentes. A WER contabiliza erros de palavras após comparar a hipótese com uma referência, incluindo substituições, exclusões e inserções. O escore sinaliza uma estimativa do próprio sistema, sem exigir referência naquele momento. Um conjunto de escores altos não demonstra, por si, WER baixa; tampouco cobre toda a qualidade editorial da transcrição.
Escores altos também aparecem em erros
A imagem abaixo distribui palavras reconhecidas corretamente e incorretamente por faixas de confiança. O eixo vertical mostra contagens em escala logarítmica: ele não apresenta diretamente a porcentagem de acertos em cada faixa.
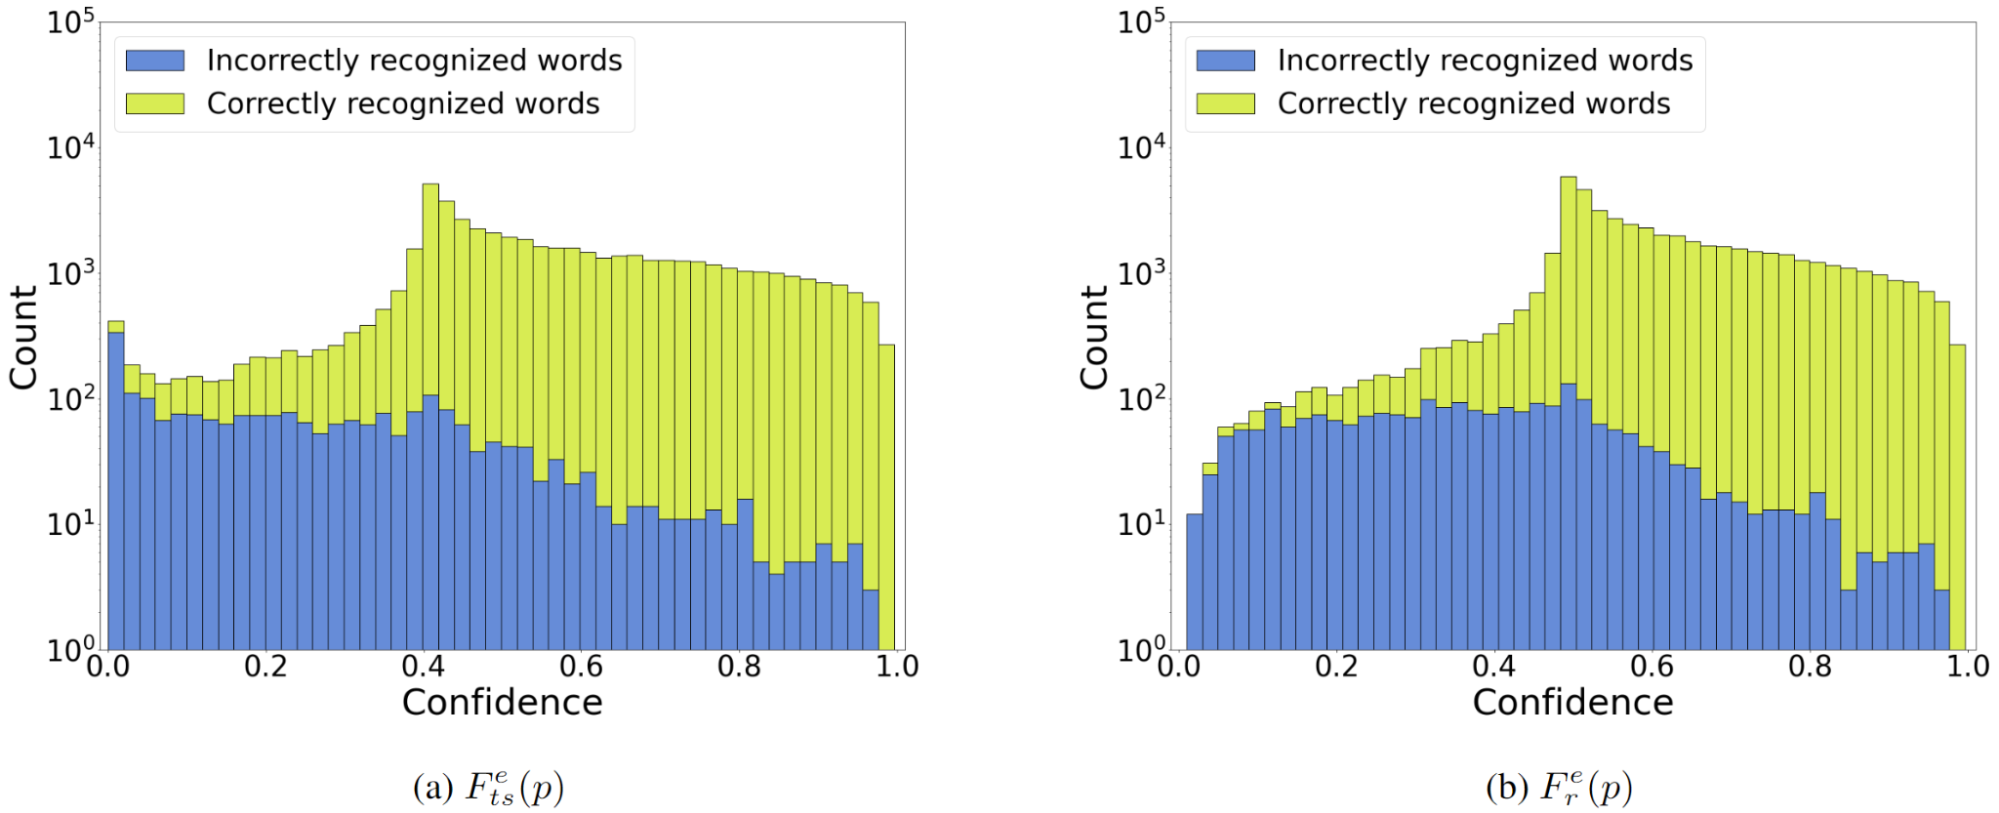
O ponto visual mais importante é a sobreposição. Um escore baixo merece atenção, mas não prova erro. Um escore alto pode tranquilizar, mas não elimina a possibilidade de erro. Para avaliar calibração, seria preciso calcular, em cada faixa, a fração de palavras corretas e compará-la com os escores atribuídos; os gráficos exibem contagens, não essa comparação pronta.
Por que um sistema pode errar com confiança alta? Considere uma fala que contém o nome incomum de uma pessoa. Se o reconhecedor substituir esse nome por uma palavra mais frequente que lhe pareça plausível, poderá preferir fortemente a alternativa errada. Algo semelhante pode ocorrer com números, siglas ou palavras geradas a partir de ruído. A ausência de dúvida entre as alternativas consideradas pelo modelo não assegura fidelidade ao áudio.
Na seção “Causes of incorrect high-confidence output” do texto já introduzido, leia os exemplos de números, palavras produzidas sem apoio suficiente no áudio e nomes raros. Em seguida, leia “Appropriate uses of confidence scores” para passar do diagnóstico ao uso operacional.
Confidence scores in speech recognition: what they actually tell you | The Voice AI Wiki
Retome “Confidence scores in speech recognition”, da The Voice AI Wiki. Agora procure as seções “Causes of incorrect high-confidence output” e “Appropriate uses of confidence scores”: elas mostram, respectivamente, por que o escore pode falhar e para que ainda serve.
Em “Causes of incorrect high-confidence output”, leia os exemplos de erro, até a explicação sobre nomes raros. Depois, em “Appropriate uses of confidence scores”, comece pelo parágrafo sobre priorização dentro de uma mesma transcrição e leia as orientações de uso, incluindo a tabela. Foque na distinção entre indicar onde revisar e certificar que uma palavra está correta.
Como usar a confiança na revisão
O uso mais defensável do escore é organizar a atenção humana, não dispensá-la. Se vários trechos de uma transcrição feita pelo mesmo sistema recebem confiança comparativamente baixa, eles podem entrar primeiro na fila de escuta. Uma queda de confiança ao longo de um trecho também pode sugerir que algo mudou no áudio e merece investigação.
Essa priorização, porém, deve conviver com uma segunda pergunta: qual seria o impacto de um erro aqui? Em um registro de deliberação, uma negação, um resultado de votação, um número, um nome próprio ou a autoria de uma fala pode exigir conferência mesmo com escore alto. Já uma palavra de ligação com escore baixo talvez seja simples de resolver ao ouvir o trecho. A regra operacional, portanto, não é “revisar apenas o que ficou abaixo de ”, mas combinar sinal de incerteza, risco do conteúdo e escuta do áudio.
Se uma equipe quiser usar um limiar numérico para encaminhar trechos à revisão, esse valor não deve ser escolhido como se fosse universal. Antes, é preciso verificar, em áudios representativos da tarefa, quantos erros aparecem acima e abaixo do limiar e quantos trechos a regra encaminharia. Um corte que funcione para uma gravação preparada pode deixar passar erros importantes em um debate com sobreposição de vozes.
Também evite três conclusões que o escore não sustenta:
- “O fornecedor A é mais preciso porque exibe confiança média maior que o fornecedor B.” Escalas e métodos de cálculo podem diferir. Para comparar precisão, use os mesmos áudios, uma referência conferida e critérios comuns de avaliação.
- “O trecho recebeu escore alto; pode ser publicado sem conferência.” Confiança não é garantia, e há erros de grande impacto que podem receber escores altos.
- “O trecho recebeu escore baixo; a palavra deve ser apagada.” Incerteza não prova que a palavra esteja ausente ou incorreta. O caminho é conferir o áudio e registrar a decisão conforme a política editorial.
Para uma resposta discursiva, vale formular a distinção com precisão: escores de confiança podem apoiar a triagem da revisão, desde que seu significado e sua calibração sejam verificados nas condições de uso; não substituem a avaliação com referência nem a validação humana de informações críticas.
Em síntese
O escore de confiança expressa uma estimativa do sistema, não uma garantia de que a transcrição corresponde ao áudio. Só se pode atribuir a ele uma interpretação probabilística confiável após verificar a calibração em exemplos conferidos e representativos; mesmo bem calibrado, um escore alto não assegura o acerto de um caso individual.
Use a confiança para localizar trechos que merecem atenção, sem ignorar palavras de alto impacto com escores elevados. Com isso, concluímos os fundamentos de áudio, erros e avaliação do ASR. No próximo módulo, você examinará como diferentes modelos de reconhecimento de fala são organizados e produzem suas transcrições.