Recommended resources
The freely available resources this lesson will direct you to.
¡Hola! En la lección anterior dibujaste un asistente de IA con interfaz, aplicación coordinadora, modelo, fuentes documentales, integración con pedidos y supervisión. Ese croquis respondía a «¿qué piezas intervienen?». Ahora haremos otra pregunta: ¿qué datos pasan por cada pieza, quién puede verlos y dónde pueden permanecer?
Seguiremos el ejemplo del asistente que ayuda a preparar respuestas sobre devoluciones. El objetivo no es convertirte en especialista en ciberseguridad o protección de datos, sino darte un método para detectar riesgos antes de ampliar un piloto y plantear preguntas precisas a los equipos responsables.
Del diagrama de componentes al recorrido de la información
Un mismo asistente puede recibir datos por varias vías. La persona usuaria escribe una consulta; la búsqueda aporta un fragmento de la política de devoluciones; el sistema de pedidos devuelve un estado actualizado. La aplicación reúne parte de esa información para solicitar un borrador al modelo. Después puede haber una respuesta visible, un registro técnico y una copia pegada en otra herramienta de trabajo.
El vídeo siguiente ayuda a mirar más allá del chat: señala que la información puede entrar por una consulta, un archivo, una fuente recuperada o una herramienta conectada, y que también puede transformarse antes de llegar a su destino.
AI Is Exposing Your Data: An AI Security Problem You Can't See
«AI Is Exposing Your Data: An AI Security Problem You Can't See», de IBM Technology, ofrece una vista general de los puntos por los que circulan datos en aplicaciones de IA.
Mira las entradas y localiza consultas, archivos, recuperación documental y herramientas. Después, en las transformaciones, fíjate en por qué importa seguir el origen y destino de los datos incluso cuando cambian de formato o una persona los copia fuera de la aplicación. El vídeo presenta sistemas más amplios que nuestro asistente: no presupongas que este necesita agentes autónomos ni que registrar toda la actividad de cada empleado sea una medida adecuada.
Hay una distinción importante que el vídeo no resuelve por sí solo: enviar una consulta a un proveedor no significa necesariamente que este la utilice para entrenar un modelo. Para saber qué ocurre hay que comprobar la configuración del servicio, las condiciones aplicables, los acuerdos y las prácticas efectivas de conservación. Tampoco basta con llamar «privada» a una herramienta: hay que conocer sus flujos reales.
Traza una consulta de principio a fin
Supongamos que una agente de atención escribe: «¿Puedo devolver el artículo del pedido 4827? Prepara una respuesta para el cliente». Trabajaremos con un identificador ficticio. El asistente solo está autorizado a consultar la política y el estado del pedido, y a generar un borrador que una persona revisará.
Para trazar datos, añade a cada parada del croquis anterior cinco anotaciones: dato, finalidad, quién accede, transformación y destino o conservación. Una primera versión podría ser esta:
| Parada | Qué dato interviene y qué conviene comprobar |
|---|---|
| Interfaz | Recibe la pregunta y el identificador del pedido. ¿Se ha pegado también un correo completo, una dirección o información innecesaria? |
| Aplicación coordinadora | Comprueba la identidad y los permisos de quien consulta. Decide qué información necesita para esta tarea, en lugar de remitir toda la conversación a cada servicio. |
| Fuente documental | Devuelve el fragmento pertinente de la política. Si los documentos se cargaron previamente en un índice de búsqueda, también hay que conocer ese recorrido de carga y actualización. |
| Integración con pedidos | Consulta el pedido y devuelve, por ejemplo, el estado necesario para responder. ¿La conexión permite leer únicamente los campos autorizados o expone la ficha completa del cliente? |
| Servicio del modelo | Recibe la petición que compone la aplicación: pregunta, instrucciones y contexto seleccionado. ¿Qué información sale hacia el proveedor, dónde se procesa y bajo qué condiciones se conserva? |
| Respuesta y revisión | El borrador vuelve a la interfaz. Una persona verifica la política y el estado antes de enviarlo. Si lo copia a un correo o CRM, aparece otro destino que debe figurar en el mapa. |
| Registros y copias | La aplicación, el proveedor y las integraciones pueden generar registros. ¿Guardan solo datos técnicos o también la consulta, el fragmento recuperado y la respuesta? ¿Durante cuánto tiempo? |
La tabla no afirma que todas las implementaciones guarden lo mismo. Distingue lo conocido de lo que hay que verificar. Ese es precisamente el valor del trazado: convierte una frase imprecisa —«los datos pasan por la IA»— en preguntas comprobables para el cliente, tecnología, seguridad y protección de datos.
La Agencia Española de Protección de Datos llama trazabilidad del dato a la capacidad de conocer su ciclo de vida, incluidas su fuente, transformaciones, usos y traslados. Lee su formulación pensando en qué información faltaría para completar nuestra tabla.
inteligencia artificial agéntica
Lee el apartado sobre trazabilidad de las orientaciones de la Agencia Española de Protección de Datos. Aunque el documento trata sistemas agénticos, su pregunta sobre el ciclo de vida del dato sirve también para un asistente más sencillo.
En el capítulo VII, «Medidas», apartado F, «Control del agente desde el diseño», localiza la viñeta «Trazabilidad» en la p. 69. Lee la explicación desde su definición hasta el párrafo sobre registros de fuentes y servicios. Fíjate especialmente en que no basta con identificar el origen: importan también las transformaciones, los usos y los destinos intermedios.
Trazabilidad no significa guardar indefinidamente cada texto íntegro. Los registros pueden ayudar a investigar un fallo, pero también convertirse en un nuevo depósito de datos personales. El diseño debe equilibrar evidencia útil, acceso restringido y plazos de conservación justificados.
Identifica el riesgo en la parada donde nace
Una vez trazado el recorrido, examina cada parada desde tres ángulos:
- Privacidad: ¿se trata información personal necesaria para una finalidad definida y autorizada? ¿Se comparte, reutiliza o conserva más de lo previsto?
- Seguridad: ¿podría alguien acceder sin permiso, alterar información o impedir que esté disponible cuando se necesita?
- Uso indebido: ¿podría una persona o un contenido externo hacer que el asistente emplee sus conexiones para una finalidad no prevista, incluso sin «romper» técnicamente el sistema?
Estos ángulos se solapan, pero evitan reducir todos los problemas a «una filtración». Si el asistente entrega al modelo el expediente completo cuando solo necesita el estado del pedido, hay un problema de minimización aunque nadie haya atacado el sistema. Si consulta una política antigua, puede generar una respuesta errónea aunque el acceso sea legítimo. Si muestra el pedido de otra persona, se combinan un fallo de permisos y una posible exposición de datos.
La guía de seguridad de la autoridad francesa de protección de datos, CNIL, propone analizar tres sucesos temidos: acceso ilegítimo, modificación no deseada y pérdida temporal o permanente de datos. Después pide considerar efectos sobre las personas, fuentes de riesgo, medidas, gravedad y probabilidad.
Practice guide GDPR - Security of personal data 2024
Consulta la ficha de «Risk Analysis» de la CNIL. Proporciona una estructura breve para pasar del mapa de datos a riesgos concretos, sin confundir un inventario de herramientas con un análisis de consecuencias.
Ve a «Factsheet 20 – Risk Analysis», pp. 47–49. Dentro de «Basic precautions», lee los tres pasos: identificar tratamientos y soportes; valorar acceso, modificación y pérdida; implantar y revisar medidas. En la tabla de la p. 49, observa que el primer campo después del suceso temido es su efecto sobre las personas, no solo el perjuicio para la organización.
Apliquémoslo al ejemplo. Si la integración de pedidos devuelve direcciones y teléfonos además del estado, la agente quizá no los vea, pero la aplicación y posiblemente el servicio del modelo sí podrían recibirlos. El efecto potencial sería exponer información del cliente que no hacía falta para responder. La pregunta de control no es solo «¿hay contraseña?», sino «¿puede la conexión devolver exclusivamente los campos necesarios para esta consulta?».
En la fuente documental aparece otro tipo de riesgo: una política de devoluciones manipulada o desactualizada. Y existe una variante propia de los asistentes que leen texto externo: la inyección indirecta de instrucciones. Un documento consultado para obtener hechos podría incluir texto que intenta ordenar al asistente revelar datos o ignorar sus límites. El documento es contenido que se debe analizar, no una autoridad que pueda cambiar las reglas de la aplicación.
inteligencia artificial agéntica
Vuelve a las orientaciones de la Agencia Española de Protección de Datos para reconocer dónde puede entrar una instrucción maliciosa: no siempre llega como petición directa de la persona usuaria.
En el capítulo VI, «Amenazas», apartado B, «Procedentes de tratamientos no autorizados», busca «Inyección de prompts», pp. 52–53. Lee la modalidad indirecta. A continuación, bajo «Envenenamiento de memoria y RAG», lee el riesgo documental. Concéntrate en la frontera entre datos recuperados e instrucciones que gobiernan el asistente; no necesitas estudiar las demás modalidades de ataque para este caso.
Nuestro asistente no tramita reembolsos ni envía respuestas automáticamente, lo que limita el daño de algunas manipulaciones. Aun así, una instrucción maliciosa en un documento podría contaminar el borrador o intentar obtener información mediante una consulta innecesaria. La revisión humana ayuda, pero no sustituye controles sobre las fuentes, los permisos de las integraciones y lo que puede salir hacia otros servicios.
No confundas consulta, almacenamiento y entrenamiento
Al completar el mapa, separa tres cuestiones que suelen mezclarse en conversaciones de despliegue:
- Datos de cada consulta: qué pregunta y contexto se envían al modelo para generar una respuesta.
- Datos conservados por los servicios: qué queda en historiales, registros, índices, copias o sistemas de soporte, y cuándo se elimina.
- Datos usados para desarrollar o ajustar un modelo: si se emplean datos personales con ese fin, aparece un recorrido adicional, distinto de atender una consulta.
El siguiente esquema de la CNIL trata específicamente la tercera cuestión. Muestra que, cuando el desarrollo de un modelo implica datos personales, no basta con quitar nombres para concluir que el modelo es anónimo: hay que evaluar, entre otros aspectos, si pueden recuperarse o identificarse datos personales a través de él.
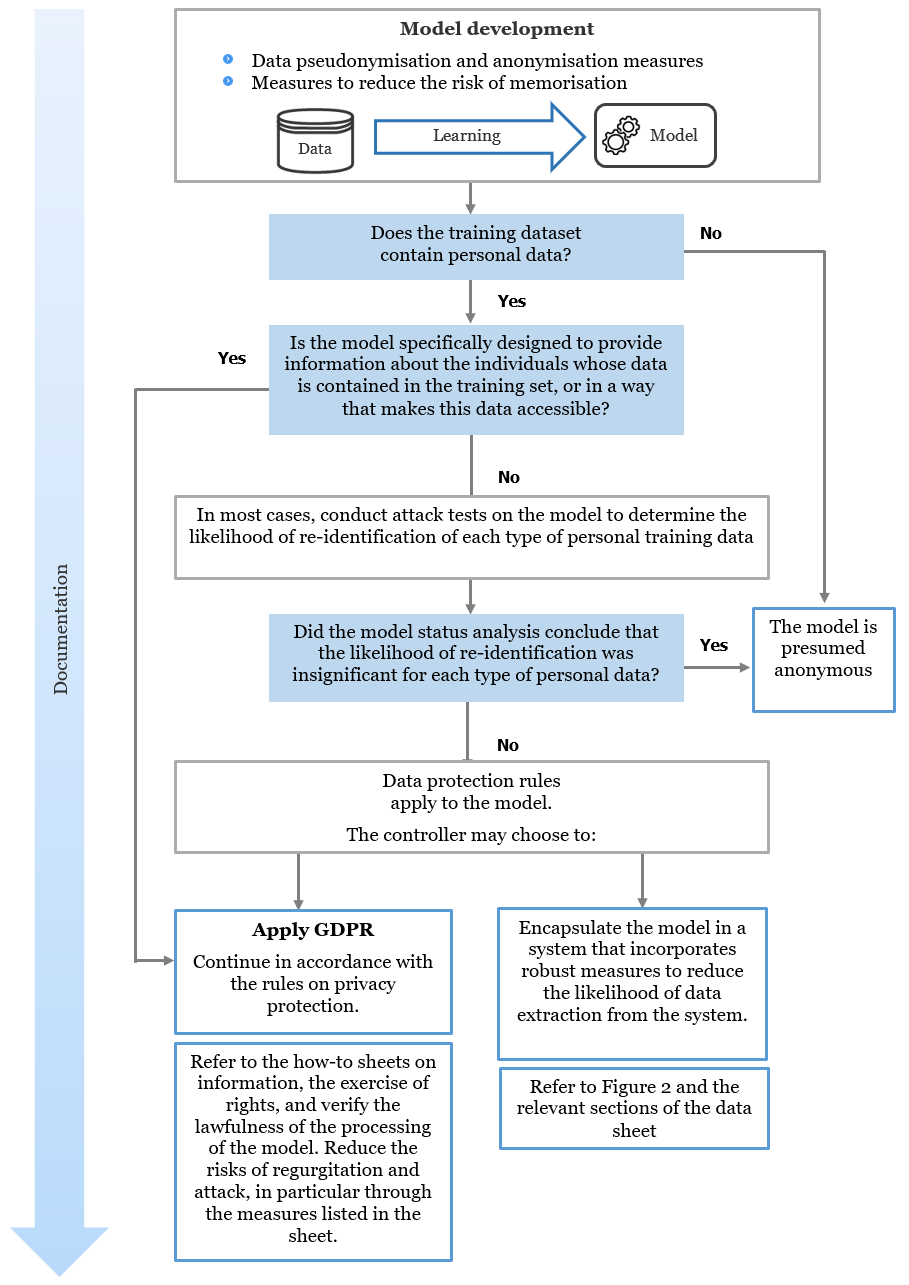
Para el piloto de devoluciones, este esquema no demuestra que el proveedor entrene con las consultas ni que no lo haga. Señala una pregunta separada que debes verificar. También recuerda que usar identificadores ficticios o sustituir un nombre no garantiza por sí solo la anonimización si aún es posible relacionar los datos con una persona.
Convierte el mapa en decisiones de despliegue
En tu función de adopción, el resultado útil no es una lista interminable de amenazas, sino un mapa con decisiones y cuestiones pendientes. Antes de incorporar datos reales al piloto, pide que queden claros estos puntos:
- Alcance y finalidad: qué tarea hará el asistente, qué datos personales necesita y qué operaciones quedan fuera; por ejemplo, consultar un estado sí, tramitar un reembolso no.
- Accesos y destinos: qué permisos tiene cada persona e integración, qué se envía al proveedor del modelo y qué otros proveedores o servicios pueden intervenir.
- Conservación: qué guardan historiales, índices y registros; quién accede a ellos y cómo se aplican los plazos y procesos de eliminación.
- Límites ante entradas no fiables: cómo se comprueban las fuentes documentales, cómo se impide que su texto conceda permisos y cuándo debe detenerse o escalarse una respuesta.
- Responsabilidad y evidencia: quién valida la configuración, quién atiende incidencias y qué información permite investigar un error sin registrar más datos de los necesarios.
Las respuestas pueden exigir decisiones del cliente y de sus equipos de tecnología, seguridad o protección de datos. Tu aportación es hacer visible el recorrido y señalar qué falta por confirmar, no declarar por cuenta propia que una solución cumple la normativa.
Cierre
Trazar datos consiste en seguirlos desde su origen hasta sus destinos finales e intermedios, anotando accesos, transformaciones, copias y conservación. Sobre ese mapa puedes localizar riesgos de privacidad, seguridad y uso indebido, y vincular cada riesgo con una pregunta o un control verificable. Un piloto pequeño sigue necesitando este análisis: limitar usuarios no corrige una integración con permisos excesivos ni un registro que conserva información innecesaria.
En la próxima lección observarás una petición y una respuesta sencillas de una API mediante HTTP y JSON. Eso te permitirá reconocer con más precisión qué campos viajan por una de las conexiones que hoy has identificado.