Bonjour !
Au cours des leçons précédentes, nous avons exploré les trois grands domaines de l'apprentissage non supervisé : le clustering, la détection d'anomalies et, plus récemment, la réduction de dimensionnalité avec l'ACP. Vous avez vu comment ces techniques peuvent extraire des informations précieuses des données financières, par exemple en identifiant les facteurs qui animent la courbe des taux. Ces exemples mentionnaient des outils comme Python et scikit-learn, mais nous nous sommes concentrés sur le "quoi" et le "pourquoi" de ces méthodes.
Aujourd'hui, nous allons nous intéresser au "comment". Cette leçon charnière fait le pont entre la théorie du machine learning et sa mise en œuvre pratique. Notre objectif est d'expliquer le rôle de l'écosystème Python (par exemple, scikit-learn, pandas) pour la mise en œuvre de modèles de ML en finance. Comprendre ces outils est essentiel, non seulement pour appliquer ces modèles, mais aussi pour pouvoir enseigner à vos étudiants comment la finance moderne est construite.
1. Pourquoi Python ? L'Approche par Écosystème
Alors que vos travaux en économétrie s'appuient sur des logiciels spécialisés comme STATA ou Eviews, le monde du machine learning a largement adopté Python comme langage de prédilection. La raison principale n'est pas tant le langage lui-même que son écosystème : un vaste ensemble de bibliothèques (librairies) open-source, développées et maintenues par une communauté mondiale, qui fournissent des outils puissants et gratuits pour chaque étape d'un projet de data science.
Un projet de machine learning est un processus, un workflow, qui va de la collecte des données à la communication des résultats. Chaque bibliothèque de l'écosystème Python a sa spécialité, et elles sont conçues pour fonctionner ensemble de manière transparente.
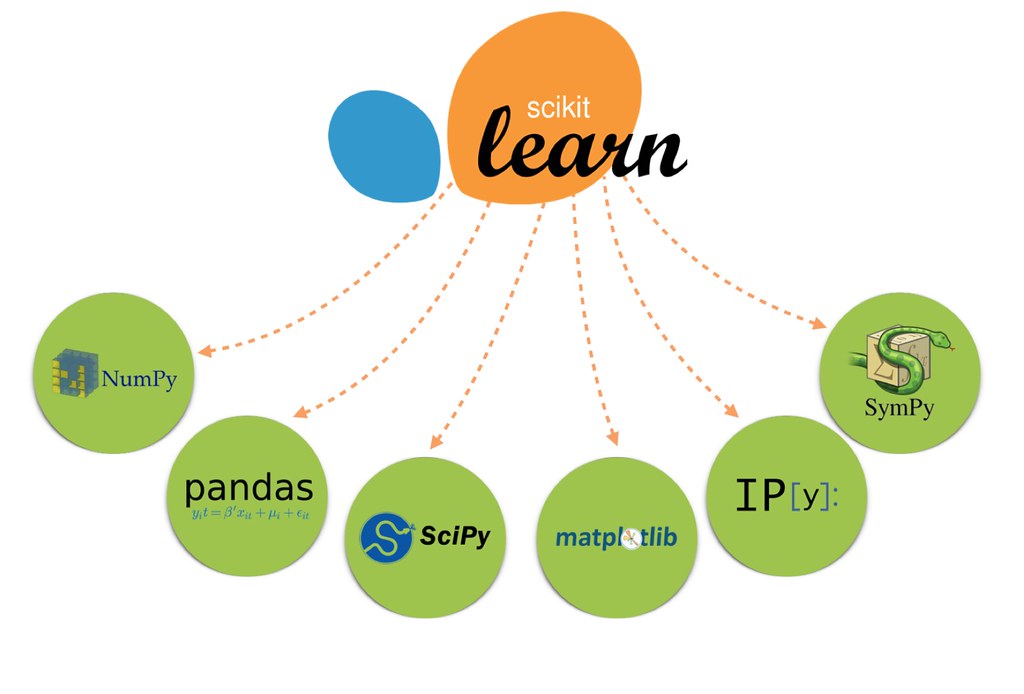
Les bibliothèques clés que vous devez connaître sont :
- NumPy (Numerical Python) : La fondation de tout calcul scientifique en Python. Elle fournit des structures de données ultra-rapides pour les calculs sur des vecteurs et des matrices, un concept central en algèbre linéaire et donc en machine learning.
- Pandas : Le couteau suisse de la manipulation de données. Son objet principal, le
DataFrame, est l'équivalent d'une feuille de calcul Excel ou d'un jeu de données dans STATA. Il est indispensable pour charger, nettoyer, transformer et explorer les données avant toute modélisation. - Scikit-learn : Le moteur du machine learning. C'est la bibliothèque qui implémente la grande majorité des algorithmes que nous avons vus (régression, classification, clustering, ACP, etc.) à travers une interface simple et cohérente.
- Matplotlib & Seaborn : Les bibliothèques de référence pour la visualisation de données, permettant de créer tous types de graphiques pour analyser les données et interpréter les résultats des modèles.
2. Scikit-learn : Le Moteur du Machine Learning
Au cœur de l'écosystème se trouve scikit-learn. C'est l'outil qui rend le machine learning accessible et efficace.
Pour avoir un aperçu de ce qu'est scikit-learn et de sa philosophie, je vous propose de regarder la vidéo suivante.
What Is Scikit-Learn | Introduction To Scikit-Learn | Machine Learning Tutorial | Intellipaat
Cette vidéo d'Intellipaat, "What Is Scikit-Learn", présente la bibliothèque comme un outil fondamental pour simplifier la mise en œuvre de modèles de machine learning complexes en Python.
Regardez les segments suivants : De 00:00 à 04:03 pour une introduction générale à scikit-learn et son rôle en tant que bibliothèque de base. De 04:03 à 05:05 qui souligne un point crucial : scikit-learn n'est pas utilisé seul mais en conjonction avec NumPy, Pandas et Matplotlib. De 08:58 à 11:49 qui récapitule les types de problèmes (classification, régression, clustering...) que nous avons déjà abordés et confirme qu'ils peuvent tous être résolus avec les algorithmes de scikit-learn.
Comme la vidéo le souligne, les grands atouts de scikit-learn sont :
- Cohérence de l'API : Tous les modèles partagent une interface similaire avec des méthodes comme
.fit()pour entraîner le modèle,.predict()pour faire des prédictions, et.transform()pour transformer les données (comme avec l'ACP). Cela permet de tester différents algorithmes très facilement. - Exhaustivité : La bibliothèque couvre un spectre très large de tâches, du prétraitement des données à l'évaluation des modèles.
- Documentation et Communauté : Étant la norme de l'industrie, la documentation est excellente et il est facile de trouver de l'aide et des exemples en ligne.
- Fondations Solides : Elle est construite sur NumPy et SciPy, ce qui garantit des performances de calcul élevées.
3. Pandas : La Préparation des Données
Un modèle de machine learning n'est bon que si les données qui l'alimentent le sont. Or, les données financières du monde réel sont rarement parfaites : elles peuvent contenir des valeurs manquantes, des formats incohérents ou nécessiter la création de nouvelles variables (le feature engineering). C'est là qu'intervient Pandas.
Compte tenu de votre expérience avec les logiciels statistiques, vous pouvez voir le DataFrame de Pandas comme une version beaucoup plus puissante et flexible des jeux de données que vous manipulez dans STATA ou SPSS. Il permet de :
- Charger des données depuis une multitude de sources (fichiers CSV, Excel, bases de données, API web...).
- Nettoyer et restructurer les données.
- Gérer les séries temporelles, ce qui est fondamental en finance.
- Calculer des statistiques descriptives et effectuer une analyse exploratoire des données.
La vidéo suivante explique pourquoi la maîtrise de Pandas est souvent un prérequis pour faire du machine learning efficace.
Should I learn pandas before scikit-learn?
Dans cette vidéo de Data School, l'auteur répond à la question "Should I learn pandas before scikit-learn?" et explique le lien symbiotique entre la préparation des données et la modélisation.
Regardez de 03:38 à 06:02. Concentrez-vous sur l'idée que l'analyse et la préparation des données avec Pandas sont des aspects clés du workflow de machine learning, car une bonne compréhension des données permet de construire de meilleurs modèles.
En résumé, le workflow typique est : Pandas pour préparer les données, Scikit-learn pour construire le modèle.
4. Un Cas d'Usage Réel : La Finance Quantitative chez Union Investment
Pour que ces concepts ne restent pas abstraits, voyons comment cet écosystème est utilisé concrètement dans l'industrie financière. Le témoignage de Union Investment, un grand gestionnaire d'actifs allemand, est particulièrement éclairant.
Python for Financial Machine Learning at Union Investment
Cet article du site officiel de Python, intitulé "Python for Financial Machine Learning at Union Investment", détaille comment l'entreprise a construit sa propre plateforme de machine learning pour la gestion d'actifs.
Lisez l'article en vous concentrant sur les sections "Machine Learning with Python" et "Python’s Outstanding Ecosystem". Notez que leur plateforme propriétaire (MALINA) est entièrement développée en Python et qu'ils citent explicitement les bibliothèques que nous venons de discuter : scikit-learn, pandas, NumPy, SciPy, Matplotlib. Leur justification pour avoir choisi cet écosystème (open source, documentation, flexibilité) est un argumentaire puissant que vous pourrez réutiliser.
Ce cas d'étude démontre que l'écosystème Python n'est pas seulement un outil académique, mais le standard industriel pour développer des solutions de machine learning sur mesure, capables de relever les défis complexes posés par les séries temporelles financières.
Testez votre compréhension !
Une équipe de gestion du risque souhaite développer un modèle pour prédire les défauts de paiement sur des crédits à la consommation. Elle dispose d'un fichier CSV contenant des informations sur des milliers de clients (âge, revenu, montant du prêt, historique de paiement, etc.).
Décrivez le rôle que joueraient Pandas, Scikit-learn et Matplotlib dans ce projet.
Voir la réponse
-
Pandas : Serait utilisé en premier lieu pour charger le fichier CSV dans un
DataFrame. L'équipe l'utiliserait ensuite pour explorer les données (calculer des moyennes, des corrélations), nettoyer le jeu de données (par exemple, en traitant les valeurs manquantes pour le revenu) et créer de nouvelles caractéristiques (comme un ratio dette/revenu). -
Scikit-learn : Une fois les données prêtes, l'équipe utiliserait
scikit-learnpour mettre en œuvre le modèle de prédiction. Elle pourrait commencer par une régression logistique, puis essayer un modèle plus complexe comme une forêt aléatoire (Random Forest).Scikit-learnserait utilisé pour diviser les données en ensembles d'entraînement et de test, entraîner le modèle avec la méthode.fit(), et évaluer sa performance (par exemple, en calculant l'accuracy ou en générant une matrice de confusion). -
Matplotlib (ou Seaborn) : Serait utilisé tout au long du projet. Au début, pour visualiser la distribution des variables (histogrammes de l'âge, du revenu). Pendant l'analyse, pour visualiser les relations entre les variables (scatter plots). Et à la fin, pour présenter les résultats du modèle, par exemple en traçant la courbe ROC pour évaluer la performance du classifieur.
5. Au-delà du Noyau : Des Bibliothèques Spécialisées pour la Finance
L'écosystème est en constante évolution, avec des bibliothèques plus spécialisées qui se construisent sur ce noyau. Un exemple particulièrement pertinent pour vous est gingado, une bibliothèque développée par un économiste de la Banque des Règlements Internationaux (BRI).
gingado: a machine learning library focused on economics ...
Ce document de travail de la BRI, "gingado: a machine learning library focused on economics ...", présente un outil conçu pour faciliter l'usage du ML en économie et en finance, en s'intégrant parfaitement à scikit-learn.
L'article est dense, mais l'idée est de saisir la philosophie. Parcourez la section 1 (Introduction) pour comprendre les objectifs de la bibliothèque. Ensuite, lisez la section 2.1 et examinez le code de l'encadré "Listing 2". Il montre comment gingado peut s'insérer dans un "pipeline" scikit-learn pour enrichir automatiquement un jeu de données avec des séries économiques provenant de sources officielles comme la BCE ou la BRI. Enfin, lisez la section 7 (Conclusion) qui résume bien comment de tels outils complètent scikit-learn pour les cas d'usage des économistes.
Gingado illustre un point clé : la flexibilité de l'écosystème Python permet à des experts de domaine, comme les économistes, de construire des outils sur mesure qui répondent à leurs besoins spécifiques (par exemple, l'accès à des données macroéconomiques, la documentation de modèles) tout en restant compatibles avec le framework standard.
Il existe également des bibliothèques comme TensorFlow et PyTorch, dédiées au deep learning (réseaux de neurones profonds), utilisées pour des tâches encore plus complexes comme l'analyse de sentiment à partir de textes financiers ou la reconnaissance de motifs dans des données de marché à très haute fréquence.
Conclusion
Dans cette leçon, nous avons dressé le panorama des outils qui permettent de passer de la théorie du machine learning à la pratique. Vous avez maintenant une carte de l'écosystème Python pour la data science et la finance.
Points clés à retenir :
- Le machine learning en finance repose sur un écosystème de bibliothèques Python open-source, qui fonctionnent en synergie.
- Le workflow typique implique Pandas pour la préparation et l'exploration des données, Scikit-learn pour l'entraînement et l'évaluation des modèles, et Matplotlib/Seaborn pour la visualisation.
- Scikit-learn est le moteur de cet écosystème, offrant une interface unifiée et simple pour une vaste gamme d'algorithmes de ML.
- Cet ensemble d'outils est le standard de l'industrie, utilisé par les institutions financières pour développer des solutions de modélisation sophistiquées.
- L'écosystème est extensible, avec des bibliothèques spécialisées comme
gingadopour l'économie et la finance, ouTensorFlowpour le deep learning.
Nous avons maintenant couvert les concepts du machine learning et les outils pour les mettre en œuvre. Nous sommes prêts à aborder des applications plus avancées.
Dans la prochaine leçon, nous entamerons le module sur le trading algorithmique. Nous verrons comment ces modèles et ces outils sont concrètement utilisés pour concevoir, tester et déployer des stratégies de trading automatisées.