Bonjour !
Dans notre dernière leçon, nous avons exploré comment les algorithmes de clustering, comme K-means, nous permettent de découvrir des groupes homogènes au sein de nos données, une technique puissante pour la segmentation de la clientèle. Nous avons appris à identifier des "personas" de clients en nous basant sur leurs comportements.
Aujourd'hui, nous allons aborder un autre objectif majeur de l'apprentissage non supervisé, qui est en quelque sorte le miroir du clustering. Au lieu de chercher ce qui rassemble les points de données, nous allons apprendre à identifier les individus qui ne ressemblent à aucun groupe : les anomalies. Notre objectif est d'expliquer comment les techniques de détection d'anomalies peuvent être utilisées pour identifier les transactions frauduleuses. C'est une application d'une importance capitale dans le secteur financier moderne.
1. Le Défi : Les Limites de la Détection de Fraude Traditionnelle
Historiquement, les banques et les institutions financières ont lutté contre la fraude en utilisant des systèmes basés sur des règles prédéfinies. Ces règles sont souvent simples et directes, par exemple :
- "Signaler toute transaction supérieure à 10 000 €."
- "Bloquer une carte si elle est utilisée dans deux pays différents en moins d'une heure."
- "Alerter si un retrait est effectué entre 2h et 4h du matin."
Bien qu'utiles, ces systèmes ont des limites importantes, surtout face à des fraudeurs de plus en plus sophistiqués.
Pour comprendre ces limites, je vous propose la lecture suivante qui expose bien le problème.
Cybersecurity threats in banking: Unsupervised fraud ...
Cet article, intitulé "Cybersecurity threats in banking", bien que technique, commence par une excellente introduction sur les faiblesses des approches traditionnelles basées sur des règles et positionne l'apprentissage non supervisé comme une solution plus dynamique et efficace.
Lisez le premier chapitre (Introduction). Concentrez-vous sur la section où les auteurs expliquent pourquoi les "traditional rule-based fraud detection techniques" ont des lacunes ("shortcomings") et comment l'apprentissage non supervisé ("unsupervised learning") offre une alternative prometteuse car il fonctionne sur des données non étiquetées pour trouver des schémas et des anomalies.
Comme vous l'avez lu, les principaux problèmes des systèmes à base de règles sont :
- Statiques : Ils ne s'adaptent pas aux nouvelles stratégies de fraude.
- Facilement contournables : Les fraudeurs peuvent apprendre les règles et effectuer des opérations qui restent "sous le radar" (par exemple, de multiples petites transactions au lieu d'une seule grosse).
- Génèrent des faux positifs : Une règle trop stricte peut bloquer des transactions légitimes, frustrant les clients.
- Incapacité à détecter la nouveauté : Ils ne peuvent pas identifier des types de fraude jamais vus auparavant.
2. Une Nouvelle Approche : La Détection d'Anomalies
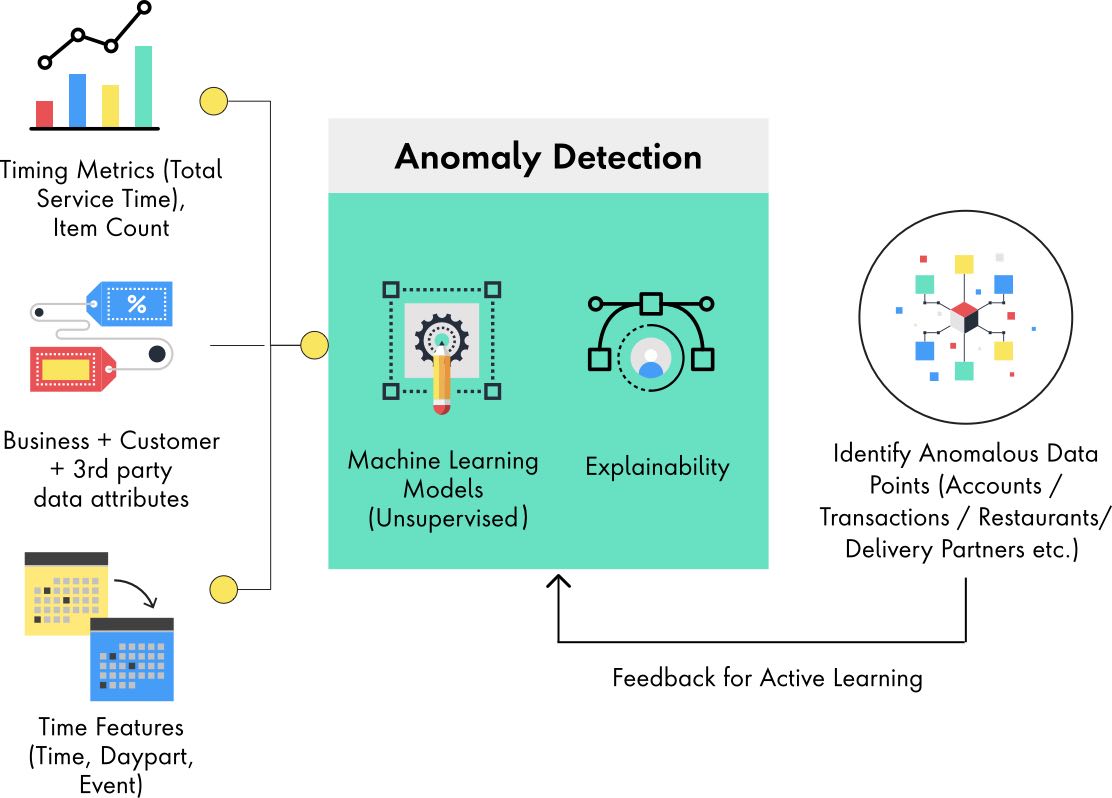
Face à ces défis, le machine learning propose une approche différente. Au lieu de définir explicitement à quoi ressemble une fraude, nous allons apprendre à quoi ressemble une transaction normale. Toute transaction qui s'écarte de manière significative de cette "normalité" sera alors considérée comme une anomalie potentielle et signalée pour une enquête plus approfondie.
C'est le principe fondamental de la détection d'anomalies en apprentissage non supervisé. On part de deux hypothèses simples sur les fraudes :
- Elles sont rares : La grande majorité des transactions sont légitimes.
- Elles sont différentes : Les caractéristiques d'une transaction frauduleuse (montant, heure, lieu, etc.) diffèrent de celles des transactions normales.
La vidéo suivante introduit parfaitement ce concept.
Unit8 Talks #7 - Fraud detection - A guide to building a financial transaction anomaly detector
Cette vidéo de la chaîne Unit8, intitulée "Fraud detection - A guide to building a financial transaction anomaly detector", présente un projet complet de détection de fraude. La première partie définit clairement le problème et le concept de détection d'anomalies.
Regardez de 02:30 à 04:51. Concentrez-vous sur la définition d'une transaction frauduleuse et comment la détection d'anomalies est présentée comme le processus de recherche d'"outliers" – des points de données qui diffèrent de la majorité.
3. Une Technique Clé : L'Isolation Forest (Forêt d'Isolement)
Il existe plusieurs algorithmes pour la détection d'anomalies. L'un des plus efficaces et intuitifs est l'Isolation Forest.
L'idée centrale est simple et élégante : les anomalies sont plus faciles à isoler que les points normaux.
Imaginez que vous avez un nuage de points de données. Les points normaux sont regroupés au sein de la "foule". Les anomalies, par définition, sont à l'écart. Si vous commencez à tracer des lignes de séparation aléatoires pour diviser l'espace, vous allez "isoler" un point aberrant en très peu de séparations. En revanche, il faudra beaucoup plus de séparations pour isoler un point normal qui est blotti au cœur de la distribution.
L'algorithme Isolation Forest automatise ce processus :
- Il construit un grand nombre d'arbres de décision aléatoires. Dans chaque arbre, les données sont partitionnées de manière récursive en choisissant une caractéristique et une valeur de seuil au hasard.
- Pour chaque point de données, on mesure le nombre moyen de séparations (la profondeur moyenne dans les arbres) nécessaires pour l'isoler.
- Les points qui ont une profondeur moyenne faible sont considérés comme des anomalies.
Les deux vidéos suivantes expliquent ce mécanisme de manière très complémentaire.
Complete Anomaly Detection Tutorials Machine Learning And Its Types With Implementation | Krish Naik
Cette première vidéo de Krish Naik explique l'intuition de l'Isolation Forest, y compris sa base mathématique simple, ce qui devrait bien correspondre à votre bagage quantitatif.
Regardez de 03:42 à 11:25. Concentrez-vous sur le concept clé : les anomalies sont isolées plus rapidement (avec moins de "splits" ou de profondeur d'arbre). Ne vous attardez pas sur la formule exacte, mais comprenez le principe de l'"anomaly score" qui en découle.
Unit8 Talks #7 - Fraud detection - A guide to building a financial transaction anomaly detector
La vidéo de Unit8 que nous avons déjà vue offre une démonstration visuelle et simplifiée de ce processus d'isolement, ce qui rend le concept très concret.
Regardez de 18:11 à 25:35. Observez attentivement la différence entre le nombre de décisions nécessaires pour isoler le point A (une anomalie) et le point B (un point normal). C'est l'illustration parfaite de l'idée fondamentale de l'algorithme.
Bien que l'Isolation Forest soit une technique de premier plan, il en existe d'autres, comme DBScan (que nous avons brièvement évoqué pour le clustering et qui identifie les points n'appartenant à aucun cluster comme du "bruit" ou des anomalies) et le Local Outlier Factor (LOF), qui détecte les anomalies en comparant la densité locale d'un point à celle de ses voisins.
4. L'Anomaly Score et la Prise de Décision
Un point crucial est que l'algorithme ne renvoie pas une simple étiquette "fraude" / "non fraude". Il calcule pour chaque transaction un score d'anomalie (souvent basé sur la profondeur d'isolement moyenne). Ce score est une valeur continue qui représente à quel point une transaction est "suspecte" selon le modèle.
Cela offre une grande flexibilité. Au lieu d'une décision binaire, nous avons un classement de toutes les transactions, des plus anormales aux plus normales. C'est ensuite à l'institution financière de fixer un seuil de décision.
- Toutes les transactions avec un score d'anomalie supérieur au seuil seront envoyées à une équipe d'analystes pour vérification.
Le choix de ce seuil est un arbitrage métier fondamental, connu en machine learning comme le compromis précision/rappel (precision/recall trade-off).
- Seuil bas : On attrape beaucoup de fraudes (rappel élevé) mais aussi beaucoup de transactions légitimes (précision faible), ce qui peut submerger les analystes.
- Seuil élevé : On est plus sûr que les transactions signalées sont bien des fraudes (précision élevée), mais on risque de manquer des cas de fraude moins évidents (rappel faible).
La vidéo de Unit8 explique très bien ce concept de score continu et de seuil flexible.
Unit8 Talks #7 - Fraud detection - A guide to building a financial transaction anomaly detector
Retournons à la vidéo de Unit8 pour voir comment ce score d'anomalie est utilisé en pratique.
Regardez le segment de 08:30 à 11:16. Portez une attention particulière à la visualisation de la distribution des scores d'anomalie et à la manière dont le réglage du seuil permet de "jeter un filet plus ou moins large".
5. Évaluation et Interprétabilité du Modèle
Comment savoir si notre modèle est performant, indépendamment du seuil choisi ? Et comment faire confiance à un modèle qui peut sembler être une "boîte noire" ?
a) Évaluation avec la Courbe ROC
Pour évaluer la performance globale d'un modèle de ce type, on utilise la courbe ROC (Receiver Operating Characteristic). Cette courbe, qui vous est peut-être familière de vos études en statistiques, représente le taux de vrais positifs (Rappel) en fonction du taux de faux positifs pour tous les seuils de décision possibles.
L'aire sous la courbe (AUC - Area Under the Curve) résume cette performance en un seul chiffre :
- AUC = 1 : Modèle parfait.
- AUC = 0.5 : Modèle inutile (équivalent à une supposition aléatoire).
- Plus l'AUC est proche de 1, meilleur est le modèle pour distinguer les transactions frauduleuses des transactions normales.
Unit8 Talks #7 - Fraud detection - A guide to building a financial transaction anomaly detector
La vidéo de Unit8 montre une application concrète de l'évaluation par courbe ROC.
Regardez la section de 29:10 à 34:35. Observez le graphique ROC et comment le score AUC de l'Isolation Forest est comparé à celui d'un modèle naïf (basé uniquement sur le montant) et à une estimation aléatoire.
b) Expliquer les Décisions avec SHAP
Dans le domaine financier, un modèle ne peut pas être une boîte noire. Un analyste ou un auditeur doit comprendre pourquoi une transaction a été signalée. C'est le domaine de l'IA explicable (XAI - Explainable AI).
Une des techniques les plus puissantes est SHAP (SHapley Additive exPlanations). Inspirée de la théorie des jeux, SHAP calcule pour chaque transaction signalée la contribution de chaque caractéristique (montant, heure, solde avant transaction, etc.) à son score d'anomalie.
Par exemple, SHAP peut nous dire : "Cette transaction a un score d'anomalie élevé principalement parce que le solde du compte d'origine était à zéro et que le montant était inhabituellement élevé, même si l'heure de la transaction était normale."
Unit8 Talks #7 - Fraud detection - A guide to building a financial transaction anomaly detector
L'explication de SHAP est l'un des points forts de la présentation de Unit8. Elle est essentielle pour comprendre comment rendre ces modèles transparents et utiles en pratique.
Regardez très attentivement la section de 34:18 à 44:25. C'est la partie la plus dense, mais la plus importante pour l'application pratique. Concentrez-vous sur la manière dont les graphiques SHAP (avec les flèches rouges et bleues) décomposent la décision du modèle pour une transaction spécifique et comment l'agrégation de ces explications permet de comprendre le comportement global du modèle.
Testez votre compréhension !
Un modèle de détection de fraude basé sur Isolation Forest signale une transaction. En utilisant SHAP, vous voyez que la principale raison est que la transaction a eu lieu un dimanche à 3h du matin, une caractéristique qui a fortement contribué à augmenter le score d'anomalie. Cependant, le montant était faible et le destinataire était un bénéficiaire fréquent pour ce client.
En tant qu'analyste, comment cette explication vous aide-t-elle à prendre une décision ?
Voir la réponse
L'explication de SHAP vous permet d'aller au-delà de la simple alerte "anomalie détectée".
- Comprendre le raisonnement du modèle : Vous savez que le modèle a été déclenché par l'horaire inhabituel. C'est un facteur de risque légitime.
- Contextualiser l'alerte : Cependant, vous voyez aussi des facteurs qui suggèrent que la transaction pourrait être normale (faible montant, bénéficiaire connu). Le modèle a également pris cela en compte (ces caractéristiques ont probablement poussé le score vers la "normalité", mais pas assez pour compenser l'horaire).
- Prendre une décision éclairée : Au lieu de rejeter aveuglément la transaction, vous pourriez décider qu'il s'agit d'un faux positif probable. Par exemple, le client fait peut-être un petit achat en ligne tard le week-end. L'explication vous donne les éléments pour juger de la pertinence de l'alerte et éviter de déranger inutilement un client. Cela rend le système beaucoup plus intelligent et efficace.
Conclusion
Aujourd'hui, nous avons vu comment la détection d'anomalies offre une solution puissante et flexible pour identifier les fraudes financières, dépassant les limites des systèmes traditionnels basés sur des règles.
Points clés à retenir :
- La détection d'anomalies en mode non supervisé consiste à modéliser le comportement normal pour identifier ce qui est anormal, sans avoir besoin d'exemples de fraude étiquetés.
- L'algorithme Isolation Forest est une technique efficace qui repose sur l'idée que les anomalies sont plus faciles à isoler que les points de données normaux.
- Les modèles produisent un score d'anomalie continu, ce qui permet de classer les transactions par ordre de suspicion et de fixer un seuil de décision en fonction des objectifs métier (compromis précision/rappel).
- La performance globale du modèle est évaluée à l'aide d'outils comme la courbe ROC et l'AUC.
- L'IA explicable (XAI), via des outils comme SHAP, est indispensable pour rendre les décisions du modèle transparentes, permettre une analyse humaine efficace et renforcer la confiance dans le système.
Dans nos leçons sur l'apprentissage non supervisé, nous avons appris à trouver des groupes (clustering) et des exceptions (détection d'anomalies). Ces techniques fonctionnent sur les caractéristiques que nous leur donnons. Mais que se passe-t-il lorsque nous avons des centaines, voire des milliers de caractéristiques ? L'analyse devient complexe et coûteuse. Notre prochaine leçon portera sur la réduction de dimensionnalité, et nous verrons comment des techniques comme l'ACP (Analyse en Composantes Principales) peuvent nous aider à simplifier des ensembles de données financiers complexes tout en préservant l'information essentielle.