Bonjour et bienvenue dans cette nouvelle leçon sur les fondements du Big Data en finance.
Introduction
Dans la leçon précédente, nous avons cartographié le vaste territoire des sources de données en finance, en distinguant les données internes et externes, ainsi que les données traditionnelles et alternatives. Nous savons maintenant quelle est la "matière première" de l'analyse financière moderne.
Aujourd'hui, nous allons explorer la "chaîne de production" qui transforme cette matière première en informations de valeur. L'objectif de cette leçon est de décrire l'architecture de base d'un système Big Data, c'est-à-dire l'ensemble des composants technologiques qui permettent de stocker, traiter et analyser ces données massives.
Comprendre cette architecture est essentiel car elle forme l'ossature de toutes les applications Big Data, de la détection de fraude en temps réel à la gestion de portefeuille algorithmique. Nous aborderons ce sujet en décomposant un système Big Data en une série de couches logiques, chacune ayant une fonction spécifique : le stockage, le traitement et l'analyse.
Une architecture en couches
Un système Big Data n'est pas une application monolithique, mais un assemblage de plusieurs composants spécialisés qui communiquent entre eux. On représente souvent cette structure sous la forme d'une architecture en couches, où les données circulent de la couche la plus basse (la collecte) vers la plus haute (l'application).

Ce modèle en couches est une façon structurée de penser la conception de ces systèmes. Nous allons adopter un modèle en cinq couches, qui est devenu une référence dans le domaine. Pour une vue d'ensemble de ce modèle, je vous invite à regarder une courte vidéo qui présente ces différentes couches.
Introduction to Big Data Architecture
La vidéo "Introduction to Big Data Architecture" de la chaîne Software Architecture Academy présente de manière claire et concise les différentes couches fonctionnelles d'un système Big Data.
Regardez la vidéo du début jusqu'à 6:33. Concentrez-vous sur l'identification des différentes couches (ingestion, stockage, analyse, consommation) et les exemples de composants au sein de chaque couche.
La vidéo, ainsi que la littérature académique, nous amènent à un modèle standard que nous allons détailler. Les cinq couches fonctionnelles sont :
- La couche de Collecte (ou Ingestion)
- La couche de Stockage
- La couche de Traitement
- La couche d'Analyse
- La couche d'Application (ou Consommation)
Examinons maintenant chaque couche en détail.
Couche 1 : La Collecte (Ingestion)
Cette couche est le point d'entrée du système. Sa fonction est de recueillir les données brutes issues des multiples sources que nous avons identifiées dans la leçon précédente (transactions, données de marché, réseaux sociaux, etc.).
Les principaux défis à ce niveau sont la variété (données structurées, non structurées) et la vélocité (flux en temps réel vs. chargements par lots).
- Traitement par lots (Batch) : Pour les données qui n'ont pas besoin d'être traitées instantanément. Par exemple, charger l'historique des transactions de la veille. Des outils comme Sqoop sont utilisés pour importer des données depuis des bases de données traditionnelles.
- Traitement en flux (Streaming) : Pour les données qui doivent être traitées en quasi-temps réel. Par exemple, les cours boursiers tick-by-tick ou les transactions par carte bancaire pour la détection de fraude. Des outils comme Flume ou Kafka, et des services cloud comme Amazon Kinesis, sont conçus pour gérer ces flux continus.
Couche 2 : Le Stockage
Une fois collectées, les données doivent être stockées de manière fiable et accessible. C'est le rôle de la couche de stockage, qui s'appuie souvent sur le concept de lac de données (data lake) que nous avons vu précédemment.
La technologie fondamentale ici est le système de fichiers distribués.
Le système de fichiers distribués Hadoop (HDFS)
Le framework open-source Hadoop a été pionnier dans le domaine du Big Data. Son composant de stockage, HDFS (Hadoop Distributed File System), repose sur une idée simple mais puissante : plutôt que d'utiliser un unique et coûteux super-ordinateur, on distribue les données sur un cluster de nombreuses machines standards et peu coûteuses.
Pour comprendre les bases de HDFS et de son corollaire pour le traitement, MapReduce, je vous suggère de lire les diapositives suivantes.
Mise en œuvre des systèmes big data
Ce document de cours, intitulé "Mise en œuvre des systèmes big data" par Ahmed Hamdi, explique de manière très pédagogique les deux piliers de l'écosystème Hadoop : le stockage avec HDFS et le traitement avec MapReduce.
Veuillez lire les diapositives 16 à 24. Concentrez-vous sur le principe de HDFS (division des fichiers en blocs, réplication) et l'architecture maître-esclave avec le NameNode et les DataNodes.
Pour résumer, HDFS :
- Découpe les fichiers volumineux en blocs de grande taille (ex: 128 Mo).
- Distribue ces blocs sur différentes machines du cluster (les DataNodes).
- Réplique chaque bloc (par défaut, 3 fois) sur différentes machines pour garantir la tolérance aux pannes. Si une machine tombe en panne, les données ne sont pas perdues.
- Utilise un nœud maître (le NameNode) qui conserve les métadonnées, c'est-à-dire le "plan" indiquant où chaque bloc de chaque fichier est stocké.
Stockage Objet dans le Cloud
Aujourd'hui, une alternative très populaire à HDFS est le stockage objet, dont Amazon S3 (Simple Storage Service) est l'exemple le plus connu. Il fonctionne sur un principe similaire de distribution et de redondance, mais il offre une plus grande flexibilité en découplant le stockage du calcul. Cela signifie que vous pouvez stocker vos données sur S3 et utiliser différents types de clusters de calcul pour les analyser, sans que les deux soient physiquement liés. Nous explorerons cela plus en détail dans la prochaine leçon sur le cloud.
Couche 3 : Le Traitement
Les données brutes stockées dans le data lake sont rarement utilisables telles quelles. La couche de traitement est responsable de les nettoyer, les transformer, les enrichir et les structurer pour l'analyse. C'est l'équivalent à grande échelle de l'étape de préparation des données que vous connaissez bien en économétrie. On parle souvent de processus ETL (Extract, Transform, Load).
MapReduce : Le modèle de traitement parallèle fondateur
Le composant de traitement originel de Hadoop est MapReduce. C'est un modèle de programmation qui permet de traiter d'énormes volumes de données en parallèle sur le cluster.
Reprenons le document de cours précédent pour comprendre son fonctionnement à travers un exemple simple.
Mise en œuvre des systèmes big data
L'exemple du calcul des ventes par magasin dans le document "Mise en œuvre des systèmes big data" est une excellente analogie pour comprendre le fonctionnement de MapReduce.
Lisez les diapositives 25 à 33. L'objectif est de saisir la logique des deux phases : la phase Map (où les données sont traitées en parallèle pour extraire des paires clé-valeur) et la phase Reduce (où les résultats intermédiaires sont agrégés).
En résumé, MapReduce fonctionne en deux temps :
- Phase Map : Le système distribue des "mappers" sur les nœuds du cluster. Chaque mapper travaille en parallèle sur un bloc de données local. Sa tâche est de lire les données et d'émettre des paires
(clé, valeur). Dans l'exemple, la clé est la ville et la valeur est le montant de la vente. - Phase Reduce : Le système regroupe toutes les paires ayant la même clé et les envoie à un "reducer". Le reducer agrège les valeurs pour chaque clé. Dans l'exemple, il fait la somme de toutes les ventes pour une même ville.
Ce paradigme "diviser pour régner" permet de paralléliser massivement des calculs qui seraient extrêmement longs à exécuter sur une seule machine.
Apache Spark : Le moteur de traitement moderne
MapReduce, bien que révolutionnaire, a des limites, notamment sa relative lenteur due à d'intensives lectures/écritures sur disque. Son successeur est Apache Spark.
Spark est un moteur de traitement unifié, beaucoup plus rapide car il effectue la majorité des calculs en mémoire vive. Il est également plus flexible et fournit des interfaces de programmation plus simples. Aujourd'hui, Spark est considéré comme le standard de facto pour le traitement de données à grande échelle.
Couche 4 : L'Analyse
C'est ici que la valeur est extraite des données préparées. Cette couche fournit les outils pour explorer les données, exécuter des requêtes complexes, et surtout, construire des modèles statistiques et de Machine Learning. Pour vous, c'est la couche qui se rapproche le plus de votre cœur de métier, mais avec des outils adaptés à la volumétrie.
Les outils d'analyse peuvent être regroupés en plusieurs catégories :
- Requêtage SQL interactif : Des outils comme Hive, Presto ou Amazon Athena permettent aux analystes d'utiliser le langage SQL, qu'ils connaissent bien, pour interroger directement les données stockées dans le data lake.
- Analyse en streaming : Des modules comme Spark Streaming ou Kinesis Data Analytics permettent d'appliquer des analyses (ex: calcul de moyennes mobiles, détection d'anomalies) sur les données en temps réel.
- Machine Learning : Des bibliothèques comme Spark MLlib fournissent des implémentations distribuées d'algorithmes de classification, régression, clustering, etc. Cela permet d'entraîner des modèles sur des téraoctets de données.
Couche 5 : L'Application et la Visualisation
La couche finale rend les résultats de l'analyse accessibles et exploitables. Cela peut prendre plusieurs formes :
- Tableaux de bord (Dashboards) : Des outils de Business Intelligence comme Tableau, Power BI ou Amazon QuickSight permettent de créer des visualisations interactives.
- API : Les résultats d'un modèle (ex: un score de crédit) peuvent être exposés via une API pour être consommés par d'autres applications.
- Alertes : Un système de détection de fraude peut déclencher une alerte en temps réel.
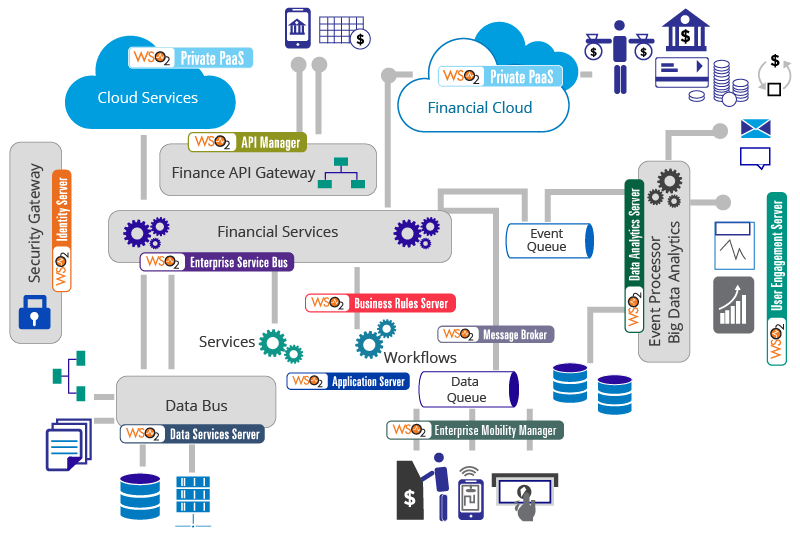
Le schéma ci-dessous, spécifique au secteur financier, illustre comment tous ces composants s'intègrent pour créer des services financiers "connectés".
Testez votre compréhension !
Imaginez qu'une banque souhaite développer un système pour détecter en temps réel les transactions frauduleuses par carte de crédit. Décrivez brièvement ce qui se passerait dans les couches Collecte, Stockage, Traitement et Analyse de l'architecture Big Data de la banque pour une seule transaction.
Voir la réponse
- Collecte : La transaction (montant, lieu, heure, etc.) est capturée au moment où elle se produit et envoyée via un flux de données en temps réel (par exemple, avec Kafka ou Kinesis) vers le système Big Data.
- Stockage : La transaction est immédiatement écrite dans le data lake (par exemple, sur Amazon S3) pour archivage et analyses futures (batch).
- Traitement : Simultanément, la transaction est traitée en mémoire. Le système peut l'enrichir avec des données contextuelles, comme l'historique des transactions récentes du client ou le profil de dépense moyen dans ce type de commerce (informations extraites de la couche de stockage). Apache Spark serait un outil adapté pour cette tâche.
- Analyse : La transaction enrichie est passée en entrée d'un modèle de Machine Learning (préalablement entraîné, par exemple avec Spark MLlib) qui lui assigne un score de probabilité de fraude en quelques millisecondes. Si le score dépasse un certain seuil, une alerte est déclenchée.
Conclusion
Aujourd'hui, nous avons disséqué l'anatomie d'un système Big Data. Vous disposez maintenant d'un schéma mental pour organiser les différentes technologies et comprendre leur rôle respectif.
Les points clés à retenir sont :
- Une architecture Big Data est structurée en couches logiques : Collecte, Stockage, Traitement, Analyse et Application.
- La couche de stockage repose sur des systèmes de fichiers distribués comme HDFS ou des stockages objet comme S3, qui permettent de stocker des volumes massifs de données de manière fiable et économique.
- La couche de traitement utilise des moteurs de calcul parallèle. Le modèle fondateur est MapReduce, mais le standard moderne est Apache Spark pour sa vitesse et sa flexibilité.
- La couche d'analyse met à disposition des outils pour explorer les données (SQL) et construire des modèles prédictifs (Machine Learning) à grande échelle.
Dans la prochaine leçon, nous conclurons ce module en nous concentrant sur un élément qui a rendu ces architectures beaucoup plus accessibles et puissantes : le cloud computing. Nous verrons pourquoi le cloud est devenu la plateforme de prédilection pour le Big Data et comment des services comme ceux d'Amazon Web Services (AWS), Microsoft Azure ou Google Cloud simplifient le déploiement de ces systèmes complexes.