Bonjour et bienvenue dans cette nouvelle leçon du module sur les fondements du Big Data pour la finance.
Introduction
Dans la leçon précédente, nous avons exploré la Variété des données, en différenciant les données structurées, semi-structurées et non structurées. Nous avons vu que si les données structurées sont le socle de l'analyse économétrique et statistique que vous maîtrisez, une grande partie de la valeur potentielle en finance réside aujourd'hui dans les données non structurées.
Cela soulève une question fondamentale : où et comment stocker cette diversité de données ? L'objectif de cette leçon est d'expliquer la différence entre un entrepôt de données (data warehouse) et un lac de données (data lake). Ces deux approches représentent des philosophies de stockage et de gestion des données radicalement différentes. Comprendre leur distinction est essentiel, car le choix de l'une ou l'autre a des implications profondes sur les types d'analyses possibles, les utilisateurs cibles et la flexibilité d'une institution financière face aux innovations.
L'approche traditionnelle : l'Entrepôt de Données (Data Warehouse)
Historiquement, les entreprises ont cherché à centraliser leurs données structurées pour l'analyse et le reporting. C'est le rôle de l'entrepôt de données. Il est important de le distinguer d'une simple base de données.
Pour commencer, la vidéo suivante utilise une analogie simple pour clarifier pourquoi les entreprises ont besoin d'un système dédié à l'analyse, distinct de leurs bases de données opérationnelles qui gèrent les transactions quotidiennes.
KNOW the difference between Data Base // Data Warehouse // Data Lake (Easy Explanation👌)
Cette vidéo de Chandoo, intitulée "KNOW the difference between Data Base // Data Warehouse // Data Lake", explique de manière intuitive la raison d'être d'un entrepôt de données.
Regardez la section de 01:43 à 04:08. Concentrez-vous sur la distinction entre la base de données (qui gère l'activité courante) et l'entrepôt de données (conçu comme un référentiel historique pour l'analyse).
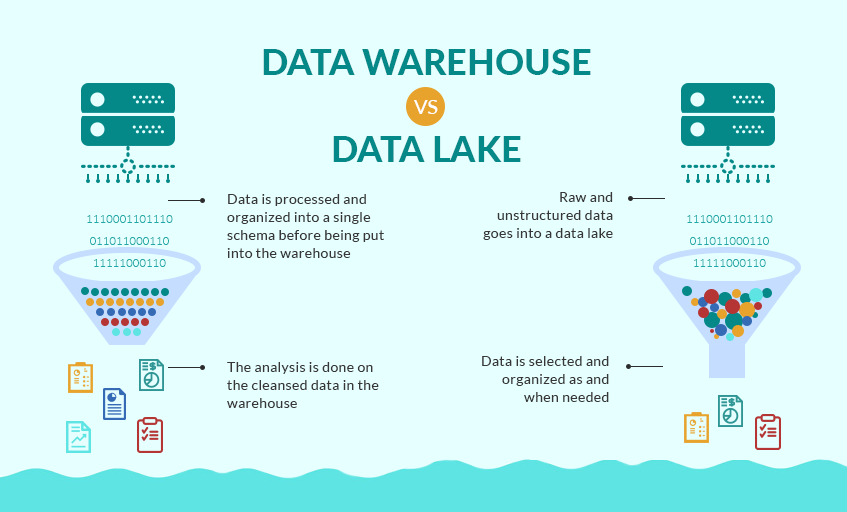
Un entrepôt de données est donc un système de stockage centralisé qui contient de grandes quantités de données structurées, provenant de diverses sources internes (CRM, systèmes comptables, etc.). Ces données sont nettoyées, transformées et organisées avant d'être stockées.
Les deux concepts clés à retenir sont :
-
Le processus ETL (Extract, Transform, Load) :
- Extract : Les données sont extraites de leurs systèmes sources.
- Transform : Elles sont nettoyées, validées, standardisées et agrégées pour correspondre à un format unique et cohérent. C'est l'étape la plus complexe.
- Load : Les données désormais propres et structurées sont chargées dans l'entrepôt.
-
Le principe du "Schema-on-Write" : La structure des données (le "schéma") doit être définie avant l'écriture des données dans l'entrepôt. Cela garantit la cohérence et la qualité, mais au prix d'une grande rigidité. Si vous voulez ajouter une nouvelle source de données, vous devez d'abord modifier le schéma de l'entrepôt.
Pour approfondir le sujet dans un contexte financier, l'article suivant est très pertinent.
What Is a Financial Data Warehouse and How Does It Work
L'article "What Is a Financial Data Warehouse and How Does It Work" ancre le concept d'entrepôt de données directement dans le secteur financier. Il détaille son fonctionnement et ses composants.
Veuillez lire la section "Financial Data Warehouse Basics". Portez une attention particulière au tableau décrivant le processus ETL (Data Extraction, Transformation, Loading) et aux caractéristiques clés de l'entrepôt de données.
En résumé, l'entrepôt de données est comme une bibliothèque : les livres (données) sont catalogués, organisés sur des étagères précises et prêts à être consultés pour des usages bien définis, comme le reporting réglementaire, la business intelligence (BI) ou l'analyse financière classique.
L'approche moderne : le Lac de Données (Data Lake)
Avec l'explosion du Big Data, les entrepôts de données ont montré leurs limites : ils sont coûteux, rigides et, surtout, inadaptés aux données non structurées et semi-structurées. Le lac de données a été conçu pour surmonter ces défis.
L'article en français ci-dessous offre une excellente introduction au concept.
Qu'est-ce qu'un data lake ? Comprendre le lac de données
Cet article, "Qu'est-ce qu'un data lake ?", définit le concept de lac de données et explique sa philosophie fondamentale.
Lisez les sections "Data lake : Qu’est-ce que c’est ?" et la sous-section "Modèle schema-on-read" dans "Architecture d’un data lake". L'objectif est de saisir le concept de base : stocker des données brutes sans structure préalable et la philosophie du 'schema-on-read'.
Un lac de données est un référentiel de stockage centralisé qui permet de conserver d'immenses volumes de données de tout type, dans leur format brut et natif.
Les concepts clés, en miroir de ceux de l'entrepôt de données, sont :
-
Le processus ELT (Extract, Load, Transform) :
- Extract : Les données sont extraites de leurs sources.
- Load : Elles sont chargées immédiatement dans le lac de données, sans transformation.
- Transform : Elles ne sont transformées qu'au moment de l'analyse, en fonction du besoin spécifique de l'utilisateur (data scientist, analyste, etc.).
-
Le principe du "Schema-on-Read" : Aucune structure n'est imposée à l'écriture. Le schéma est appliqué au moment de la lecture ou de la requête. Cela offre une flexibilité maximale pour explorer les données et poser des questions qui n'avaient pas été anticipées.
Le lac de données est donc comme un immense réservoir d'eau brute. L'eau (les données) est stockée telle quelle. Différents utilisateurs peuvent venir y puiser et la filtrer (transformer) pour leurs propres usages : un data scientist pour entraîner un modèle de machine learning, un analyste pour une exploration ponctuelle, etc.
Comparaison directe : Data Warehouse vs. Data Lake
Maintenant que nous avons défini les deux concepts, une comparaison systématique permettra de bien fixer les différences.
La vidéo suivante d'IBM Technology résume parfaitement les points de comparaison essentiels.
Data Lake vs. Data Warehouse vs. Data Lakehouse: Which One to Choose?
Pour synthétiser, regardons une comparaison directe et systématique. Cette vidéo décompose les différences selon six critères clés.
Veuillez regarder la section de 03:38 à 07:05 (la partie finale sur le 'data lakehouse' est un aperçu intéressant mais hors du champ de cette leçon). Prenez note des six points de comparaison : l'objectif (purpose), la structure des données, le coût de stockage, la performance, la flexibilité (schema) et l'évolutivité (scalability).
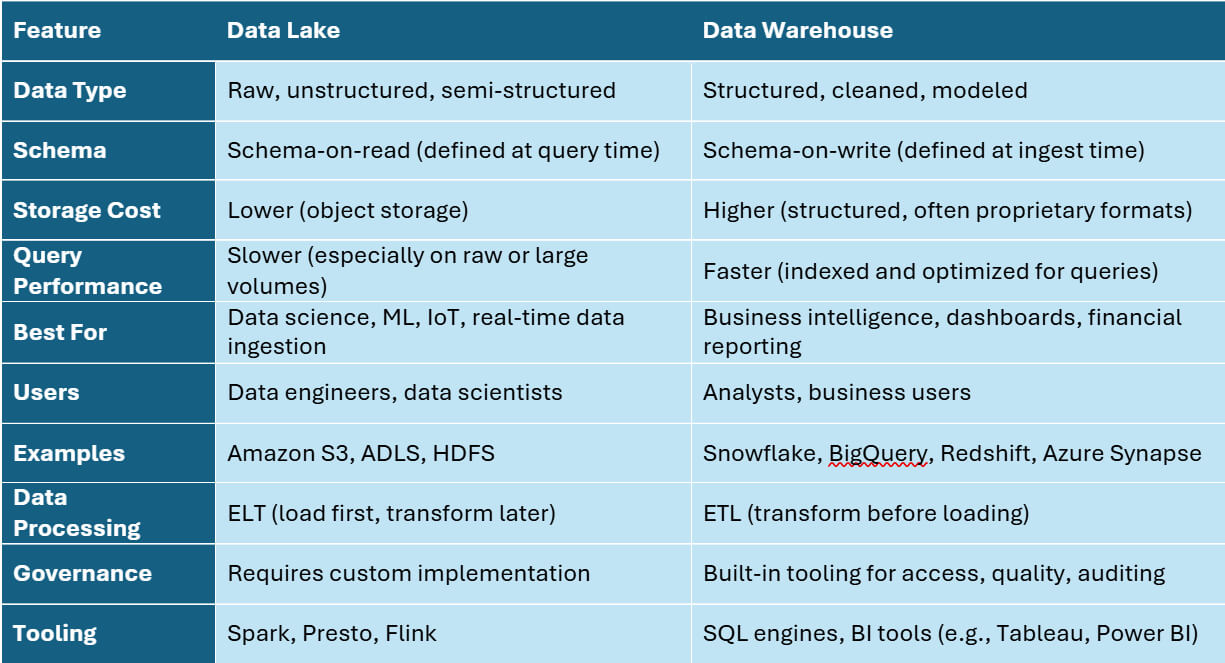
Synthétisons ces différences dans un tableau :
| Caractéristique | Entrepôt de Données (Data Warehouse) | Lac de Données (Data Lake) |
|---|---|---|
| Type de données | Structurées, traitées | Toutes : structurées, semi-structurées, non structurées (brutes) |
| Schéma | Schema-on-Write (Schéma défini avant l'écriture) | Schema-on-Read (Schéma appliqué à la lecture) |
| Processus | ETL (Extract, Transform, Load) | ELT (Extract, Load, Transform) |
| Utilisateurs | Analystes d'affaires, managers | Data scientists, analystes de données, développeurs de modèles ML |
| Usage principal | Business Intelligence, reporting, analyses pré-définies | Exploration de données, data science, Machine Learning, analyses prédictives |
| Flexibilité | Faible, structure rigide | Élevée, adaptable à de nouveaux usages |
| Coût de stockage | Élevé (stockage spécialisé et coûteux) | Faible (utilise du stockage objet bon marché, souvent sur le cloud) |
| Risque principal | Coût élevé et lenteur à s'adapter aux nouveaux besoins. | Devenir un "marécage de données" (data swamp) si la gouvernance est insuffisante. |
Le concept de "marécage de données" (ou data swamp), évoqué dans l'article de Naitways, est crucial. Sans un catalogage et une gestion des métadonnées adéquats, un lac de données peut devenir un chaos inutilisable où personne ne sait ce que contiennent les données, d'où elles viennent, ou si elles sont fiables.
Testez votre compréhension !
Une banque d'investissement poursuit deux objectifs stratégiques :
- Produire des rapports réglementaires mensuels très standardisés sur l'exposition au risque de crédit, en se basant sur 10 ans de données transactionnelles et de notation internes. Ces rapports doivent être générés rapidement et être d'une fiabilité irréprochable.
- Développer un nouvel algorithme de trading en utilisant des données de marché à haute fréquence, des articles de presse financière, des flux de tweets et des rapports d'analystes au format PDF, pour tenter de prédire les mouvements de marché à court terme.
Pour chaque objectif, quelle solution de stockage (Data Warehouse ou Data Lake) serait la plus appropriée, et pourquoi ?
Voir la réponse
-
Objectif 1 : Entrepôt de Données (Data Warehouse).
- Justification : Les données sont structurées (transactions, notations), les analyses sont répétitives et pré-définies (rapports standardisés), et les exigences de performance et de fiabilité sont élevées. C'est le cas d'usage parfait pour un entrepôt de données optimisé pour des requêtes rapides sur des données propres et organisées (schema-on-write).
-
Objectif 2 : Lac de Données (Data Lake).
- Justification : Cet objectif implique l'analyse exploratoire d'une grande variété de données (structurées, semi-structurées, non structurées). Les data scientists ont besoin d'accéder aux données brutes pour tester différentes hypothèses et fonctionnalités pour leur modèle de Machine Learning. La flexibilité du "schema-on-read" est indispensable ici, car la structure de l'analyse n'est pas connue à l'avance.
Conclusion
Aujourd'hui, nous avons établi une distinction claire entre deux piliers de l'architecture de données moderne.
- L'entrepôt de données est une source de vérité hautement organisée et fiable pour les données structurées, idéale pour la business intelligence et le reporting. Il privilégie la qualité et la performance au détriment de la flexibilité.
- Le lac de données est un référentiel flexible et économique pour stocker toutes les données d'une entreprise dans leur format brut, ce qui en fait le terrain de jeu idéal pour la data science et le machine learning. Il privilégie la flexibilité et l'exhaustivité au détriment de la structure initiale.
En pratique, de nombreuses grandes institutions financières utilisent aujourd'hui une architecture hybride, combinant un data warehouse pour leurs besoins de reporting critiques et un data lake pour l'innovation et l'analyse avancée.
Dans la prochaine leçon, nous nous pencherons sur l'origine de toutes ces données. Nous identifierons les principales sources de big data dans les services financiers, allant des données de marché traditionnelles aux sources de "données alternatives" de plus en plus influentes, comme les transactions par carte de crédit ou les données de géolocalisation.