Bonjour !
Dans la leçon précédente, nous avons exploré les robo-advisors, une forme d'automatisation financière basée sur des règles fixes et des stratégies d'investissement passives. Nous avons vu comment ils démocratisent l'accès à la gestion de portefeuille, mais leur approche reste relativement statique.
Aujourd'hui, nous allons faire un grand pas en avant pour explorer une forme d'automatisation beaucoup plus dynamique et adaptative. L'objectif de cette leçon est d'expliquer les concepts fondamentaux de l'apprentissage par renforcement (Reinforcement Learning - RL) — agent, environnement, récompense — et son application dans les stratégies de trading dynamiques.
L'apprentissage par renforcement est un domaine de l'intelligence artificielle qui s'inspire de la psychologie comportementale. Il ne s'agit plus de suivre des règles pré-programmées, mais d'apprendre la meilleure stratégie par essais et erreurs, en interagissant directement avec un environnement complexe comme le marché financier. C'est un changement de paradigme fondamental, passant de l'automatisation de tâches à l'automatisation de l'apprentissage lui-même.
1. Le Cadre de l'Apprentissage par Renforcement
Au cœur de l'apprentissage par renforcement se trouve une boucle d'interaction continue entre un agent et son environnement.
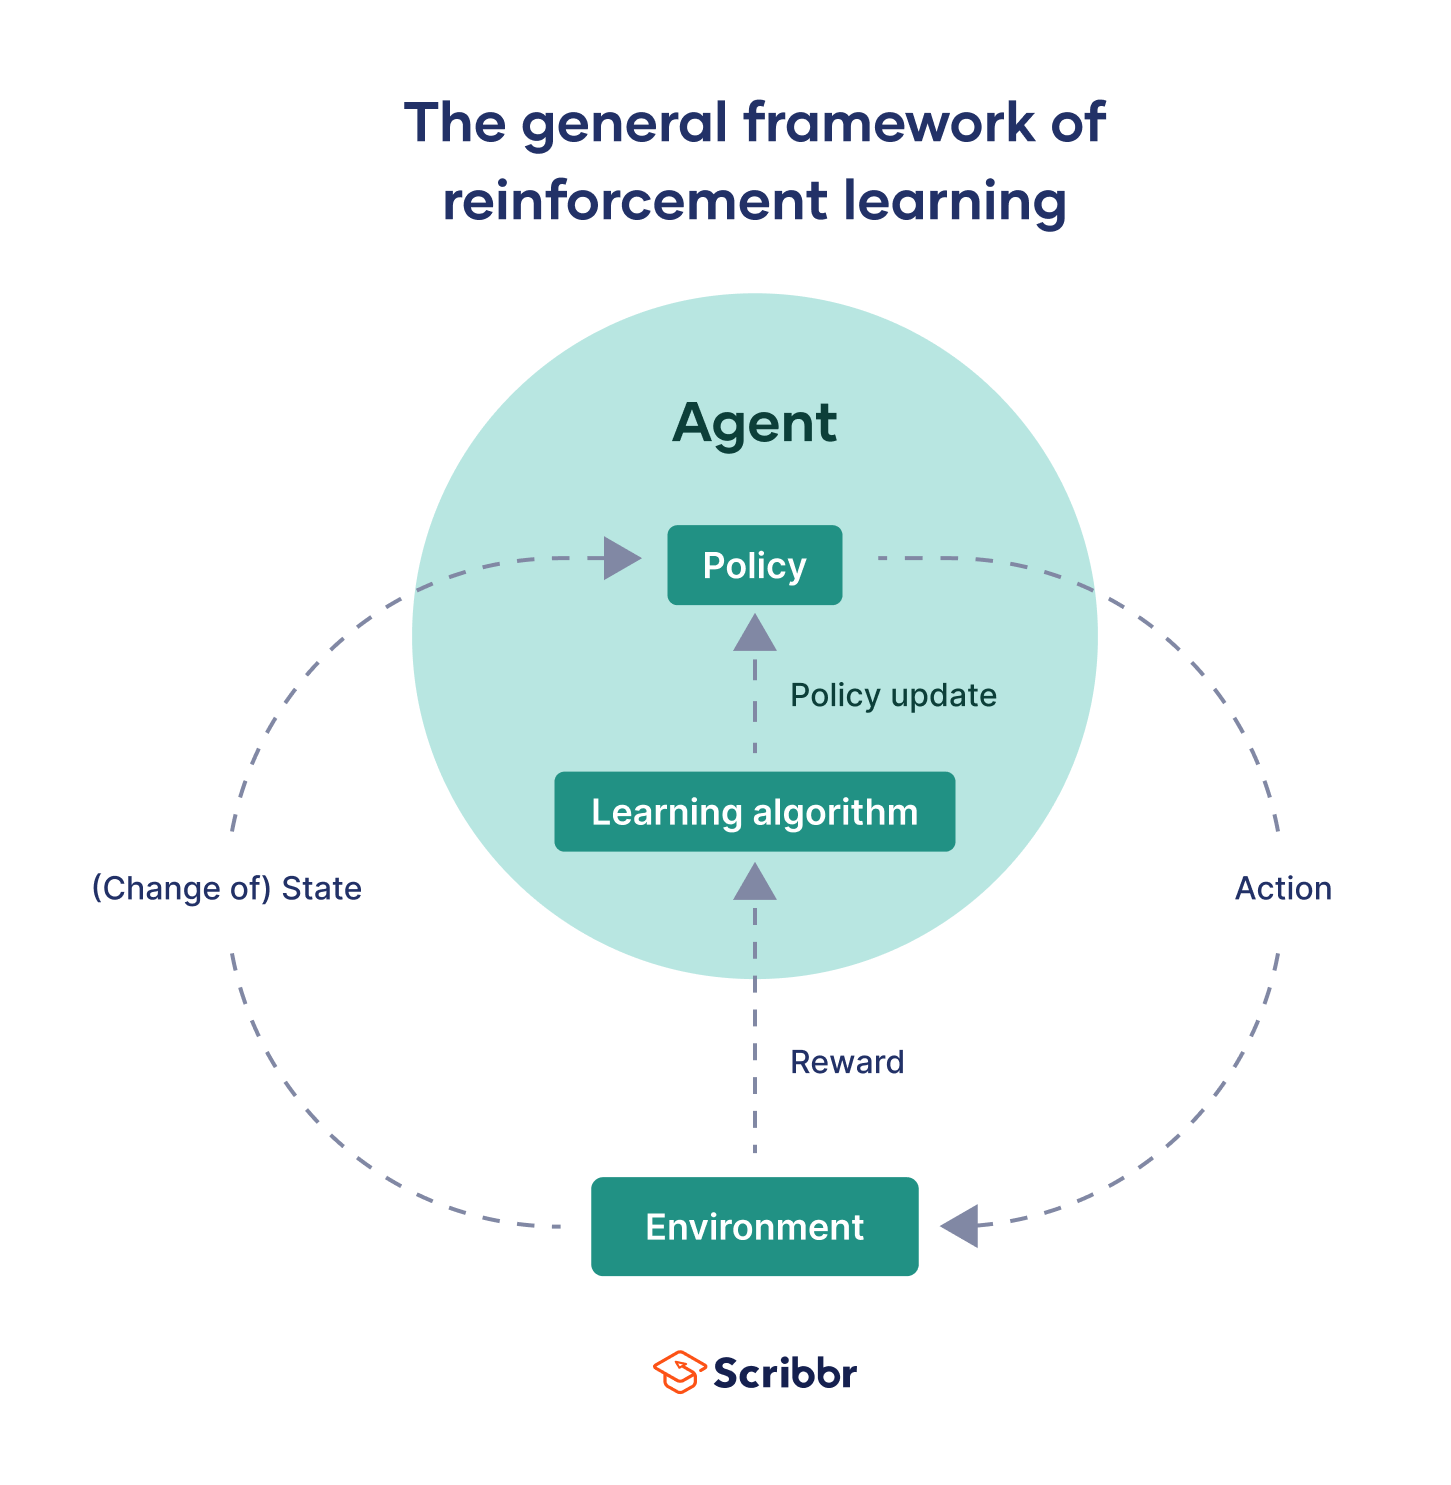
Pour bien comprendre ces composants dans un contexte financier, je vous propose de lire la section suivante d'un article qui les définit clairement.
Reinforcement Learning in Trading
L'article "Reinforcement Learning in Trading" du blog QuantInsti offre des définitions claires et concises des composants de base de l'apprentissage par renforcement, directement appliquées au trading.
Lisez la section intitulée "Components of Reinforcement Learning". Concentrez-vous sur la définition de chacun des six termes : Actions, Policy, State, Rewards, Environment, et RL Agent. Essayez de visualiser comment chaque concept se traduit dans un scénario de trading.
Pour résumer et formaliser ces concepts :
- Agent : C'est l'algorithme qui prend les décisions. Dans notre cas, ce serait un programme de trading automatisé.
- Environnement : C'est le monde dans lequel l'agent opère et qu'il peut influencer par ses actions. Pour un agent de trading, l'environnement est le marché financier (par exemple, les cours des actions, le carnet d'ordres, les flux de nouvelles).
- Action () : C'est une des actions possibles que l'agent peut entreprendre à un instant . Les actions de base pour un trader sont : Acheter, Vendre, ou Ne rien faire (Hold).
- État () : C'est une description de l'environnement à un instant . Pour un trader, l'état peut inclure des informations comme les prix récents, le volume des transactions, des indicateurs techniques (RSI, moyennes mobiles), ou même le sentiment extrait des nouvelles financières.
- Récompense () : C'est le feedback numérique que l'environnement envoie à l'agent après qu'il a pris une action. C'est le signal que l'agent cherche à maximiser sur le long terme.
2. L'Objectif : Maximiser la Récompense Cumulative
Contrairement à l'apprentissage supervisé où le modèle est corrigé à chaque étape, l'agent RL peut recevoir des récompenses avec un certain délai. Une bonne action maintenant (acheter une action) peut ne révéler son bénéfice que bien plus tard. Ce concept de "gratification différée" est central.
L'objectif de l'agent n'est pas de maximiser la récompense immédiate, mais la somme cumulée des récompenses futures, souvent actualisées. Votre formation en économie vous a familiarisé avec les concepts d'actualisation et de maximisation de l'utilité intertemporelle ; le principe est très similaire ici.
Pour approfondir ces notions, je vous propose de visionner des extraits d'une conférence de David Silver, l'un des chercheurs principaux de DeepMind et une figure de proue du domaine.
RL Course by David Silver - Lecture 1: Introduction to Reinforcement Learning
Cette vidéo est la première leçon du cours sur l'apprentissage par renforcement de David Silver. Elle pose les bases de manière très claire et rigoureuse.
Regardez les extraits suivants : De 06:18 à 08:50 : pour comprendre ce qui distingue le RL des autres types de ML (pas de superviseur, feedback retardé, importance du temps, influence de l'agent sur ses données). De 22:47 à 27:26 : pour comprendre la notion de "récompense" et "l'hypothèse de la récompense", avec un exemple direct sur la gestion de portefeuille. De 29:31 à 33:44 : pour visualiser la boucle d'interaction agent-environnement.
Comme l'a souligné David Silver, la "récompense" est un simple signal scalaire, mais le choix de sa définition est crucial et détermine entièrement le comportement que l'agent va apprendre.
3. Le "Cerveau" de l'Agent : Politique et Fonction de Valeur
Comment l'agent décide-t-il quelle action prendre ? Il s'appuie sur deux concepts clés :
- Politique () : C'est la stratégie de l'agent, une fonction qui associe un état à une action. On peut la voir comme le "cerveau" de l'agent. L'objectif de l'apprentissage est de trouver la politique optimale () qui maximise la récompense cumulative attendue.
- Fonction de Valeur ( ou ) : C'est une prédiction de la récompense cumulative future attendue.
- estime la valeur d'être dans un certain état .
- (plus courante) estime la valeur de prendre une action dans un état .
En apprenant une fonction de valeur précise, l'agent peut simplement choisir l'action qui mène à l'état ayant la plus grande valeur. Cette approche, basée sur la résolution des équations de Bellman, est conceptuellement liée aux méthodes de programmation dynamique que vous avez pu rencontrer en économie.
Continuons avec la vidéo de David Silver pour une explication de ces composants internes de l'agent.
RL Course by David Silver - Lecture 1: Introduction to Reinforcement Learning
Dans cette partie, David Silver introduit les trois composants internes possibles d'un agent RL.
Regardez l'extrait de 57:16 à 1:04:10. Concentrez-vous sur les définitions conceptuelles de la Politique (Policy) et de la Fonction de Valeur (Value Function). La notion de Modèle (Model) est également introduite, distinguant les approches "model-free" (l'agent apprend directement par essais-erreurs) des approches "model-based" (l'agent essaie d'abord de construire une simulation interne de l'environnement).
4. Application aux Stratégies de Trading Dynamiques
Maintenant, appliquons concrètement ces concepts au développement d'une stratégie de trading. La vidéo suivante, par le Dr. Tom Starke, un expert en trading quantitatif, illustre parfaitement cette transition de la théorie à la pratique.
Reinforcement Learning for Trading Practical Examples and Lessons Learned by Dr. Tom Starke
Cette conférence de la plateforme Quantopian se concentre sur les aspects pratiques de l'application du RL au trading.
Regardez les deux extraits suivants : De 04:09 à 07:53 : pour voir comment les concepts de base (état, action, récompense, politique) sont définis dans un processus de trading. De 11:11 à 12:48 : cet extrait aborde un point crucial et très pratique : l'ingénierie de la fonction de récompense (reward function engineering). Notez les différentes manières de définir la récompense au-delà du simple P&L (Profit and Loss).
Comme l'explique le Dr. Starke, la conception de la fonction de récompense est un art. Une récompense basée uniquement sur le P&L final pourrait encourager l'agent à simplement acheter et conserver une action haussière (stratégie "buy and hold"), ce qui n'est pas une stratégie de trading dynamique.
Un ingénieur financier pourrait concevoir des récompenses plus sophistiquées, par exemple :
- Récompenser le Sharpe ratio pour encourager des rendements ajustés au risque.
- Pénaliser les transactions excessives en incluant les coûts de transaction dans le calcul de la récompense.
- Pénaliser une trop longue détention de position pour favoriser des cycles de trading plus courts.
- Donner une récompense binaire (+1 pour un trade profitable, -1 pour un trade perdant) pour que l'agent se concentre sur la régularité plutôt que sur l'ampleur des gains.
Testez votre compréhension !
Imaginez que vous souhaitez entraîner un agent RL pour une stratégie de trading à haute fréquence qui doit clôturer toutes ses positions à la fin de la journée. Comment pourriez-vous concevoir la fonction de récompense pour encourager ce comportement ?
Voir la réponse
En plus de la récompense principale basée sur le P&L ou le Sharpe ratio des trades de la journée, vous pourriez introduire une forte pénalité négative si l'agent détient encore des positions après l'heure de clôture du marché. Cette pénalité agirait comme un puissant signal de renforcement négatif, "enseignant" à l'agent qu'il est impératif de liquider ses positions pour éviter une "punition" importante, et ce, quelle que soit la performance des trades de la journée.
5. Les Défis du RL dans le Monde Réel du Trading
Le RL n'est pas une solution miracle. Son application aux marchés financiers est particulièrement difficile.
Reinforcement Learning for Trading Practical Examples and Lessons Learned by Dr. Tom Starke
Le Dr. Starke conclut sa présentation en soulignant les difficultés pratiques rencontrées.
Regardez le court extrait de 35:36 à 37:54. Il met en lumière plusieurs défis majeurs.
Voici les principaux défis à retenir :
- Le bruit : Les données financières sont extrêmement bruitées. L'agent peut apprendre de fausses corrélations basées sur des fluctuations aléatoires.
- La non-stationnarité : Les "règles du jeu" du marché changent constamment (changements de régime de volatilité, impacts macroéconomiques...). Un agent entraîné sur des données passées peut ne plus être performant dans le futur.
- La rareté des récompenses (sparse rewards) : Le résultat d'une action peut prendre du temps à se matérialiser, ce qui rend l'attribution du succès ou de l'échec à une action spécifique (le "credit assignment problem") très difficile.
- L'impact sur le marché : Un agent entraîné en simulation ne prend pas en compte que ses propres ordres, s'ils sont importants, peuvent influencer les prix du marché.
Conclusion
Dans cette leçon, nous avons plongé dans le monde fascinant de l'apprentissage par renforcement. Contrairement aux approches plus statiques, le RL propose un cadre pour qu'un agent apprenne de manière autonome une stratégie optimale en interagissant avec son environnement.
Points clés à retenir :
- Le RL est basé sur une boucle d'interaction entre un agent (le décideur) et un environnement (le marché).
- L'agent prend des actions (acheter, vendre), observe le nouvel état du marché et reçoit une récompense (feedback).
- L'objectif de l'agent est de trouver une politique (stratégie) qui maximise la récompense cumulative future, pas seulement le gain immédiat.
- Dans le trading, le RL permet de créer des stratégies dynamiques, mais la conception de la fonction de récompense est cruciale pour guider l'agent vers le comportement souhaité.
- Son application pratique est semée d'embûches, notamment à cause du bruit, de la non-stationnarité des marchés et du problème de l'attribution du crédit.
Nous avons exploré comment l'IA, sous sa forme la plus avancée, peut être utilisée pour créer des systèmes centralisés intelligents qui cherchent à optimiser leurs actions dans des environnements complexes.
Dans le prochain module, nous aborderons une innovation technologique d'une nature radicalement différente. Nous quitterons le monde de l'intelligence centralisée pour entrer dans celui de la confiance décentralisée avec l'étude de la Blockchain et des technologies de registres distribués.