Bonjour et bienvenue dans cette nouvelle leçon du module sur les applications du Big Data en finance.
Introduction
Dans le module précédent, nous avons jeté les bases conceptuelles et techniques du Big Data. Nous avons exploré les "5 V", les types de données, les architectures systèmes et, enfin, le rôle crucial du cloud computing pour rendre ces technologies accessibles. Nous avons compris le "quoi" et le "comment". Il est temps de passer au "pourquoi" : les applications concrètes qui transforment le secteur financier.
Cette leçon aborde l'une des applications les plus impactantes : l'évaluation du risque de crédit. Votre expertise en analyse quantitative et en économétrie vous a familiarisé avec les modèles de scoring traditionnels, qui reposent souvent sur des techniques économétriques appliquées à des données financières structurées. L'objectif d'aujourd'hui est d'expliquer comment l'analyse Big Data permet de dépasser ces modèles traditionnels pour évaluer le risque de crédit de manière plus précise, plus inclusive et plus dynamique.
Nous allons structurer notre analyse en quatre points :
- Les limites des modèles de crédit traditionnels.
- L'élargissement de l'univers des données avec les "données alternatives".
- L'utilisation de nouveaux "moteurs" d'analyse : les modèles de Machine Learning.
- Les bénéfices concrets et les défis de cette nouvelle approche.
1. Le Modèle Traditionnel de Risque de Crédit et ses Limites
Traditionnellement, une banque ou un prêteur évalue la solvabilité d'un demandeur en se basant sur un ensemble restreint de données, principalement :
- Les données des agences de crédit (par ex., score FICO) : historique de remboursement, encours de dettes, ancienneté du crédit.
- Les données financières fournies par le client : bulletins de salaire, relevés de compte, bilans pour une entreprise.
- Les données internes à la banque : historique des transactions et des produits détenus.
Ces données, majoritairement structurées et historiques, sont ensuite utilisées dans des modèles statistiques. Vous connaissez bien l'un des plus courants : la régression logistique, qui vise à prédire la probabilité de défaut (une variable binaire : 0 ou 1) en fonction de quelques variables explicatives clés.
Si cette approche a fait ses preuves, elle présente des limites importantes à l'ère du numérique :
- L'exclusion des profils "invisibles" : Une grande partie de la population mondiale n'a pas d'historique de crédit formel. On les appelle les profils "thin-file" (peu de données) ou "no-file" (pas de données). Il peut s'agir de jeunes adultes, d'immigrants récents, de travailleurs indépendants ou de micro-entreprises dans les pays émergents. Pour eux, le système traditionnel est une porte fermée.
- Le caractère statique : Les scores de crédit sont mis à jour périodiquement (souvent trimestriellement ou annuellement). Ils ne capturent pas les changements rapides dans la situation financière d'un individu ou d'une entreprise.
- Une vision incomplète : Se baser uniquement sur des données financières passées ne donne qu'une image partielle de la "capacité" et de la "volonté" de remboursement d'une personne.
Le Big Data offre des solutions à ces trois problèmes en changeant à la fois les données utilisées et la manière de les analyser.
2. Le carburant du Big Data : les Données Alternatives
La première révolution apportée par le Big Data est l'élargissement considérable de l'éventail des données pertinentes pour l'évaluation du risque. On parle de données alternatives pour désigner toutes les informations qui ne figurent pas dans un rapport de crédit traditionnel.
Pour commencer, l'article suivant offre une bonne introduction à ce concept et aux différents types de données mobilisées.
Using Big Data for Credit Risk Management
L'article "Using Big Data for Credit Risk Management" de Neeraj Goyal, publié sur Banking Exchange, dresse un panorama clair des types de données utilisées dans les nouvelles approches de gestion du risque de crédit.
Veuillez lire l'introduction et la section "Types of Big Data in Credit Risk Management". Notez bien la distinction entre les données structurées traditionnelles et les nouvelles sources de données non structurées et alternatives.
Comme vous l'avez lu, ces données proviennent de l'empreinte numérique que nous laissons quotidiennement. Le rapport de la Banque Mondiale ci-dessous fournit une taxonomie très détaillée de ces sources.
The Use of Alternative Data in Credit Risk Assessment
Le rapport de la Banque Mondiale, "The Use of Alternative Data in Credit Risk Assessment", est une ressource de référence sur le sujet. Il détaille l'impact de ces données sur l'inclusion financière.
Commencez par lire la section 2.1 "Rationale and definitions" pour une définition formelle des données alternatives. Ensuite, étudiez attentivement le tableau 1 "Summary of Various Alternative Data Types for Credit Risk Assessment". Ce tableau est un excellent outil pédagogique que vous pourrez réutiliser pour illustrer la diversité de ces données.

Pour résumer, les principales catégories de données alternatives incluent :
- Comportement financier non traditionnel :
- Paiements récurrents : factures de téléphone, d'électricité, d'internet, loyers. La régularité de ces paiements est un excellent indicateur de fiabilité.
- Transactions sur les portefeuilles numériques (PayPal, etc.) ou les services "Buy Now, Pay Later" (BNPL).
- Comportement et style de vie :
- Données de géolocalisation et d'utilisation d'applications mobiles.
- Activité sur les réseaux sociaux ou le web (avec de fortes contraintes de confidentialité et d'éthique).
- Données commerciales pour les PME :
- Transactions sur les plateformes de e-commerce (volume de ventes, avis clients).
- Données de la chaîne logistique ou des logiciels de comptabilité en ligne.
L'intégration de ces données permet de construire une vision à 360 degrés et en temps réel de la situation d'un demandeur, révélant des signaux de stabilité (ou d'instabilité) financière invisibles pour les modèles traditionnels.
Testez votre compréhension !
Prenons le cas d'une chauffeuse VTC qui travaille à son compte depuis deux ans. Elle n'a pas d'historique de crédit formel, car elle n'a jamais eu de carte de crédit ni fait d'emprunt. Elle souhaite obtenir un petit prêt pour renouveler son véhicule. Un modèle de crédit traditionnel la rejetterait probablement comme "inscoreable".
Quels types de données alternatives pourraient aider une banque à évaluer positivement son dossier ?
Voir la réponse
Plusieurs types de données alternatives pourraient construire un dossier de crédit solide pour elle :
- Données de la plateforme VTC (données "gig economy") :
- Stabilité des revenus : L'historique de ses courses sur les deux dernières années peut démontrer un revenu régulier et prévisible.
- Fiabilité : Ses notes clients et son taux d'acceptation de courses peuvent témoigner de son professionnalisme.
- Activité : Le nombre d'heures de connexion et de courses effectuées montre son engagement professionnel.
- Données de télécommunication (Telco) : Un historique de paiement ponctuel de sa facture de téléphone mobile sur plusieurs années est un signe de discipline financière.
- Données bancaires (via Open Banking) : L'analyse de son compte courant peut révéler des flux de revenus constants et une bonne gestion de son solde.
- Données de paiement de services publics : La preuve qu'elle paie son loyer, son électricité et son internet à temps chaque mois.
En combinant ces sources, la banque peut obtenir une image très fiable de sa capacité et de sa volonté de remboursement, même en l'absence de crédit formel.
3. Le moteur du Big Data : les Modèles de Machine Learning
Disposer d'une avalanche de données ne suffit pas. Les modèles statistiques traditionnels sont souvent mal adaptés pour traiter des milliers de variables (haute dimensionnalité) et pour capturer les relations complexes et non linéaires qui s'y cachent.
C'est là qu'intervient la deuxième révolution : l'utilisation de modèles de Machine Learning (ML) comme nouveau moteur d'analyse. Nous explorerons ces modèles en détail dans un prochain module, mais il est important d'en saisir le principe ici. Contrairement à une régression logistique où un analyste choisit un nombre limité de variables, les algorithmes de ML comme les forêts d'arbres décisionnels (Random Forests) ou le Gradient Boosting peuvent :
- Analyser des milliers de variables simultanément.
- Détecter automatiquement les interactions complexes et les schémas non-linéaires.
- Apprendre et s'améliorer continuellement à mesure que de nouvelles données arrivent.
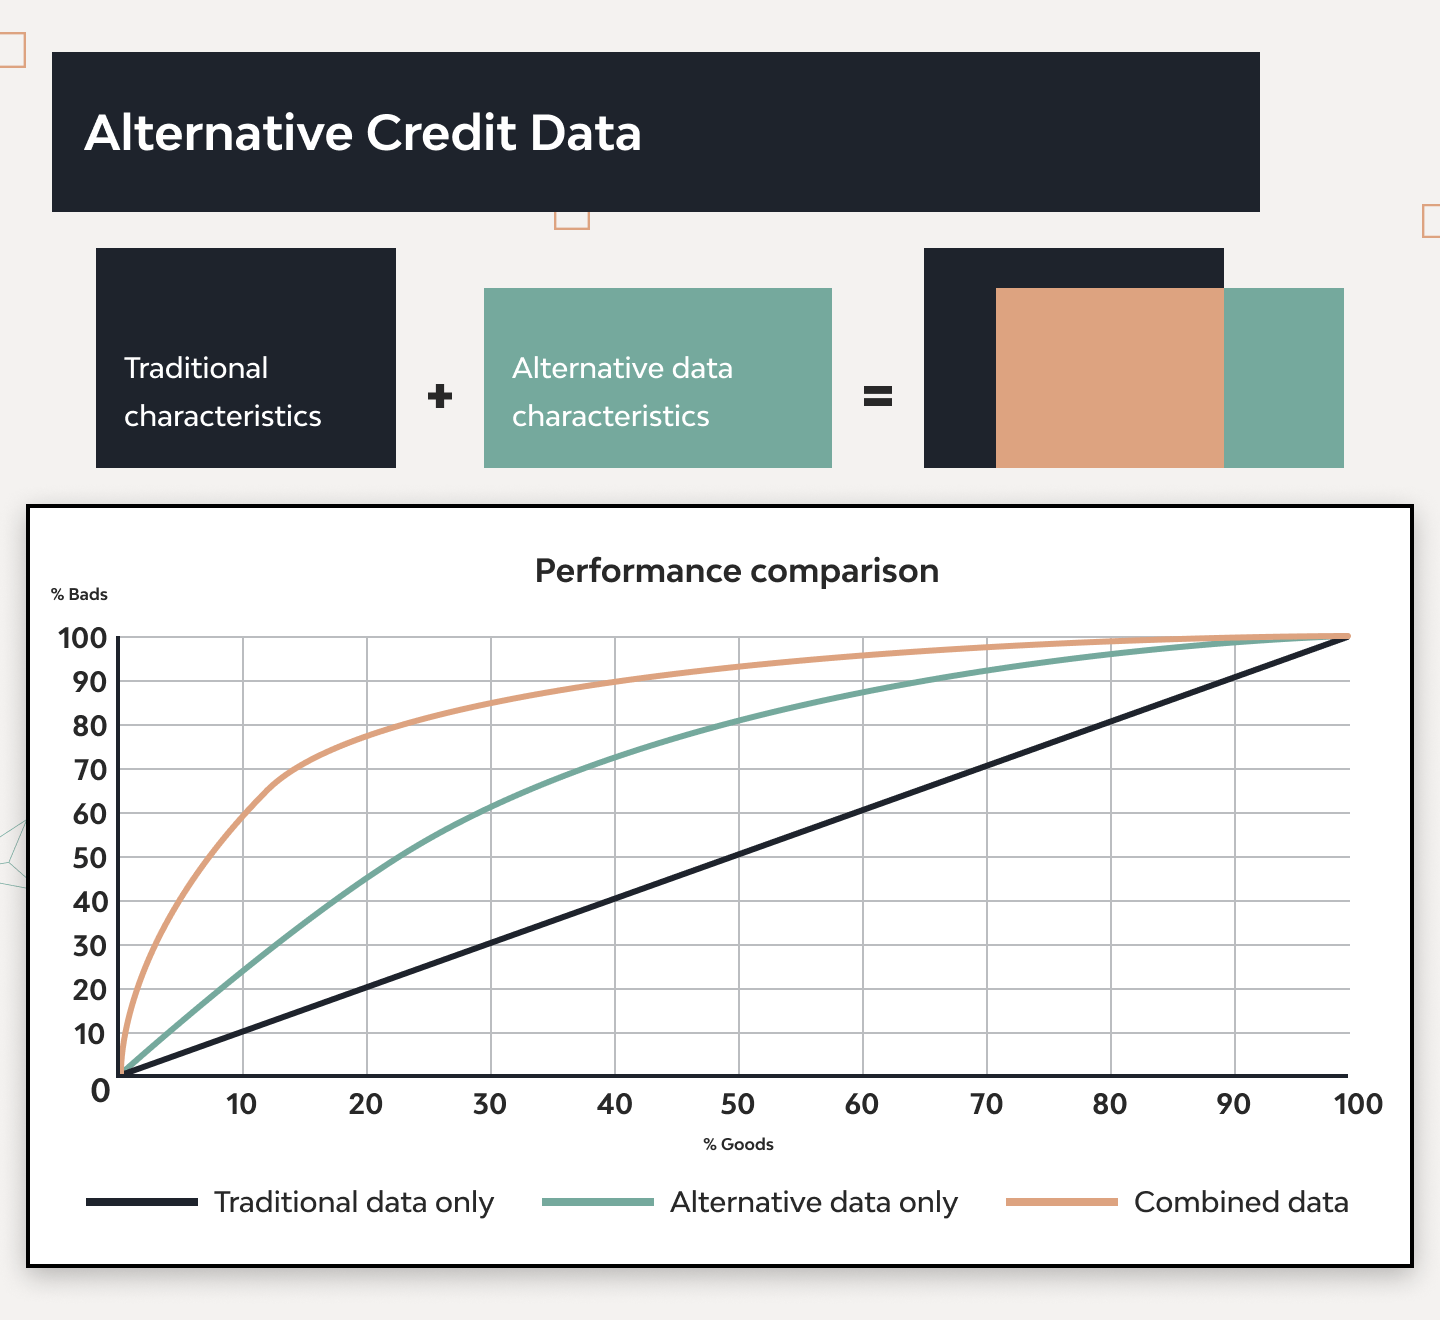
Le résultat de cette combinaison (plus de données + des modèles plus puissants) est une amélioration significative de la performance prédictive.
L'image ci-dessous illustre parfaitement ce gain de performance.
Cette puissance accrue se traduit par des applications concrètes :
- Scoring de crédit amélioré : Des prédictions de défaut plus précises qui réduisent les pertes pour la banque et augmentent l'accès au crédit pour les bons profils.
- Systèmes d'alerte précoce (Early Warning Systems) : En analysant des données en temps réel (ex: transactions, utilisation du découvert), la banque peut détecter des signes de détresse financière bien avant un défaut de paiement et proposer des solutions proactives.
- Tarification basée sur le risque (Risk-Based Pricing) : Au lieu de quelques grandes catégories de taux, la banque peut proposer des taux d'intérêt finement ajustés au profil de risque individuel de chaque emprunteur.
4. Mise en Œuvre, Bénéfices et Défis
Cette transformation n'est pas seulement théorique. Les plus grandes agences de crédit mondiales ont déjà intégré les données alternatives dans leurs produits. Le rapport de la Banque Mondiale mentionne plusieurs exemples concrets.
The Use of Alternative Data in Credit Risk Assessment
Pour voir comment ces concepts sont appliqués en pratique, nous allons consulter une dernière section du rapport de la Banque Mondiale.
Veuillez lire la section 3.2.1, en particulier l'encadré (Box 5) "Evolution of adoption and use of alternative data in credit risk assessment". Il décrit comment Experian, TransUnion et Equifax utilisent ces données pour créer de nouveaux produits de scoring.
Des produits comme Experian Boost, qui permet aux consommateurs d'ajouter eux-mêmes leurs paiements de factures (téléphone, streaming) pour améliorer leur score, sont l'illustration parfaite de cette tendance.
Cependant, cette approche soulève des défis importants qui doivent être gérés avec rigueur :
- Confidentialité et sécurité des données : L'utilisation de données personnelles sensibles impose un respect strict des réglementations (comme le RGPD en Europe).
- Qualité et biais des données : Les données alternatives peuvent être bruitées ou incomplètes. Pire, elles peuvent contenir des biais qui mènent à des discriminations. Par exemple, utiliser la géolocalisation pourrait pénaliser injustement les habitants de quartiers défavorisés.
- Interprétabilité des modèles ("Black Box") : Les modèles de ML complexes sont souvent des "boîtes noires", rendant difficile d'expliquer pourquoi un prêt a été refusé. C'est un enjeu majeur pour la conformité réglementaire et la confiance des clients.
Conclusion
Nous avons vu que le Big Data révolutionne l'évaluation du risque de crédit bien au-delà des méthodes traditionnelles.
Les points clés à retenir sont :
- L'approche Big Data dépasse les limites des modèles traditionnels en s'attaquant au problème des profils "invisibles" et en offrant une vision plus dynamique du risque.
- Elle repose sur deux piliers : l'utilisation d'un univers de données alternatives (paiements de factures, données de transaction, etc.) et l'application de modèles de Machine Learning capables d'en extraire la valeur prédictive.
- Les bénéfices sont concrets : des modèles plus précis, une meilleure inclusion financière et des produits plus personnalisés comme la tarification basée sur le risque.
- Cette transformation s'accompagne de défis éthiques et réglementaires cruciaux concernant la confidentialité, les biais et la transparence des algorithmes.
Dans la prochaine leçon, nous explorerons une autre application majeure du Big Data en finance : l'utilisation des données pour la segmentation client et la personnalisation des services. Nous verrons comment les mêmes sources de données peuvent servir à la fois à gérer les risques et à créer de la valeur commerciale.