你好。上一课我们建立了训练状态的内存账本:对 5T 模型而言,所有专家的权重、梯度和优化器状态都必须被保存和分片,Top- 并不会让未选中的专家从状态内存中消失。
但 MoE 的关键价值恰恰在于另一件事:一次 token 计算不需要经过全部参数。 因此,“5T 参数模型”同时对应三个不能混用的量:
- 总参数量决定要存储、训练和检查点覆盖多大的模型;
- 单 token 激活参数量描述该 token 实际走过的子网络规模;
- **实际计算量(FLOPs)**则还取决于前向还是训练、上下文长度、注意力、路由、容量填充等运行条件。
本课要把这三个量分开建账。这样后续估算 5T、384 专家、Top-16、128k 上下文模型的训练与 rollout 成本时,不会把“模型有多大”误当成“每个 token 算多少”。
从稠密 FFN 到稀疏专家
在 decoder-only Transformer 中,注意力子层之后通常是一个 FFN/MLP。稠密模型里,每个 token 都通过同一个完整 FFN;若将这个 FFN 复制成许多具有独立权重的专家,再由路由器为每个 token 只选出其中 个,就得到 MoE 层。
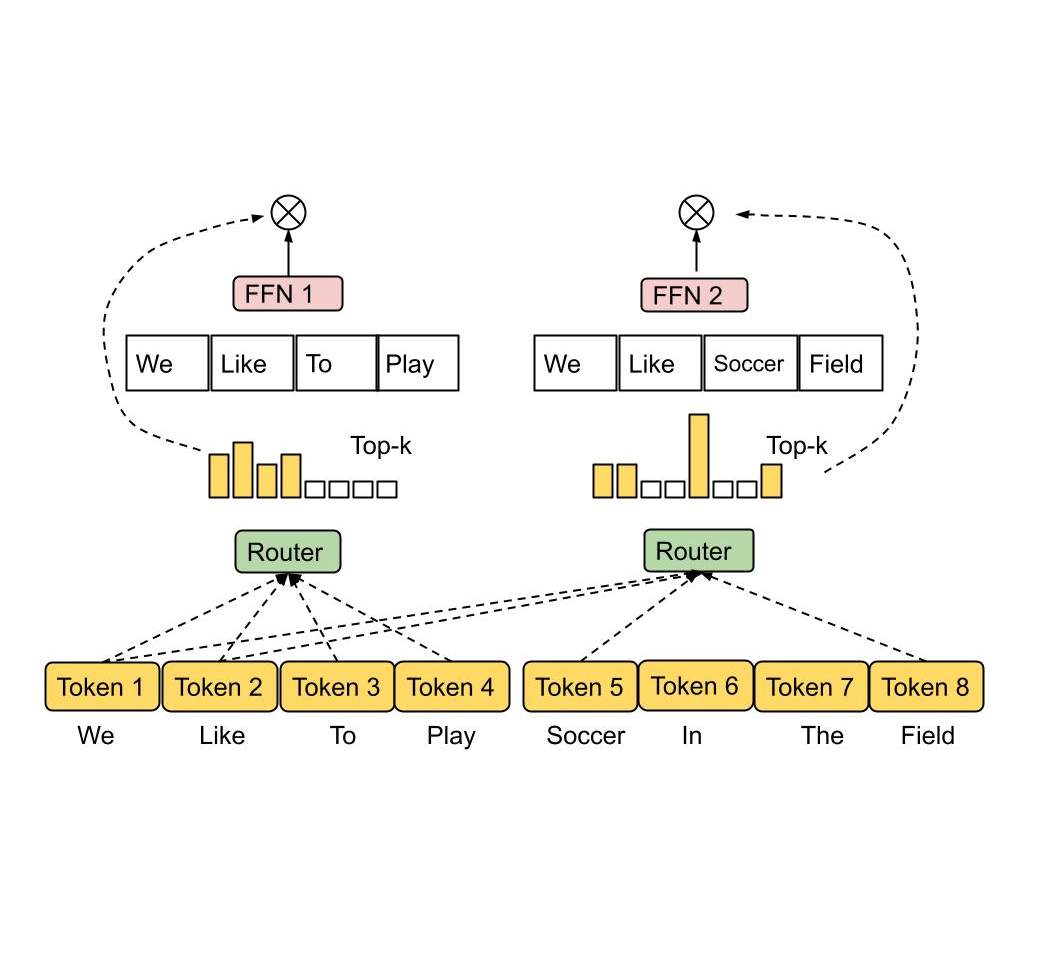
图中最容易误读的地方是:一个专家“没有被这个 token 选中”,并不等于它不存在,也不等于其权重不占 HBM、没有梯度或优化器状态。它只是没有出现在该 token 的执行路径中。
下面的视频先建立这个直觉,再用 Mixtral 的例子区分“加载的全部参数”和“运行时激活的参数”。
A Visual Guide to Mixture of Experts (MoE) in LLMs
观看 Maarten Grootendorst 的《A Visual Guide to Mixture of Experts (MoE) in LLMs》。它用清晰的 Transformer 结构图说明 MoE 替换 FFN 的位置,并用具体模型解释总参数与激活参数为何不同。
先观看 MoE 基本结构:重点确认“专家通常是完整 FFN”,以及每个 token 可走不同专家组合。然后跳到 参数量案例,关注“硬件必须容纳全部权重”与“每次生成只激活其中一部分”之间的区别;不必记住案例中的具体模型数字。
为避免后续公式含糊,先定义三个参数集合:
- :所有 token 都会使用的参数。例如 embedding、注意力投影、归一化参数、router 参数、输出头,以及任何仍保持稠密的 FFN。
- :所有 MoE 专家参数的总和。
- :对 token 而言,被路由选中的专家参数之和。
于是:
而 token 的激活参数量是:
这里的“共享”并不表示这些参数在物理内存中一定与专家放在同一设备,也不表示它们不需要分片;它仅表示从模型执行语义看,每个 token 都会经过它们。
Top-16 在 384 专家模型中意味着什么
先采用最常见的结构假设:每一个 MoE 层有 个等大小专家,每个 token 选择 个专家。设该层每个专家有 个参数,则:
对一个 token,其该层激活的专家参数量为:
因此,专家部分的激活比例为:
这句话的准确含义是:
在专家 FFN 参数部分,一个 token 只经过约 的专家参数。
它不等价于“整个模型只激活 的参数”,因为注意力、router、embedding、输出层和其他非专家部分依然对所有 token 激活。
若各 MoE 层的专家规模相同,令全模型专家参数占比为:
则 Top-16 / 384 模型的单 token 激活参数量可写为:
对目标的 总参数模型:
这个表达式比直接说“5T 模型相当于多少 B 激活参数”更有用,因为当前信息尚未指定共享参数与专家参数的精确占比。
例如,假设专家参数占总参数的 ,即:
则:
单 token 激活参数量为:
这个 是示例架构下的激活参数量,并不是由“5T、384 专家、Top-16”三个数字唯一推导出的模型事实。专家占比、哪些层使用 MoE、专家 FFN 的宽度、attention 的规模,都会改变结果。
可以把三个量暂时放进一张表:
| 量 | 5T、384E、Top-16 中的含义 | 主要用于什么决策 |
|---|---|---|
| 总参数量 | 共享参数加全部 个专家的参数 | 权重、梯度、优化器状态、检查点、全局分片容量 |
| 专家激活比例 | 专家参数部分为 | 稀疏专家 FFN 的计算和 token 分发规模 |
| 单 token 激活参数量 | 共享参数加 16 个被选专家的参数 | 粗略估算每 token 的线性层计算 |
| 实际 FLOPs | 由激活子网、序列长度、注意力、前反向和实现策略共同决定 | 设备数、MFU、吞吐、训练与 rollout 时延 |
一个常见错误是将 乘以 ,直接得出“激活参数为 ”。这只在全部参数都是等规模专家参数、没有任何共享参数时才成立。现实 Transformer 不满足这个条件。
激活参数量为什么不等于实际 FLOPs
参数量是模型的静态属性;FLOPs 是某种具体执行的动态成本。
对于一个线性层:
若单 token 输入向量维度为 ,输出维度为 ,则权重矩阵有:
个参数。一次前向矩阵向量乘通常约需:
FLOPs:每个权重对应一次乘法和一次累加。
若考虑训练中的前向、对输入的反向传播、对权重的反向传播,一个常用的粗略估算是:
因此,对由线性层主导的稠密 Transformer,常见近似为:
其中 是训练 token 数。
MoE 的关键替换是:专家 FFN 不再对每个 token 使用全部专家参数。所以在忽略注意力长度项、路由和其他非主导项时,粗略近似改为:
相应地,单 token 的粗略训练计算为:
而仅做 forward 的 rollout / 推理线性计算可粗略写为:
这两条式子很适合作为容量规划的第一版估算,但不能直接作为 128k 上下文、低带宽 ASIC 上的最终性能模型。原因在于 只计数“经过了哪些权重”,没有表达“这些权重如何被运算”。
下面的论文附录以更严格的方式给出这一层区分:总参数 、激活参数 ,以及由注意力、router、专家和输出层共同形成的 FLOPs 估算。
Parameters vs FLOPs: Scaling Laws for Optimal Sparsity for Mixture-of-Experts Language Models
阅读这篇论文的附录 A 与附录 C。它先给出 total parameters 和 active parameters 的严格定义,再说明为什么 MoE 可以用 6N_aD 作粗略训练 FLOPs 估算,但完整模型仍须补上注意力与路由等成本。
在 Appendix A.1 的 “Total and Active Parameters” 小节,阅读 参数定义,并对照本课的 N_{\mathrm{total}}、N_{\mathrm{shared}} 和 N_{\mathrm{active}}。 接着到 Appendix C 的 “Estimating Mixture-of-Expert (MoE) FLOPs”。从段落 “To estimate the FLOPs of a given MoE model” 开始,读 模块级估算思路,重点看 Attention、Router、Experts 三部分各自增加了什么计算项,以及总公式为什么依赖上下文长度和专家数。 最后阅读小节 “Evaluating 6 Na D as a FLOPs-per-token estimator in MoE Models” 开头的 近似依据。把 6N_aD 理解为模型比较和早期容量估算的近似,不要把它当成端到端执行时间公式。
128k 上下文下必须补上的计算项
对你的目标系统, 尤其不能孤立使用,因为上下文长度高达:
MoE 降低的是专家 FFN 的稠密计算;它不会消除注意力中随序列长度增长的计算。
对一个 Transformer 层,可以用以下定性分解理解单 token 的训练 FLOPs:
其中:
- :QKV、输出投影及其他共享线性层的前反向计算;
- :仅 个专家 FFN 的计算,随 增长;
- :注意力 score 与 value 聚合的计算;对完整序列而言是 ,折算到每 token 是 ;
- :router 要为所有 个专家生成打分,再做 Top- 选择;
- :归一化、激活函数、残差、损失、embedding 和实现相关开销。
这里有两个重要结论。
第一,Top-16 并不让 router 只看 16 个专家。
通常 router 先从 token hidden state 计算出长度为 的专家 logits,再从中选出最高的 16 个。因此:
而专家 FFN 主计算大致随:
增长。由于 通常远大于专家数,router 在很多普通规模模型中不是主导 FLOPs;但它仍会产生路由、排序、token 重排以及后续通信的成本。
第二,长上下文会改变“计算由谁主导”的判断。
在较短上下文中,MoE FFN 常是大头,激活参数量对 FLOPs 的预测效果较好。到 时,注意力的长度相关项迅速增大。即使每个 token 仍只激活 的专家,注意力计算、激活存储和上下文并行通信仍可能成为系统设计的硬约束。
因此,架构评审中不能写:
“本模型是 5T 但只激活约 B,所以计算等于 B 稠密模型。”
更准确的写法应是:
“专家 FFN 的线性计算近似对应 参数规模;完整训练 FLOPs 还应显式加上长上下文注意力、router、输出层及实现相关成本。”
“有用 FLOPs”与“硬件实际执行 FLOPs”还要再分一次
即使已经算出算法层面的 FLOPs,硬件上真实执行的计算量仍可能不同。
设某个 microbatch 中参与 MoE 层的 token 数为 。如果每个 token 的 16 个专家选择都成功被接收,那么该层理想的 token-expert assignment 数为:
这描述的是有用的专家调用数量。但工程执行中还会受到容量和张量布局影响:
- 某些专家收到过多 token,需要填充到固定容量,导致实际 Grouped GEMM 计算的 token 槽位多于有效 token;
- 某些实现会因容量不足丢弃 assignment,导致实际专家计算少于理想的 ;
- 专家负载不均会让少数专家的 GEMM 更大、更慢,其余设备等待;
- token 重排与 All-to-All 通信本身几乎不增加主算术 FLOPs,却可能决定端到端时延;
- 小而不均匀的专家 GEMM 即使 FLOPs 总量不大,也可能无法接近 ASIC 的峰值矩阵吞吐。
所以建议在性能文档中固定维护四个层次的指标:
| 层次 | 建议指标 | 回答的问题 |
|---|---|---|
| 模型容量 | 全部训练状态、权重发布和检查点有多大? | |
| 稀疏执行语义 | 、 | 单 token 经过多大的子网络? |
| 算法计算 | 理论 forward / training FLOPs | 理想计算需求是多少? |
| 硬件执行 | 实际 GEMM FLOPs、padding、空泡、通信时间 | ASIC 上真实耗时为何与理论不同? |
对训练池,重点会落在:
对 rollout 池,重点通常是:
但 rollout 还要额外考虑 KV Cache、生成序列长度和专家并行通信。训练与 rollout 虽然都使用 MoE,却不能因为它们拥有同一总参数量,就套用同一个吞吐模型。
用于 5T MoE 设计文档的最小参数账本
从现在开始,模型配置或性能评审中至少应同时出现以下字段:
| 字段 | 当前目标模型应填写的内容 |
|---|---|
| 约 ,包含共享参数和全部专家 | |
| 专家数 | ,需明确是每 MoE 层的专家数还是全局专家池规模 |
| Top- | |
| 专家激活比例 | |
| 由层数、attention 形状、MoE 层比例、词表和非 MoE 层结构推导 | |
| 全部专家 FFN 参数,决定主要稀疏状态容量 | |
| ,等专家时成立 | |
| FLOPs 近似 | 先用 作为粗估,再补长上下文注意力与 router 项 |
| 执行修正项 | 容量填充、丢弃、专家负载、Grouped GEMM 效率、All-to-All 时间 |
其中最值得在跨团队沟通中反复强调的一句是:
总参数量决定容量与状态;激活参数量决定稀疏主计算的第一阶规模;实际执行时间还由注意力长度、路由分布、通信与算子效率决定。
小结
本课建立了 MoE 的三个不同量纲:
对于等大小的 专家、Top-16 MoE 层:
关键结论是:
- 是全部参数的模型容量,决定训练状态、检查点和权重发布的规模。
- Top-16 / 384 只说明每个 token 使用约 的专家参数;完整模型的激活比例还必须加上共享参数。
- 是估算 MoE 训练主计算的有用近似,而不是完整的运行时间模型。
- 对 上下文,注意力的长度相关计算不能忽略;MoE 稀疏性不会让长上下文注意力自动变便宜。
- 硬件实际成本还会受到容量填充、专家负载倾斜、Grouped GEMM 效率和 All-to-All 通信的影响。
下一课会把这套参数量区分进一步变成可代入架构配置的公式:估算训练前向、反向、优化器更新以及通信阶段的 FLOPs、访存量和算术强度。