你好。上一课建立了计算、HBM 与网络三本账:我们已经能区分有效 FLOPs、实际执行 FLOPs、HBM 字节和 MoE All-to-All payload。现在要把这些“工作量”转成系统是否达标的判断:单位时间完成多少有效 token、一次迭代为什么慢、加卡是否真的带来近似线性的收益,以及低 MFU 究竟是计算核、内存、通信还是负载不均的问题。
这一课的指标将直接成为后续 8 卡/64 卡验证、千卡外推和跨团队性能需求的共同语言。关键原则是:所有指标都必须先固定口径,再讨论数值好坏。
先固定测量边界:指标回答的是哪一个问题?
一次训练 step 并不是单纯的前向加反向。对 MoE 训练而言,它通常包含:数据就绪、参数物化或通信、前向、路由与 token 重排、专家 All-to-All、反向、梯度通信、优化器更新,以及可能的重算与检查点工作。
从关键路径看,可以把 step 时间概念化为:
这不是严格的可直接相加公式,因为通信和计算可能重叠。例如某个梯度 AllReduce 运行 ,若其中 被后续 GEMM 覆盖,它对关键路径只贡献约 。因此,性能报告必须区分:
- 原始通信时间:通信 stream 实际忙了多久;
- 暴露通信时间:通信未被计算覆盖、真正推迟下一依赖操作的时间;
- 端到端 step 时间:从一个训练 step 的开始边界到下一个 step 可开始的时间;
- 尾部 rank 时间:最慢 rank 的完成时间,而不是全体 rank 的平均时间。
对你的目标平台,建议从一开始就固定以下测量协议:
- 预热后测量:排除编译、缓存填充、权重首次加载和通信组初始化。
- 连续窗口:记录至少几十到数百个稳定 step;不要只取最快的一步。
- 取有效 token:吞吐的分子应是有效训练 token,不是 padding token,也不是 Top- 后的 token-expert assignment。
- 记录版本与配置:模型形状、精度、重算策略、并行维度、容量因子、EP group、通信库版本和编译模式必须随指标保存。
- 同时记录均值与尾部:平均 step time 反映产能;p95/p99 反映长尾、路由热点和不稳定通信。
后续不论是训练池还是 rollout 池,都应以独立资源池分别计量;不要把两个池子的 token 吞吐混成一个“集群吞吐”数字。
吞吐与时延:同一个系统的两个视角
吞吐:单位时间完成多少有用工作
训练中最常用的吞吐定义是有效 token 吞吐:
其中 是一个 step 内全局有效 token 数。若全局 batch 中有 padding,或部分序列被 mask,分子应排除这些不产生有效训练信号的 token。
对于稳定 shape 的训练,常写为:
但要明确 是实际有效长度、固定 packing 长度,还是最大长度。对 长上下文训练,这三者的差异可以非常大。
MoE 中还有一个容易被误用的量:
它表示 token-expert assignment 数。对于 Top-,每个有效 token 对应 个专家 assignment。该指标适合衡量 router、All-to-All 与 Grouped GEMM 的压力,但它不能代替训练 token 吞吐。否则不同 Top- 配置之间会得到误导性的比较。
吞吐适合回答:
- 在固定训练语义下,一天能消耗多少有效 token?
- 给定目标训练 token 数,需要多少设备日?
- rollout 池能否以足够速率供给训练池?
- 某项优化是否提高了稳态产能?
时延:一个工作单元要等多久
训练中最实用的时延通常是 step latency:
还应至少记录:
平均吞吐高不代表系统稳定。例如,某 MoE 配置平均 step time 为 ,但 p99 为 ,常意味着某些 batch 出现专家倾斜、All-to-All 拥塞、编译回退或数据等待。对持续运行的异步 RL 系统,这种尾部会进一步转化为队列堆积和策略样本陈旧度。
吞吐与时延不总是同方向变化。增大 sequence length、增加 microbatch 或提高梯度累积,往往会使单个 step 更慢,却可能提高 token 吞吐,因为每次 step 完成了更多有效工作,且 GEMM 形状和专家权重复用更好。
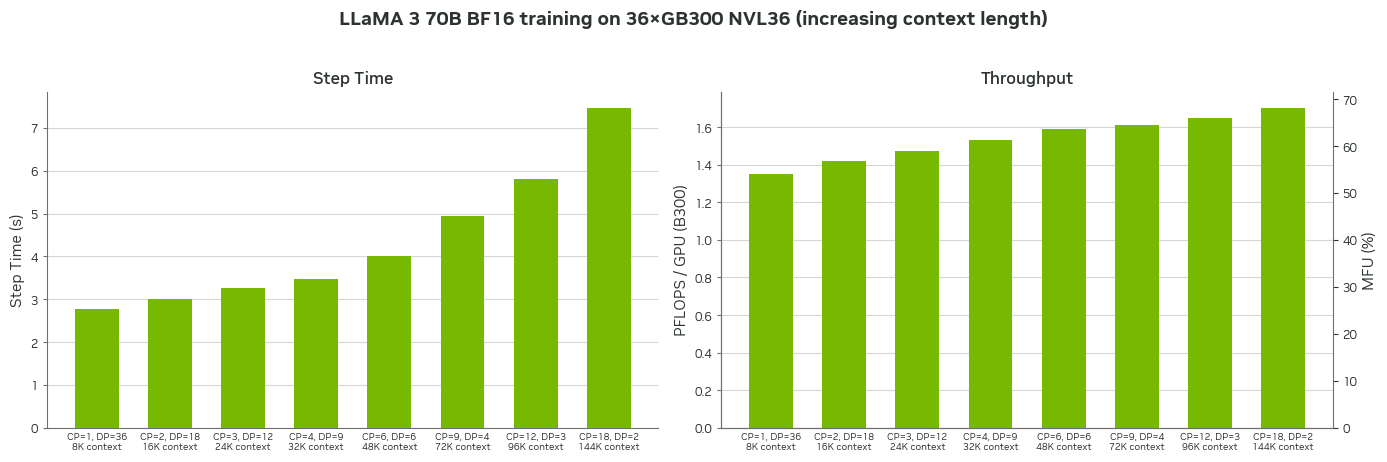
这张图也说明一个重要的测量纪律:它是在固定设备数量、改变上下文长度的条件下比较性能,因此反映的是工作负载形状变化,不是扩展效率。不能因为 MFU 上升,就宣称“扩展性提高”。
扩展效率:加设备后,额外资源是否转化为产能?
扩展效率必须首先区分两种实验。
强扩展:总工作量固定
强扩展保持模型、全局 batch、有效 token 数和算法语义不变,只增加设备数。设基线使用 张卡、耗时 ;新方案使用 张卡、耗时 。则加速比为:
理想情况下,设备数增加 倍,时间应缩短同样倍数。强扩展效率为:
例如,在相同全局 batch 下:
扩展到:
则:
设备数量增加了 倍,但只获得 倍加速:
这 的损失可能来自更小的每卡 microbatch、GEMM 效率下降、通信增加、流水线气泡、MoE All-to-All 尾部,或运行时开销。强扩展实验特别容易暴露这些问题。
弱扩展:每设备工作量固定
弱扩展时,每台设备承担的局部工作量保持不变;随着设备数增加,总 batch 和全局 token 数同步增长。理想状态下,step time 不应明显增加:
相对弱扩展效率可定义为:
弱扩展适合回答:“如果集群规模扩大,系统能否保持每卡近似相同的生产率?”这对千卡、万卡吞吐外推尤其重要。
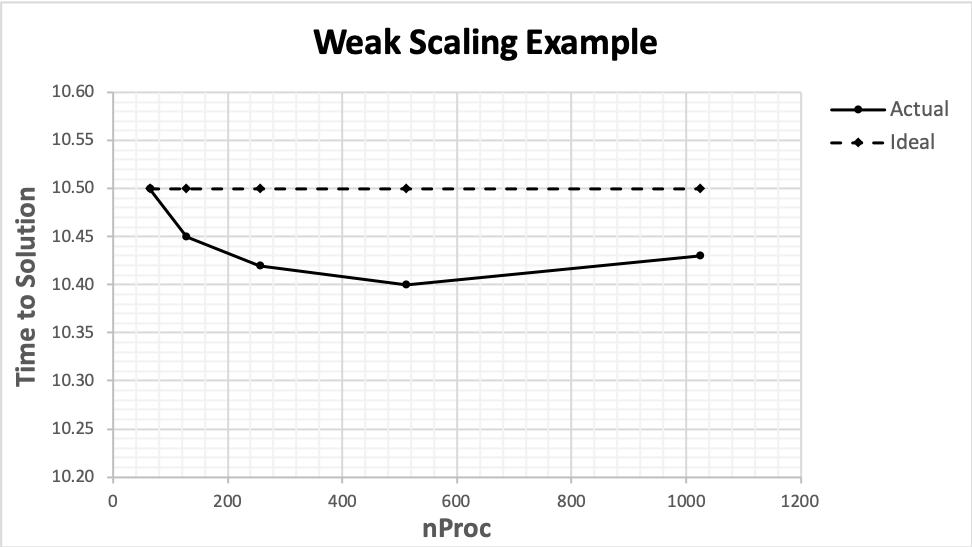
实际曲线偶尔低于基线并不一定表示“超线性扩展”;可能是缓存、任务划分、测量噪声或不同系统状态造成的。工程上最重要的是观察规模增大后是否出现持续性恶化,以及恶化从哪个通信组规模开始。
不能混用的比较
以下变化会让“扩展效率”失去可比性:
- 改变全局 batch、训练 token 数或梯度累积;
- 改变精度,例如 BF16 改为 FP8;
- 改变 activation checkpoint 策略;
- 改变专家容量因子、token 丢弃策略或路由器配置;
- 改变并行拓扑,例如 EP 从 box 内变成跨 box;
- 将编译时间、首次权重加载时间混入一组但未混入另一组。
这些变化仍可比较端到端吞吐,但不应标记为纯粹的 scaling result。
MFU 与 HFU:把工作量、时间和峰值算力接起来
上一课中,模型 FLOPs 与实际执行 FLOPs 已经分开建账。这一区分正是 MFU 与 HFU 的基础。
Stanford CS231N | Spring 2025 | Lecture 11: Large Scale Distributed Training
观看 Stanford Online 的《Stanford CS231N | Spring 2025 | Lecture 11: Large Scale Distributed Training》。这一段把 MFU 放在分布式训练的整体决策中,说明它为什么是有用但不充分的性能指标。
观看 Section 6,从 MFU 与策略选择 这一完整片段开始。重点关注 MFU 的分子、分母,以及为何模型规模、并行方案与激活检查点都会改变最终利用率。
MFU:完成模型所需计算的速率
定义:
- :一次训练 iteration 在算法上需要完成的模型 FLOPs;
- :参与训练的加速器数量;
- :每台设备在实际精度模式下的理论峰值 FLOPs/s;
- :端到端训练 step 时间。
则模型 FLOPs 利用率为:
MFU 的分子是“模型为完成一次正常前向和反向,理论上需要的 FLOPs”。它应尽量不受硬件和实现影响。因此,若一个模型因为保存不足而重算激活,MFU 的分子通常不因为重算而增加。
对 MoE,必须在 MFU 定义中写清楚:
- MoE expert FLOPs 是否按 Top- 的有效 assignment 统计;
- 是否排除因 fixed capacity 带来的 padding FLOPs;
- 是否将 router、attention、共享层和 logits head 纳入;
- causal attention 是否按实际 kernel 的三角计算量定义;
- 使用的 是 BF16、FP8,还是混合精度峰值。
否则“MFU = 45%”没有工程解释力。
HFU:硬件实际被要求执行了多少 FLOPs
设:
表示硬件在一个 iteration 中实际执行的 FLOPs。它可包含 activation recomputation、padding 造成的额外 GEMM 行,或其他实现导致的额外计算。硬件 FLOPs 利用率为:
当额外执行工作主要来自重算时:
因此,若:
则通常有:
HFU 更高不必然更好。它可能意味着硬件矩阵单元很忙,但其中一部分时间花在了重算或容量 padding 上,而不是推进有效训练工作。对训练任务的总完工时间和成本,MFU 往往更直接;对 kernel 和执行引擎的硬件占用情况,HFU 提供补充信息。
[2205.05198] Reducing Activation Recomputation in Large Transformer Models
阅读论文第 6.3 节 “End-to-End Iteration Time”。作者将 model FLOPs 与实际 hardware FLOPs 明确分开,并用同一组实验的 iteration time、throughput、MFU 和 HFU 展示它们的关系。
在第 6.3 节中,从 “We define the model FLOPs utilization” 开始,读到紧接表格讨论之前的 “Both the MFU and HFU are provided in Table”。阅读 指标定义 时,特别区分“由模型决定的 FLOPs”和“由重算等实现选择造成的实际 FLOPs”;再查看 Table 5,比较相同模型规模下 iteration time、throughput、MFU 与 HFU 如何共同变化。
一个统一算例
假设某个 卡训练配置中:
设备在目标 BF16 模式下的峰值为:
稳定测得:
则:
若 checkpoint 重算和 fixed-capacity padding 使实际执行 FLOPs 变为:
则:
此时不能简单得出“48.8% 比 39.1% 更好”。合理结论是:
- 硬件实际矩阵计算的占用较 MFU 所示更高;
- 约四分之一的模型 FLOPs 等价工作来自额外执行;
- 若减少重算或 padding 而不增加 step time,HFU 可能下降,但 MFU 与有效 token 吞吐反而上升。
通信占比:应报告“暴露在关键路径上的通信”
“通信占比”常被误写成“通信 kernel 时间之和 / step time”。这个做法在存在重叠时会严重误导。
定义最有决策价值的量:
其中:
是在关键路径上、未被计算覆盖的通信等待时间。
对于一个 MoE step,建议单独记录至少以下类别:
| 通信类别 | 常见来源 | 需要关注的问题 |
|---|---|---|
| AllGather / ReduceScatter | FSDP、参数分片、梯度分片 | 是否跨越慢链路,能否与 GEMM 重叠 |
| AllReduce | 数据并行梯度同步、某些 TP 操作 | bucket 是否过小,是否等待最慢 rank |
| All-to-All | MoE dispatch 与 combine | 是否被定长容量填充放大,是否有热点目的 rank |
| P2P | 流水线阶段传输 | 是否造成阶段间等待和气泡 |
| 元数据或同步通信 | router 计数、barrier、控制面 | 小消息延迟是否频繁出现 |
MoE 的 All-to-All 尤其不能只看“通信字节总量”。相同总 payload 下,以下因素都会改变暴露时间:
- 目的 rank 分布:路由集中会使少数 rank 接收大量 token;
- 定长 whole-group 限制:为满足固定 buffer 形状而填充的槽位会增加实际传输;
- EP group 跨越范围:box 内、box 间、跨机的带宽与延迟可能相差数量级;
- 专家计算尾部:即使通信结束,最忙专家的 Grouped GEMM 仍可能阻塞返回 All-to-All;
- 重叠位置:通信若开始得太晚,即使链路带宽很高,也来不及被后续计算覆盖。
因此,通信报告至少应包含三层,而不只是一个百分比:
还应同时给出跨 rank 的最大值、平均值和 p95。对同步训练而言,决定 step 完成时间的是最慢 rank,而不是平均 rank。
如何解读一组指标,而不是孤立追求一个数字
设一个 64 卡 MoE 训练配置测得:
| 指标 | 测量值 |
|---|---|
| 有效训练 token 吞吐 | tokens/s |
| 平均 step time | |
| p95 step time | |
| MFU | |
| HFU | |
| 暴露通信占比 | |
| All-to-All 暴露时间占比 | |
| 强扩展效率,相对 8 卡 |
一份有用的诊断不会停在“MFU 偏低”。它应沿着因果链展开:
- MFU 与 HFU 存在明显差距:优先核查 activation recomputation、容量 padding 和碎片化 Grouped GEMM。
- All-to-All 是主要暴露通信:优先查看专家负载、EP group 的物理放置、定长通信填充和通信计算重叠。
- p95 明显高于平均值:不能只做平均带宽优化;还要定位热点专家、慢节点或偶发编译/内存分配事件。
- 强扩展效率只有 :应比较 8、16、32、64 卡下每卡 token 数、GEMM shape、每层通信时间与 bubble,定位效率首次明显下降的规模点。
- 吞吐满足目标但通信占比高:不应立即重构系统;先判断通信是否限制未来扩展,或是否会在更长序列、更大 EP group 下成为瓶颈。
反过来,低 MFU 并不自动等于矩阵核性能差。它也可能意味着:
- 算子被 HBM 带宽限制;
- FSDP/TP/EP 通信没有隐藏;
- pipeline bubble 较大;
- 专家路由不均衡;
- 小 microbatch 导致专家 GEMM 过碎;
- 图编译、动态 shape 或 kernel launch 开销过高;
- step 边界包含了数据等待、同步或内存分配。
这正是为什么指标必须和时间线、通信 profile、专家 token 分布一起看。
建议的最小性能记分卡
从 8 卡 demo 开始,每一种候选配置都应产出同一份记分卡:
| 类别 | 最小字段 |
|---|---|
| 工作负载 | 模型版本、、有效 token、序列长度、Top-、容量因子、精度 |
| 产能 | 有效 tokens/s、steps/s、每设备 tokens/s |
| 时延 | mean、p50、p95、p99 step time |
| 扩展 | 基线规模、强/弱扩展定义、speedup、效率 |
| 计算利用 | 、、MFU、HFU、峰值算力口径 |
| 通信 | 各 collective 的 payload、耗时、有效带宽、暴露通信占比 |
| MoE 健康度 | 每专家 token 的 min/median/max、容量利用率、丢弃或 padding 比例 |
| 资源健康度 | HBM 峰值、OOM 次数、链路错误、编译回退、慢 rank 标识 |
这张表的价值不在于一次填满,而在于每次算子、并行或通信改动后都能做前后对比,并明确说明:优化改善了哪个指标,代价又转移到了哪里。
小结
本课建立了训练系统指标之间的关系:
- 吞吐衡量有效工作完成速度:
- 时延衡量单个 step 的关键路径,并应同时看均值与尾部。
- 强扩展效率检验固定总工作量时加卡是否近似线性:
- 弱扩展效率检验设备变多后、每卡工作量不变时 step time 是否保持稳定。
- MFU衡量模型所需 FLOPs 相对设备理论峰值的实现程度;HFU进一步计入重算、padding 等实际执行的 FLOPs:
- 通信占比应优先报告未被重叠隐藏、真正位于关键路径上的通信时间,而不是所有通信 kernel 时间的简单求和。
下一课会把这些指标应用到你的目标约束:将 总参数、 个专家、Top-、 上下文、BF16/FP8 和独立异步 rollout 池,转化为可验证的内存、吞吐、通信与版本同步约束。