Bonjour et bienvenue dans cette nouvelle leçon !
Dans la leçon précédente, nous avons appris à jouer les détectives en utilisant EXPLAIN pour analyser les plans d'exécution SQL. Nous avons découvert que l'un des pires coupables pour des requêtes lentes est le fameux "scan de table complet" (Seq Scan ou type: ALL), où la base de données est forcée de lire une table entière.
Aujourd'hui, nous passons de la phase de diagnostic à la phase de traitement. L'objectif de cette leçon est de vous apprendre à mettre en place des index de base de données pour accélérer radicalement vos recherches. Nous allons voir ce que sont les index, leurs différents types, leurs avantages et inconvénients, et surtout, comment les implémenter concrètement dans un projet Spring Boot avec JPA.
C'est une compétence fondamentale qui transforme la performance d'une application, et nous allons la rendre directement applicable à votre travail quotidien.
1. Qu'est-ce qu'un index et comment fonctionne-t-il ?
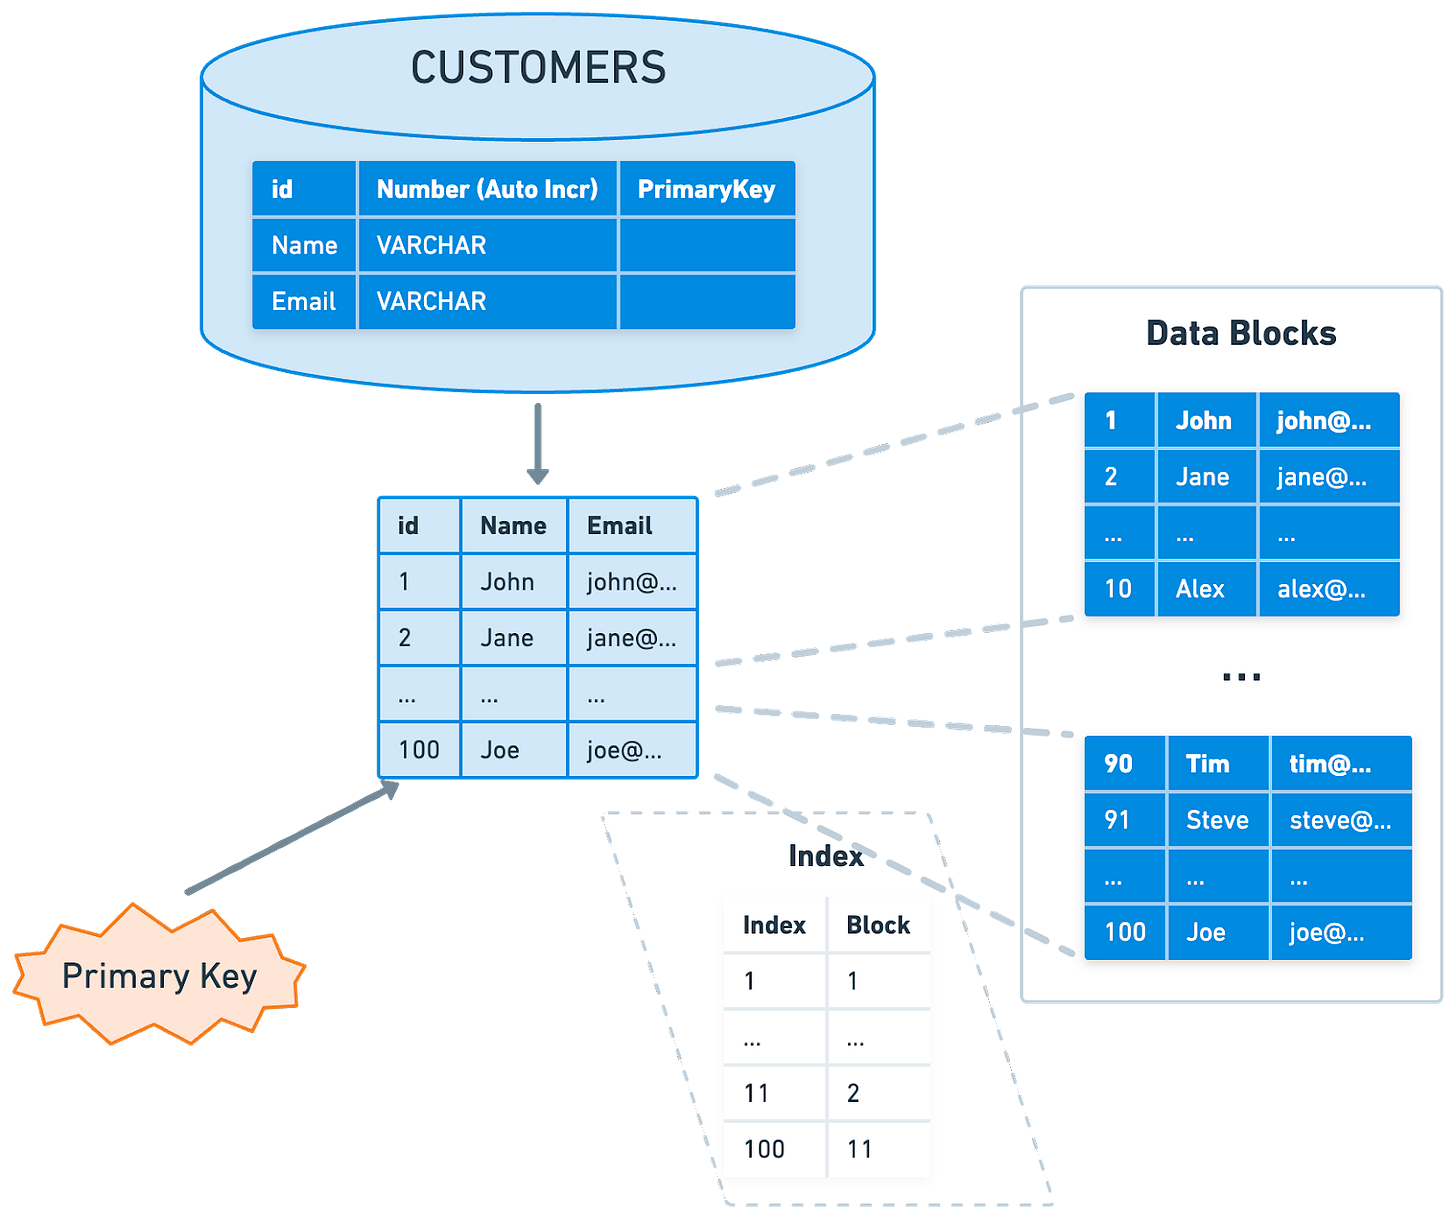
Un index de base de données est une structure de données qui améliore la vitesse des opérations de récupération de données sur une table, au prix d'un ralentissement des écritures et d'un espace de stockage supplémentaire.
L'analogie la plus simple est l'index alphabétique à la fin d'un livre : au lieu de feuilleter toutes les pages pour trouver un sujet, vous allez directement à l'index, trouvez le sujet, et obtenez le numéro de page exact. Un index de base de données fonctionne sur le même principe.
Pour une explication simple et visuelle, la vidéo suivante montre la différence entre une recherche sans index et une recherche avec index.
Optimisation base de données #01: Qu'est ce qu'un index de base de données
Cette courte vidéo de 'coursaline' explique de manière très concrète l'intérêt des index en comparant une recherche séquentielle (sans index) à une recherche dichotomique (avec index).
Regardez la vidéo du début jusqu'à 03:04. Concentrez-vous sur : La raison d'être des index : éviter de parcourir tous les enregistrements. L'exemple pratique qui compare le nombre d'opérations nécessaires avec et sans index. La définition de l'index comme une structure de données triée pointant vers les enregistrements de la table.
La structure de données la plus couramment utilisée pour les index est l'arbre-B (B-tree). Il s'agit d'une structure en arbre auto-équilibrée qui maintient les données triées et permet des recherches, des accès séquentiels, des insertions et des suppressions en temps logarithmique. C'est ce qui permet à la base de données de "zoomer" très rapidement sur les données dont elle a besoin.
Le compromis de l'indexation
Les index ne sont pas une solution magique sans contrepartie. Il est crucial de comprendre leur coût :
- Performance en écriture : Chaque
INSERT,UPDATEouDELETEsur une colonne indexée oblige la base de données à mettre également à jour l'index. Cela ralentit les opérations d'écriture. - Espace de stockage : Un index est une structure de données supplémentaire qui consomme de l'espace disque.
La règle est donc d'indexer judicieusement : on indexe les colonnes fréquemment utilisées dans les clauses WHERE, JOIN et ORDER BY pour des lectures rapides, mais on évite de sur-indexer des tables avec de très nombreuses écritures.
Database indexing basics: how indexes make queries faster
Pour approfondir ce concept de compromis et les bases du fonctionnement, l'article suivant de Upsun est très clair.
Lisez les sections "What is database indexing, and how does it work?" et "Why do we need database indexing?". Portez une attention particulière au paragraphe qui commence par "While indexes significantly improve read performance, they come with a trade-off."
2. Les principaux types d'index
Il existe plusieurs façons de créer des index pour répondre à différents besoins de requêtage. La vidéo suivante, par un DBA expérimenté, présente une excellente vue d'ensemble des stratégies d'indexation modernes.
Vos requêtes SQL jusqu'à 10000 fois plus rapides, durablement. - Alain LESAGE (DALIBO)
Dans cette présentation de Devoxx France, Alain Lesage détaille les différentes manières de créer des index et les types d'index avancés disponibles dans des bases de données comme PostgreSQL. C'est une vision professionnelle et approfondie.
Regardez attentivement la section de 12:48 à 18:10. Elle couvre des concepts très importants : L'index multicolonne : retenez l'astuce de placer en premier la colonne la plus sélective (celle qui élimine le plus de lignes). L'index partiel : très puissant pour n'indexer qu'un sous-ensemble de vos données (ex: les commandes actives). L'index avec INCLUDE : pour favoriser les Index Only Scan en incluant des données directement dans l'index. L'index fonctionnel : indispensable quand vos requêtes utilisent des fonctions (ex: LOWER(email)). Les différents types d'index au-delà du B-tree (BRIN, GIN, GIST) pour des cas d'usage spécifiques.
Pour résumer et organiser ces idées, voici les index que vous utiliserez le plus souvent :
-
Index sur une seule colonne : Le plus simple.
CREATE INDEX idx_users_email ON users(email);. Parfait pour les requêtes qui filtrent sur une seule colonne, commeWHERE email = ?. -
Index composite (multicolonne) : Essentiel pour les requêtes qui filtrent sur plusieurs colonnes.
CREATE INDEX idx_products_category_price ON products(category_id, price);.- L'ordre des colonnes est crucial ! Un index sur
(A, B)peut être utilisé pour une recherche surAou sur(A, B), mais pas efficacement pour une recherche surBseul. La règle générale est de placer la colonne la plus sélective (celle avec le plus de valeurs distinctes, comme unid) en premier.
- L'ordre des colonnes est crucial ! Un index sur
-
Index unique : Similaire à un index normal, mais il garantit en plus que toutes les valeurs dans la colonne (ou la combinaison de colonnes) sont uniques.
CREATE UNIQUE INDEX uidx_users_email ON users(email);. Les clés primaires (PRIMARY KEY) sont automatiquement soutenues par un index unique.
3. Mise en pratique : créer des index avec JPA
Maintenant, appliquons ces connaissances dans notre environnement Spring Boot. Bien que vous puissiez créer des index manuellement avec du SQL (ce qui est souvent fait via des outils de migration comme Flyway ou Liquibase), JPA vous permet de les déclarer directement dans votre code d'entité. C'est très pratique pour le développement et pour s'assurer que le schéma de la base de données et le code restent synchronisés.
L'annotation clé est @Index, utilisée à l'intérieur de l'annotation @Table.
L'article suivant de Baeldung est la référence parfaite pour cela. Nous allons le parcourir pour implémenter les types d'index les plus courants.
Defining Indexes in JPA | Baeldung
Cet article de Baeldung est votre guide pratique pour définir des index directement depuis vos entités JPA. Il est concis et montre des exemples de code clairs.
Lisez les sections 2 et 3 de l'article (jusqu'à la 3.5). Elles vous montreront comment déclarer des index sur vos entités. Concentrez-vous sur la syntaxe pour : Déclarer un premier index simple (section 3). Créer un index multicolonne (section 3.2). Créer un index unique (section 3.4). Déclarer plusieurs index sur une même entité (section 3.5).
Exemple concret
Imaginons que nous ayons une entité Product et que nous exécutions souvent les requêtes suivantes :
SELECT * FROM product WHERE sku = ?SELECT * FROM product WHERE category = ? AND in_stock = true
Sans index, ces requêtes provoqueraient des scans complets de la table product à mesure qu'elle grandit. Voici comment nous pouvons déclarer les index appropriés avec JPA :
import jakarta.persistence.*;

@Entity
@Table(name = "products", indexes = {
    // Index unique pour les recherches rapides par SKU
    @Index(name = "uidx_product_sku", columnList = "sku", unique = true),

    // Index composite pour les recherches par catégorie et disponibilité
    @Index(name = "idx_product_category_stock", columnList = "category, in_stock")
})
public class Product {

    @Id
    @GeneratedValue
    private Long id;

    @Column(nullable = false, unique = true)
    private String sku; // Stock Keeping Unit

    @Column(nullable = false)
    private String name;

    private String category;

    private boolean in_stock;

    // Getters et Setters...
}
Analyse de cet exemple :
@Table(name = "products", indexes = { ... }): Nous déclarons nos index dans l'annotation@Table.@Index(name = "uidx_product_sku", columnList = "sku", unique = true):- Nous créons un index unique sur la colonne
sku. name: Donne un nom explicite à notre index dans la base de données.columnList: Spécifie la ou les colonnes à inclure.unique = true: Assure l'unicité et optimise les recherches d'égalité.
- Nous créons un index unique sur la colonne
@Index(name = "idx_product_category_stock", columnList = "category, in_stock"):- Nous créons un index composite sur
categoryetin_stock. - L'ordre est important. En plaçant
categoryen premier, cet index sera efficace pour les recherches surcategoryseule, et très efficace pour les recherches surcategoryETin_stock.
- Nous créons un index composite sur
Lorsque Hibernate générera le schéma (ou lorsque vous utiliserez un outil pour comparer votre entité au schéma), il produira des instructions SQL comme CREATE UNIQUE INDEX uidx_product_sku ON products (sku).
Conclusion
Félicitations ! Vous avez maintenant une compétence essentielle pour garantir la performance et la scalabilité de vos applications. Vous ne vous contentez plus de subir la lenteur, vous pouvez la diagnostiquer et la résoudre à la source.
Points clés à retenir :
- Les index accélèrent les lectures (
SELECT) en évitant les scans de table complets, mais ralentissent les écritures (INSERT,UPDATE,DELETE) et consomment de l'espace. - Le choix de l'index (simple, composite) et l'ordre des colonnes dans un index composite doivent correspondre aux requêtes que vous cherchez à optimiser.
- N'oubliez pas les cas plus avancés comme les index fonctionnels (
LOWER(column)) ou partiels (WHERE status='active') pour des optimisations ciblées. - Dans l'écosystème Spring Boot/JPA, l'annotation
@Indexau sein de@Tableest le moyen le plus direct et déclaratif pour gérer vos index au niveau du code.
Prochaine étape :
Nous avons poussé l'optimisation de nos requêtes au maximum en nous assurant que la base de données y répond le plus vite possible. Mais que se passerait-il si, pour les données les plus fréquemment consultées, nous n'avions même pas besoin de solliciter la base de données ? C'est le rôle de la mise en cache.
Dans la prochaine leçon, nous préparerons le terrain pour le caching en apprenant à exécuter une instance Redis avec Docker pour le développement local. Nous découvrirons ce qu'est Redis et pourquoi il est si populaire comme solution de cache.