Bonjour !
Dans la leçon précédente, nous avons déployé avec succès notre application sur une plateforme PaaS. Elle est désormais accessible sur Internet, connectée à sa base de données, et se met à jour automatiquement à chaque git push. C'est une réussite majeure ! Cependant, une fois en production, notre application devient une sorte de boîte noire. Si un utilisateur rencontre une erreur, comment la diagnostiquer ? Comment savoir si l'application est performante ou si elle est sur le point de tomber en panne ?
Cette leçon répond à ces questions en introduisant le concept d'observabilité. L'objectif est de rendre notre application "transparente" pour que nous puissions comprendre son état interne à tout moment. Nous allons configurer la journalisation (logging) structurée et le monitoring de base, des compétences indispensables pour tout développeur professionnel qui gère des applications en production.
Introduction à l'Observabilité
L'observabilité est généralement décrite à travers trois piliers :
- Les Logs (Journaux) : Des enregistrements d'événements qui se sont produits dans l'application. C'est le "quoi ?".
- Les Métriques (Metrics) : Des mesures numériques sur une période donnée (ex: utilisation du CPU, nombre de requêtes par seconde). C'est le "combien ?".
- Les Traces (Traces) : Le parcours d'une requête à travers les différents services d'une architecture distribuée. C'est le "où et comment ?".
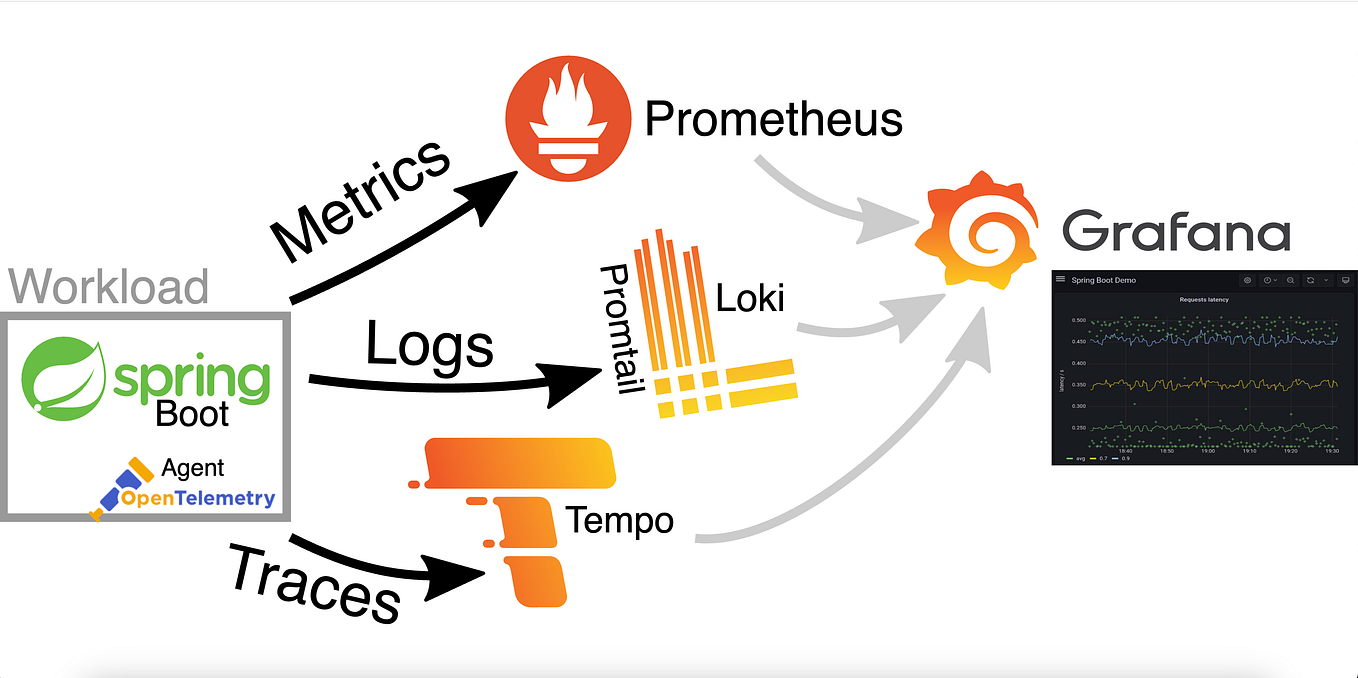
Aujourd'hui, nous nous concentrerons sur les deux premiers piliers : les logs et les métriques, qui constituent la base du monitoring.
1. Les Fondations : Niveaux de Log et Actuator
Avant de plonger dans la configuration, comprenons pourquoi et comment utiliser les logs efficacement.
Pourquoi et quand utiliser les logs ?
Les logs ne sont pas seulement utiles en production. Ils ont un rôle à chaque étape du cycle de vie de l'application.
Bonnes pratiques de logging | Java & Moi
L'article "Bonnes pratiques de logging" sur Java & Moi explique parfaitement l'utilité des logs. Il pose les bases théoriques nécessaires avant de passer à la pratique.
Lisez les sections "Objectifs des logs" et "De l’importance du niveau de log". Concentrez-vous sur la distinction de l'usage des logs en développement, en intégration et en production, ainsi que sur le tableau décrivant les 5 niveaux de log (TRACE, DEBUG, INFO, WARN, ERROR).
Comme vous l'avez vu, configurer le bon niveau de log pour le bon environnement est crucial. En développement, on peut être très verbeux (DEBUG), mais en production, on se concentre sur l'essentiel (INFO et plus) pour ne pas noyer les informations importantes et maîtriser les coûts de stockage.
Dans Spring Boot, on configure cela très simplement dans les fichiers application.properties. Pour un profil de production (prod), on pourrait avoir un fichier application-prod.properties avec :
# logging.level.root=WARN
# logging.level.com.example.myapp=INFO
Cela définit le niveau par défaut à WARN pour toutes les bibliothèques externes, mais garde nos logs applicatifs à INFO pour suivre les événements métiers importants.
Monitoring de base avec Spring Boot Actuator
Pour le pilier des métriques, Spring Boot nous offre un outil surpuissant : Actuator. En ajoutant simplement une dépendance à notre projet, Actuator expose une série d'endpoints REST qui fournissent des informations vitales sur la santé et les métriques de l'application (utilisation mémoire, CPU, détails de la JVM, etc.).
<dependency>
    <groupId>org.springframework.boot</groupId>
    <artifactId>spring-boot-starter-actuator</artifactId>
</dependency>
Ces endpoints sont la source de données pour des outils de monitoring comme Prometheus.
2. Le cœur du sujet : La Journalisation Structurée (JSON)
Les logs en texte brut, bien que lisibles par un humain, sont un cauchemar pour les machines.
INFO 12345 --- [main] com.example.MyApp: User 123 registered successfully.
Comment une machine peut-elle facilement extraire le niveau (INFO), le nom de la classe, ou l'ID de l'utilisateur (123) ? C'est difficile et peu fiable.
La solution est la journalisation structurée, où chaque log est un objet JSON.
{
  "timestamp": "2023-10-27T10:00:00.000Z",
  "level": "INFO",
  "thread": "main",
  "logger": "com.example.MyApp",
  "message": "User registered successfully",
  "userId": 123
}
C'est instantanément parsable, interrogeable et analysable par des systèmes de centralisation de logs.
Pour y parvenir dans Spring Boot, nous allons créer un fichier logback-spring.xml dans notre dossier src/main/resources pour prendre le contrôle total du formatage de nos logs.
1h Spring Boot Logging Crash Course For Beginners (Config, Remote Logs, JSON Logging & More)
Cette vidéo de Philipp Lackner (en anglais) est un cours intensif extrêmement pratique sur le logging dans Spring Boot. Elle vous guidera pas à pas dans la création d'une configuration de logging professionnelle.
Regardez la section de 16:21 à 24:10. Elle explique comment créer le fichier logback-spring.xml, définir un appender pour la console et personnaliser le pattern de log. Le code et les fichiers de configuration sont universels, même si la vidéo est en anglais. Vous pouvez mettre en pause et reproduire les étapes dans votre propre projet.
3. Centraliser les logs avec Grafana Loki
Avoir des logs en JSON sur la console de notre application déployée sur Railway, c'est bien, mais pas suffisant. Si notre application est déployée sur plusieurs instances, ou si nous voulons analyser les logs sur une longue période, nous devons les centraliser.
Nous allons utiliser Grafana Cloud, qui propose un généreux "free tier" incluant le service Loki pour l'agrégation de logs. Cela s'inscrit parfaitement dans notre approche PaaS, où nous consommons un service sans avoir à le gérer.
Le processus est le suivant :
- Créer un compte gratuit sur Grafana Cloud.
- Obtenir les informations de connexion pour Loki (URL, User, API Token).
- Configurer un nouvel appender dans notre
logback-spring.xmlpour qu'il envoie les logs à Loki. - Stocker les informations de connexion de manière sécurisée dans les variables d'environnement de notre projet Railway, comme nous l'avons fait pour la base de données.
La vidéo suivante détaille précisément ce processus.
1h Spring Boot Logging Crash Course For Beginners (Config, Remote Logs, JSON Logging & More)
Continuons avec la vidéo de Philipp Lackner. Cette section montre comment configurer l'envoi asynchrone des logs vers Grafana Loki, une pratique de production pour ne pas ralentir votre application.
Regardez la section de 24:10 à 32:20. Suivez attentivement les étapes : ajout de la dépendance loki-logback-appender, création du compte Grafana, configuration de l'appender async-loki et ajout des credentials en tant que variables d'environnement. C'est un exemple parfait qui réutilise les compétences de la leçon précédente.
4. Une touche professionnelle : Ajouter du contexte avec MDC
Imaginez qu'un utilisateur vous signale un bug. Comment retrouver spécifiquement ses actions dans des milliers de lignes de logs ? En ajoutant son userId à chaque log qu'il génère !
Pour cela, nous utilisons une fonctionnalité de SLF4J appelée Mapped Diagnostic Context (MDC). C'est une map (clé-valeur) associée au thread de la requête en cours. On peut y placer des informations (comme userId ou un traceId) au début d'une requête, et elles seront automatiquement disponibles pour tous les logs générés pendant cette requête.
Nous allons implémenter un Filter de Servlet pour ajouter automatiquement le userId de l'utilisateur authentifié au MDC pour chaque requête.
1h Spring Boot Logging Crash Course For Beginners (Config, Remote Logs, JSON Logging & More)
Cette dernière section pratique de la vidéo montre comment implémenter un MDCFilter pour enrichir dynamiquement tous vos logs avec des données contextuelles, comme l'ID de l'utilisateur. C'est une technique très professionnelle.
Regardez la section de 44:21 à 53:42. Vous apprendrez à créer un MDCFilter et une classe de configuration pour l'enregistrer. Ensuite, la section de 32:20 à 38:36 (à regarder après) vous montrera comment configurer le logback-spring.xml pour inclure ces données MDC dans les logs envoyés à Loki. Cela vous permettra de filtrer par userId dans Grafana.
5. (Optionnel) Pour aller plus loin : Journalisation sur Fichier
En plus d'envoyer les logs à un service distant, il est parfois utile (pour la conformité ou comme backup) de les écrire dans des fichiers sur le serveur, avec une politique de rotation (par ex., un nouveau fichier chaque jour ou quand la taille dépasse 50MB).
Si le temps vous le permet, cette partie de la vidéo montre comment mettre cela en place.
1h Spring Boot Logging Crash Course For Beginners (Config, Remote Logs, JSON Logging & More)
Cette section explique comment configurer un RollingFileAppender pour créer des archives de logs rotatives en format JSON.
Regardez de 53:42 à 1:01:16. C'est une bonne pratique à connaître, même si l'envoi à Loki est souvent suffisant pour commencer.
Conclusion
Félicitations ! Votre application n'est plus une boîte noire. Vous avez mis en place les fondations d'une application observable et robuste, prête pour la production.
Points clés à retenir :
- L'observabilité (logs, métriques, traces) est cruciale pour comprendre et maintenir une application en production.
- La journalisation structurée (JSON) est la norme pour que les logs soient exploitables par des machines.
- On utilise
logback-spring.xmlpour définir des appenders (destinations de logs) et personnaliser leur format. - Les logs doivent être centralisés dans un outil comme Grafana Loki pour être analysés efficacement, surtout dans un environnement distribué.
- L'utilisation de variables d'environnement pour les credentials de services externes (comme Loki) est une pratique de sécurité standard.
- Le MDC (Mapped Diagnostic Context) est un outil puissant pour enrichir les logs avec des informations contextuelles (ex:
userId), rendant le débogage beaucoup plus facile. - Spring Boot Actuator expose nativement les métriques de l'application, formant la base du monitoring.
Prochaine étape :
Vous avez maintenant terminé le module sur le déploiement continu et la gestion de la production. Vous avez toutes les cartes en main pour mener un projet de A à Z. La prochaine et dernière étape de votre formation sera le Projet de Synthèse, où vous appliquerez tout ce que vous avez appris, de la gestion de projet Agile à la mise en production observable, sur un cas client complet. Préparez-vous à construire