Bonjour ! Bienvenue dans cette dernière leçon du module sur les stratégies de résolution de problèmes.
Dans la leçon précédente, vous avez appris une technique d'optimisation puissante : le tri préalable des données. Nous avons vu comment cette méthode permet de transformer un algorithme "force brute" en en une solution bien plus efficace en .
Aujourd'hui, nous allons approfondir ce concept. Le but n'est plus seulement de savoir comment optimiser, mais de comprendre et de quantifier pourquoi cette optimisation est si cruciale. Analyser le gain en complexité, c'est savoir mesurer l'impact d'une amélioration et justifier pourquoi une solution est meilleure qu'une autre. C'est une compétence essentielle pour atteindre votre objectif : écrire du code "clean", qui est non seulement lisible, mais aussi performant.
1. Du théorique au concret : l'impact de la complexité
Jusqu'à présent, nous avons manipulé des notations comme , ou . Mais que représentent-elles concrètement ? Ces notations décrivent la courbe de croissance du temps d'exécution d'un algorithme lorsque la taille des données d'entrée (n) augmente.
Observemos le graphique suivant :
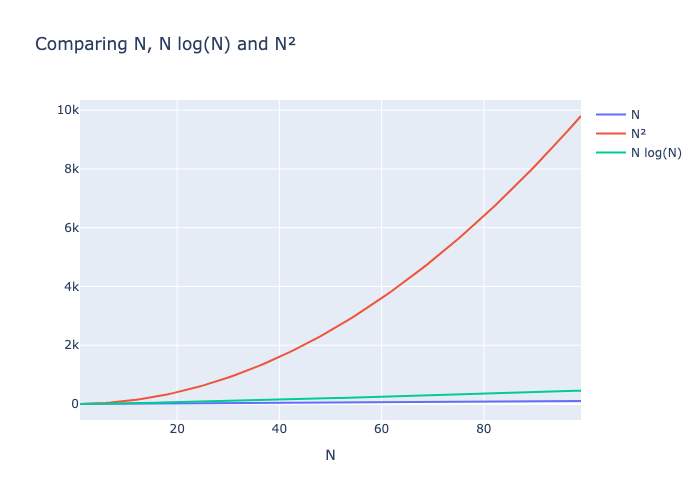
Comme vous pouvez le constater, une complexité quadratique () augmente de façon spectaculaire par rapport à une complexité quasi-linéaire (). Mais que cela signifie-t-il en termes de temps ?
Le tableau ci-dessous traduit ces courbes en temps de calcul approximatifs. C'est ici que le gain d'une optimisation devient tangible.

Analyser ce tableau nous permet de tirer une conclusion fondamentale :
- Pour , la différence est négligeable.
- Pour , un algorithme en prendrait plus de 2 heures, alors qu'un algorithme en s'exécute en moins d'une seconde.
- Pour , la différence se mesure en jours contre quelques millisecondes.
Le "gain" que nous analysons est donc un gain en scalabilité : la capacité de votre algorithme à gérer de grandes quantités de données dans un temps raisonnable. Dans la leçon précédente, en passant de à , vous n'avez pas juste "amélioré" l'algorithme, vous l'avez fait passer de "inutilisable pour de grosses données" à "très efficace".
2. Étude de cas : Le gain exponentiel du "Diviser pour Régner"
Voyons un exemple classique où le gain est encore plus spectaculaire.
Problème : Calculer la puissance d'un nombre, soit .
-
Solution "brute-force" : Il suffit de multiplier
xpar lui-mêmen-1fois à l'aide d'une boucle.Algorithme PuissanceNaive(x, n) resultat <- 1 Pour i de 1 à n resultat <- resultat * x Retourner resultatL'analyse est simple : la boucle s'exécute
nfois. La complexité est donc linéaire, . -
Solution optimisée (exponentiation rapide) : On peut utiliser une approche "diviser pour régner".
- Si
nest pair, alors . On calcule une seule fois et on met le résultat au carré. - Si
nest impair, alors .
À chaque étape, on divise le problème par deux. Ce mécanisme de division répétée est la marque d'une complexité logarithmique. La complexité est en .
- Si
Analyse du gain
Nous passons d'une complexité linéaire à une complexité logarithmique .
Reportons-nous au tableau :
- Pour calculer , la méthode naïve nécessite un million de multiplications.
- La méthode optimisée nécessite environ 20 multiplications ().
Le gain est colossal. Nous avons transformé un problème qui pouvait être lent pour de grands n en un problème quasi-instantané, quelle que soit la taille de n. Le document suivant présente ce problème et d'autres exemples d'optimisation.
[PDF] Optimisation des Algorithmes - Romain Pascual
Le document 'Optimisation des Algorithmes' contient une série d'exercices où une méthode naïve est comparée à une méthode optimisée. L'exercice sur le calcul de puissance illustre parfaitement le gain que nous venons de discuter.
Lisez l'énoncé de l'Exercice 5, 'La fonction (x, n) -> x^n'. Concentrez-vous sur la description des deux approches (la plus simple et celle par 'diviser pour régner') et les complexités demandées (linéaire et logarithmique). Vous n'avez pas besoin d'écrire le code, mais de bien comprendre la différence fondamentale entre les deux stratégies.
3. Étude de cas : Le gain par pré-calcul
Parfois, l'optimisation ne vient pas d'un algorithme plus malin, mais d'un investissement initial : le pré-calcul.
Problème : On nous donne une matrice (tableau à 2 dimensions). On doit répondre à de nombreuses requêtes demandant la somme des éléments d'une sous-matrice rectangulaire.
-
Solution "brute-force" : Pour chaque requête, on parcourt la sous-matrice demandée avec deux boucles imbriquées et on additionne les éléments.
- Si la sous-matrice a pour taille
h(hauteur) etw(largeur), la complexité pour une seule requête est de . - Si on doit répondre à
krequêtes, la complexité totale peut devenir très élevée.
- Si la sous-matrice a pour taille
-
Solution optimisée (table des sommes cumulées) :
- Pré-calcul : On crée une seconde matrice, de même taille, appelée "table de sommation". Pour chaque case
(i, j), on stocke la somme de tous les éléments du rectangle allant de l'origine(0, 0)à(i, j). Ce pré-calcul se fait une seule fois, en parcourant la matrice originale. Coût : , où N et M sont les dimensions de la matrice. - Requête : Grâce à cette table, la somme de n'importe quel rectangle peut être calculée en seulement 4 accès à la table et quelques additions/soustractions. Le calcul devient indépendant de la taille du rectangle. Coût par requête : , soit un temps constant !
- Pré-calcul : On crée une seconde matrice, de même taille, appelée "table de sommation". Pour chaque case
Analyse du gain
Nous avons un compromis :
- Un coût initial de pour construire la table.
- Un gain immense pour chaque requête suivante : on passe de à .
Cette optimisation est extrêmement rentable si le nombre de requêtes est élevé. C'est un schéma classique en informatique : investir du temps et de la mémoire en amont pour accélérer considérablement les opérations futures.
Vous pouvez retrouver ce problème dans les exercices 6 et 7 du même document, "Optimisation des Algorithmes".
4. Du pire au meilleur : l'exemple de Fibonacci
Pour finir, analysons un cas où l'on peut appliquer plusieurs niveaux d'optimisation, avec des gains spectaculaires à chaque étape.
Problème : Calculer le n-ième terme de la suite de Fibonacci.
Le document suivant analyse en détail la complexité de trois approches pour résoudre ce problème. C'est un cas d'école pour comprendre l'analyse de gain.
[PDF] Complexité d'un algorithme : une question cruciale et abordable
L'article 'Complexité d'un algorithme' offre une analyse très pédagogique de la complexité en prenant pour fil rouge le calcul de la suite de Fibonacci. Il montre comment on passe d'un algorithme inutilisable en pratique à une solution ultra-efficace.
Veuillez lire les sections suivantes : 'Exemple 1 : calcul récursif' : Notez la complexité exponentielle et son impact catastrophique sur le temps de calcul. 'Exemple 2 : calcul itératif' : Voyez comment une simple boucle change radicalement la performance pour atteindre une complexité linéaire. 'Comparaison des deux algorithmes' : Ce paragraphe résume le gain obtenu en passant de la version récursive naïve à la version itérative. 'Exemple 4 : calcul ... par puissances' : Découvrez une troisième approche encore plus performante, basée sur le calcul matriciel, qui atteint une complexité logarithmique. Concentrez-vous sur la conclusion du gain obtenu.
Analyse des gains successifs
Résumons les gains que vous avez découverts dans ce document :
-
Solution 1 : Récursive naïve
- Complexité : (exponentielle).
- Performance : Devient inutilisable très rapidement (pour
n > 40). C'est une solution "intractable".
-
Solution 2 : Itérative (avec une boucle)
- Complexité : (linéaire).
- Gain 1 -> 2 : On passe d'une complexité exponentielle à une complexité polynomiale (linéaire). C'est le gain le plus important, celui qui rend l'algorithme utilisable en pratique. C'est la différence entre des années de calcul et une fraction de seconde.
-
Solution 3 : Matricielle (exponentiation rapide)
- Complexité : (logarithmique).
- Gain 2 -> 3 : On passe de linéaire à logarithmique. L'algorithme devient quasi-instantané même pour des valeurs de
nimmenses (des milliers ou des millions), pour lesquelles la version itérative commencerait à prendre un temps mesurable.
Cet exemple montre qu'analyser le gain en complexité, c'est identifier le passage d'une "classe de complexité" à une autre, et comprendre l'impact concret que cela aura sur l'utilisabilité de votre programme.
Conclusion
Vous voilà au terme de ce module. Vous avez appris non seulement à identifier des solutions "brute-force" et à les optimiser, mais aussi, aujourd'hui, à mesurer et à justifier l'intérêt de ces optimisations.
Points clés à retenir :
- Analyser le gain en complexité, c'est comparer les classes de complexité (ex: vs ) de la solution initiale et de la solution optimisée.
- Ce gain se traduit par une meilleure scalabilité : la capacité de l'algorithme à traiter de grands volumes de données dans un temps raisonnable.
- Les gains les plus importants sont ceux qui font passer un algorithme d'une classe de complexité élevée (exponentielle, polynomiale d'ordre élevé) à une classe plus basse (linéaire, logarithmique).
- L'optimisation peut passer par un algorithme plus intelligent (diviser pour régner) ou par un pré-calcul qui amortit son coût sur de nombreuses utilisations futures.
Cette compétence est la dernière pièce du puzzle avant de vous lancer dans un projet complet. Vous êtes maintenant capable d'analyser un problème, de concevoir une solution, de l'optimiser, et d'expliquer pourquoi votre nouvelle solution est meilleure.
La prochaine et dernière étape de votre parcours sur les algorithmes sera le Projet de Synthèse, où vous mettrez en pratique tout ce que vous avez appris, de la définition d'un algorithme à l'analyse de son efficacité. Félicitations pour le chemin parcouru