Bonjour !
Dans notre leçon précédente, nous avons décortiqué le fonctionnement du tri fusion (Merge Sort), en implémentant son pseudo-code et en traçant son exécution. Vous avez vu comment la stratégie "Diviser pour Régner" permet de trier un tableau de manière élégante grâce à la récursivité.
Aujourd'hui, nous allons répondre à une question essentielle : pourquoi cet algorithme est-il considéré comme si performant ? L'objectif de cette leçon est d'analyser la complexité du tri fusion, de comprendre pourquoi elle est notée , et de la comparer à la complexité des tris simples (comme le tri par sélection ou par insertion) que nous avons déjà étudiés. Cette analyse est cruciale pour faire des choix éclairés en tant que développeur et pour écrire du code qui est non seulement correct, mais aussi efficace.
1. Rappel sur la complexité
Avant de plonger dans le tri fusion, rafraîchissons-nous la mémoire. Dans le module 9, nous avons introduit la notation Big O pour mesurer l'efficacité d'un algorithme, c'est-à-dire comment son temps d'exécution ou son utilisation de la mémoire évolue avec la taille des données d'entrée, notée n.
Nous avons vu que les tris simples comme le tri par sélection, le tri à bulles ou le tri par insertion ont une complexité dans le pire des cas de (quadratique). Cela signifie que si l'on double la taille du tableau, le temps d'exécution est multiplié par quatre environ.
Maintenant, analysons le tri fusion pour voir comment il se compare.
2. Analyse de la complexité du Tri Fusion
Pour analyser l'algorithme Tri-Fusion, nous devons considérer les deux parties qui le composent : la fonction Fusionner et la structure récursive de Tri-Fusion elle-même.
Étape 1 : Complexité de la fonction Fusionner
Souvenez-vous de la fonction Fusionner : elle prend deux sous-tableaux déjà triés et les combine en un seul grand tableau trié.
Imaginez que vous fusionnez deux sous-tableaux dont la taille totale est de n éléments. Pour construire le tableau final, l'algorithme parcourt les deux sous-tableaux une seule fois. À chaque étape, il effectue une comparaison pour décider quel élément ajouter au tableau final. Au total, pour placer les n éléments dans le tableau final, il effectue un nombre d'opérations proportionnel à n.
Par conséquent, la complexité temporelle de la fonction Fusionner est linéaire, ce qui s'écrit .
Étape 2 : Complexité de l'algorithme récursif Tri-Fusion
C'est ici que la stratégie "Diviser pour Régner" révèle sa puissance. L'analyse se fait en deux temps :
- Combien de niveaux de division y a-t-il dans l'arbre de récursivité ?
- Quelle est la quantité de travail effectuée à chaque niveau ?
1. Le nombre de niveaux de division (le "log n")
L'algorithme Tri-Fusion divise le tableau en deux à chaque appel récursif.
- Un tableau de taille
nest divisé en deux tableaux de taillen/2. - Ces deux tableaux sont divisés en quatre tableaux de taille
n/4. - ... et ainsi de suite, jusqu'à n'obtenir que des tableaux d'un seul élément.
La question est : combien de fois peut-on diviser n par 2 avant d'arriver à 1 ? La réponse mathématique est le logarithme en base 2 de n, noté . C'est de là que vient la partie log n de notre complexité. Le nombre de niveaux de l'arbre de récursion est donc proportionnel à .
2. Le travail effectué à chaque niveau (le "n")
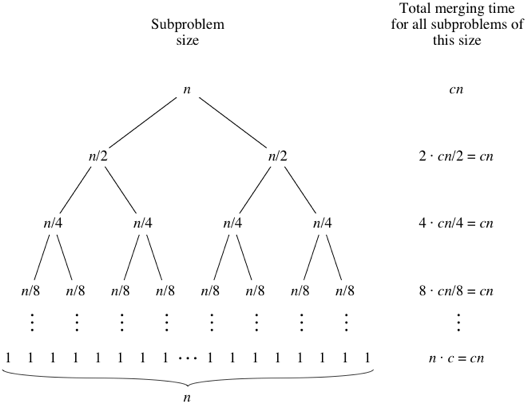
Maintenant, regardons la quantité de travail (les fusions) effectuée à chaque niveau de l'arbre.
- Au dernier niveau, nous avons
ntableaux d'un élément. Nous les fusionnons deux par deux. Le travail total de fusion est proportionnel àn. - Au niveau juste au-dessus, nous fusionnons des sous-tableaux de taille 2. Encore une fois, la somme des tailles de tous les sous-tableaux à ce niveau est
n. Le travail total de fusion est donc toujours proportionnel àn. - Ce principe est vrai pour tous les niveaux de l'arbre : à chaque niveau, la somme du travail de toutes les fusions est proportionnelle à
n.
L'image suivante illustre parfaitement ce concept. À gauche, l'arbre de division, et à droite, le coût de la fusion pour chaque niveau.
Conclusion de l'analyse :
Si nous avons environ niveaux, et que chaque niveau nécessite un travail en , le coût total de l'algorithme Tri-Fusion est le produit des deux :
Pour consolider cette idée, vous pouvez consulter la justification formelle.
TD 7 : Algorithmes de tri - Diviser pour régner
Ce document contient l'analyse de plusieurs algorithmes de tri. La section sur le tri fusion explique de manière concise pourquoi sa complexité est en O(n log n).
Allez à la section "Exercice 4 : Tri fusion" et lisez la partie "correction". Concentrez-vous sur le dernier point qui commence par "Dans le pire et le meilleur des cas...". Le schéma juste en dessous est une autre représentation de l'arbre que nous venons de voir.
Ce qui est remarquable, c'est que cette complexité de est la même dans le meilleur, le pire et le cas moyen, car la division du tableau se fait toujours de la même manière, quel que soit le contenu du tableau.
3. Comparaison : vs.
Maintenant que nous avons établi la complexité du tri fusion, comparons-la à la complexité des tris simples. Au premier abord, les expressions ne sont pas très parlantes. Rendons cela concret.
Calculons le nombre approximatif d'opérations pour différentes tailles de n :
| Taille du tableau (n) | (Tris simples) | (Tri fusion) |
|---|---|---|
| 10 | 100 | ~33 |
| 100 | 10 000 | ~664 |
| 1 000 | 1 000 000 | ~9 965 |
| 1 000 000 | 1 000 000 000 000 | ~19 931 568 |
Comme vous pouvez le voir, pour un petit tableau de 10 éléments, la différence n'est pas énorme. Mais pour un million d'éléments, l'algorithme quadratique devrait effectuer mille milliards d'opérations, alors que le tri fusion n'en nécessite qu'environ 20 millions. C'est la différence entre un programme qui prend des jours et un qui répond en une fraction de seconde.
Le graphique suivant illustre de manière saisissante la croissance des différentes classes de complexité.
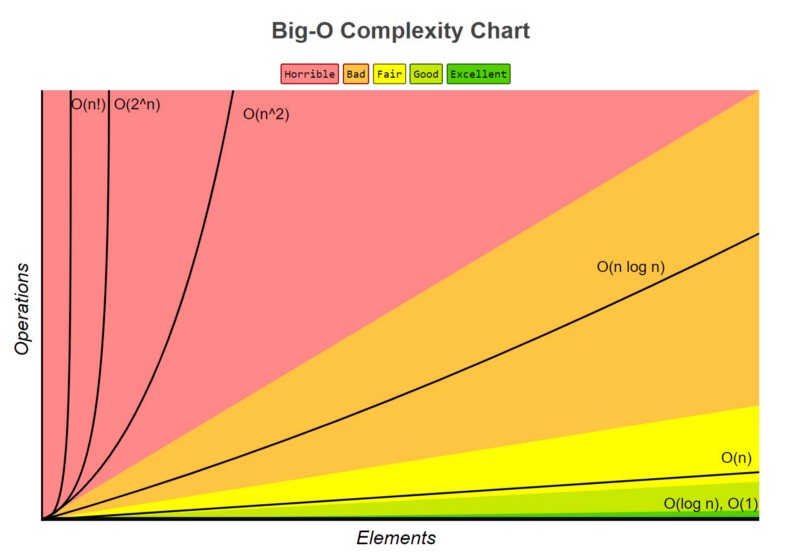
On voit clairement que la courbe (jaune) reste très basse, tandis que la courbe (rouge) grimpe de manière explosive.
Pour un rappel sur les différentes classes de complexité et ce qu'elles représentent, l'article suivant est une excellente ressource.
Comprendre la complexité des algorithmes
Cet article de SFEIR explique de manière claire les classes de complexité les plus courantes, avec des exemples. Cela vous aidera à contextualiser la différence entre O(n²) et O(n log n).
Lisez la section intitulée "Pour le meilleur et pour le pire". Elle décrit chaque classe de complexité, de O(1) à O(n!), et vous aidera à situer la performance du tri fusion par rapport aux autres.
Conclusion
Aujourd'hui, nous avons quantifié l'efficacité du tri fusion et compris pourquoi la stratégie "Diviser pour Régner" est si puissante.
Points clés à retenir :
- La complexité de l'étape de fusion est linéaire : .
- L'algorithme de tri fusion a une complexité temporelle de car il effectue un travail en sur niveaux de récursion.
- Une complexité de est significativement meilleure qu'une complexité de pour les grands ensembles de données, rendant le tri fusion beaucoup plus performant que les tris simples dans la plupart des cas.
- Le choix d'un algorithme efficace est un pilier de l'écriture de "code clean" et performant.
Et après ?
Nous avons beaucoup travaillé avec les tableaux, qui sont une structure de données fondamentale. Cependant, ils ont certaines limites. Par exemple, insérer ou supprimer un élément au milieu d'un grand tableau peut être coûteux, car cela nécessite de décaler tous les éléments suivants.
Dans la prochaine leçon, nous allons découvrir une nouvelle structure de données, la liste chaînée, qui offre une alternative intéressante aux tableaux, notamment pour résoudre ce type de problème. Nous définirons ce qu'est un nœud, un pointeur, et verrons comment ces concepts nous permettent de construire des structures de données plus flexibles.