Bonjour ! Dans la leçon précédente, vous avez franchi une étape cruciale en mappant une classe Java Book à une table de base de données grâce aux annotations JPA. Votre application peut maintenant "voir" la structure de votre base de données. Cependant, une question demeure : comment interagir concrètement avec ces données ? Comment sauvegarder, lire, mettre à jour ou supprimer des livres ?
Aujourd'hui, nous allons découvrir la magie de Spring Data JPA avec les interfaces Repository. Vous allez apprendre comment, en écrivant seulement quelques lignes de code pour définir une interface, Spring peut générer automatiquement toute la logique nécessaire pour effectuer des opérations de base de données. C'est l'une des fonctionnalités les plus puissantes de Spring, qui vous fera gagner un temps de développement considérable.
À la fin de cette leçon, vous saurez créer des interfaces de repository avec Spring Data JPA, vous donnant ainsi un accès complet et simplifié à vos données.
1. Le Pattern Repository : Votre Porte d'Accès aux Données
Avant Spring Data, les développeurs utilisaient souvent le pattern DAO (Data Access Object). Ce pattern consistait à créer une interface pour définir les opérations sur les données (ex: findBookById), puis une classe d'implémentation concrète qui écrivait le code JDBC ou JPA pour exécuter les requêtes SQL. C'était fonctionnel, mais répétitif et fastidieux.
Spring Data JPA révolutionne cette approche avec le pattern Repository. L'idée est simple : vous ne définissez que l'interface, et Spring s'occupe de l'implémentation pour vous.
Implémentez vos entités et les interfaces repository - OpenClassrooms
Cet article d'OpenClassrooms explique de manière très claire la transition du pattern DAO au pattern Repository de Spring Data.
Lisez d'abord la section "Le fonctionnement de Spring Data JPA" pour bien saisir comment Spring élimine la nécessité d'écrire la classe d'implémentation (la DataDAOImpl). Ensuite, lisez la section "Implémentez les interfaces Repository" qui montre comment créer concrètement une de ces interfaces.
2. Les Interfaces Clés : CrudRepository et JpaRepository
Pour nous fournir cette fonctionnalité, Spring Data propose une hiérarchie d'interfaces prêtes à l'emploi. Les deux plus importantes à connaître sont CrudRepository et JpaRepository.
-
CrudRepository<T, ID>: C'est l'interface de base qui fournit les opérations CRUD (Create, Read, Update, Delete).save(T entity): Crée ou met à jour une entité.findById(ID id): Recherche une entité par sa clé primaire.findAll(): Récupère toutes les entités.count(): Compte le nombre total d'entités.deleteById(ID id): Supprime une entité par sa clé primaire.existsById(ID id): Vérifie si une entité existe.
-
JpaRepository<T, ID>: Cette interface hérite deCrudRepository(et d'autres interfaces utiles commePagingAndSortingRepository) et ajoute des fonctionnalités spécifiques à JPA.findAll(): Renvoie uneList<T>(plus pratique que l'Iterable<T>deCrudRepository).flush(): Force la synchronisation de l'état des entités avec la base de données.saveAndFlush(T entity): Sauvegarde une entité et la synchronise immédiatement.
Dans un projet Spring Boot avec JPA, il est courant et recommandé d'hériter directement de JpaRepository, car elle vous donne accès à l'ensemble le plus complet de fonctionnalités.

3. Création de votre première interface Repository
Voyons maintenant à quel point il est simple de créer un repository pour notre entité Book.
- Nous créons une nouvelle interface (pas une classe !).
- Nous la nommons
BookRepository(convention de nommage :NomEntité+Repository). - Nous la faisons hériter de
JpaRepository<Book, Long>.- Le premier type générique,
Book, est la classe d'entité que ce repository va gérer. - Le second,
Long, est le type de la clé primaire de l'entitéBook(le champidque nous avons défini).
- Le premier type générique,
- Nous ajoutons l'annotation
@Repositorysur l'interface. Bien que Spring soit assez intelligent pour la détecter sans, cette annotation déclare explicitement que c'est un bean Spring destiné à l'accès aux données. C'est une bonne pratique qui clarifie l'architecture.
Et c'est tout ! Voici à quoi ressemble le code :
package com.exemple.votreprojet.repository;

import com.exemple.votreprojet.model.Book;
import org.springframework.data.jpa.repository.JpaRepository;
import org.springframework.stereotype.Repository;

@Repository
public interface BookRepository extends JpaRepository<Book, Long> {
    // Magie ! Pas besoin d'écrire de code ici.
    // Les méthodes comme save(), findById(), findAll(), etc. sont déjà disponibles.
}
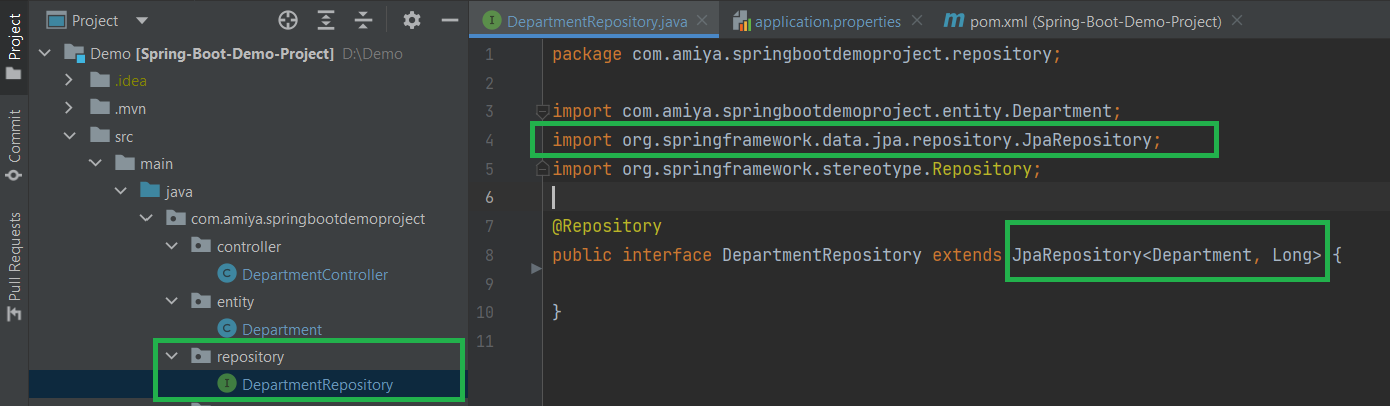
La vidéo suivante vous montrera en direct la création d'une telle interface dans un projet.
Application CRUD en 30 minutes | Tutoriel Étape par Étape | Spring Boot | MySQL
Cette vidéo de "Coding With Armand" montre la construction d'une application CRUD complète. Nous allons nous concentrer sur la partie qui concerne la création du repository.
Regardez la section de création du repository. Observez comment le présentateur crée une interface PersonRepository qui étend JpaRepository. Il explique très bien le rôle des types génériques (Person, l'entité, et Long, le type de l'ID) et mentionne l'utilité de l'annotation @Repository.
Comment ça marche ?
Au démarrage de votre application, Spring Boot détecte votre interface BookRepository. Comme elle étend JpaRepository, Spring comprend qu'il doit fournir une implémentation. Il génère alors dynamiquement une classe (un proxy) qui implémente toutes les méthodes (save, findById, etc.) en utilisant JPA en coulisses. Cette classe générée est ensuite enregistrée dans le contexte de Spring comme un bean, prête à être injectée et utilisée n'importe où dans votre application.
Spring Data avec JPA - David Gayerie
Cet article de David Gayerie approfondit les concepts que nous venons de voir.
Lisez la section "Spring Data JPA" pour revoir la définition de JpaRepository et voir un exemple de code. Ensuite, parcourez la section "Injection des repositories" qui explique comment Spring crée les beans pour vous et comment vous pourrez les utiliser plus tard.
Exercice Pratique
Il est temps de passer à l'action. Dans votre projet, vous allez créer le repository pour l'entité Book que vous avez configurée lors de la leçon précédente.
- Dans votre structure de projet (
src/main/java/com/exemple/votreprojet), créez un nouveau package nommérepository. - À l'intérieur de ce package, créez une nouvelle interface Java et nommez-la
BookRepository. - Faites en sorte que cette interface étende
JpaRepository<Book, Long>. N'oubliez pas d'importer les classesBooketJpaRepository. - Ajoutez l'annotation
@Repositoryau-dessus de la déclaration de l'interface. - Démarrez votre application. Vous ne verrez rien de nouveau sur une page web, mais si l'application démarre sans erreur, cela signifie que Spring a bien reconnu votre repository et a créé son implémentation en mémoire. Si vous regardez les logs de démarrage, vous pourriez voir des lignes concernant la création des beans, y compris votre
bookRepository.
Conclusion
Vous avez maintenant les deux piliers de la persistance de données avec Spring :
- Les Entités (
@Entity) : qui décrivent la structure de vos données. - Les Repositories (
@Repository) : qui fournissent le mécanisme pour interagir avec ces données.
Points clés à retenir :
- Le pattern Repository de Spring Data JPA simplifie radicalement l'accès aux données.
- En créant une simple interface qui étend
JpaRepository<Entité, TypeID>, vous obtenez gratuitement toutes les méthodes CRUD standard. - L'annotation
@Repositorymarque sémantiquement votre interface comme un composant d'accès aux données. - Spring se charge de générer l'implémentation de cette interface au démarrage de l'application.
Maintenant que nous avons une entité pour représenter nos livres et un repository pour les gérer, comment allons-nous organiser notre code pour exposer ces fonctionnalités via notre API REST ?
Dans la prochaine leçon, nous allons assembler toutes les pièces. Nous introduirons l'architecture en 3 couches (Controller, Service, Repository), qui est le standard de l'industrie pour construire des applications backend robustes et maintenables. Vous verrez comment le Repository que vous venez de créer s'intègre parfaitement dans la couche d'accès aux données.