Bonjour ! Dans la leçon précédente, nous avons construit des pipelines de traitement de données avec des opérations intermédiaires comme filter, map et sorted. Vous avez appris que ces pipelines sont "paresseux" (lazy) et ne s'exécutent que lorsqu'une opération terminale est appelée pour produire un résultat.
Aujourd'hui, nous arrivons au bout de cette "chaîne de montage". Nous allons nous concentrer sur les opérations terminales, celles qui déclenchent le traitement du Stream et agrègent les éléments pour produire un résultat final. L'objectif est de maîtriser les trois opérations d'agrégation les plus importantes : forEach, collect et reduce. Vous apprendrez à transformer vos flux de données en résultats concrets, comme une nouvelle collection, une valeur de synthèse, ou même une Map complexe.
1. Qu'est-ce qu'une opération terminale ?
Une opération terminale est la dernière étape d'un pipeline de Stream. Elle consomme les éléments du flux pour produire un résultat ou un effet de bord (comme une écriture en console). Une fois qu'une opération terminale est exécutée, le Stream est considéré comme "consommé" et ne peut plus être réutilisé.
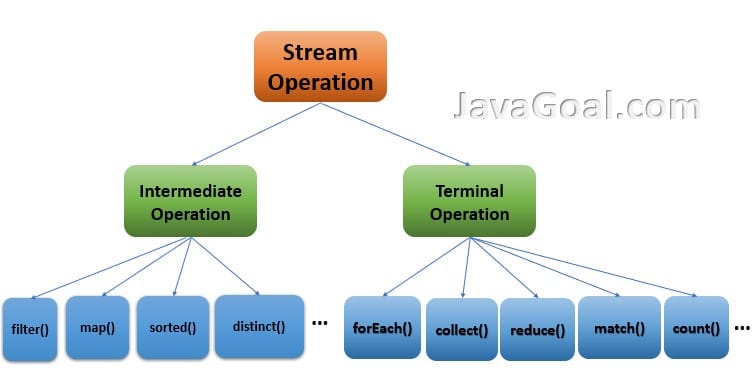
Il existe plusieurs types d'opérations terminales, mais nous allons nous concentrer sur celles qui servent à agréger les résultats.
2. forEach : Pour les effets de bord
L'opération forEach(Consumer<T> action) est la plus simple. Elle exécute une action pour chaque élément du Stream. Son utilisation la plus courante est pour afficher des éléments, ce qui est utile pour le débogage.
List<String> fruits = List.of("Pomme", "Banane", "Orange");
fruits.stream()
      .filter(f -> f.startsWith("P"))
      .forEach(System.out::println); // Affiche "Pomme"
Bonne pratique : forEach est conçue pour les effets de bord (side-effects), c'est-à-dire des actions qui interagissent avec l'extérieur du Stream (console, réseau, base de données). Vous devez impérativement éviter de l'utiliser pour modifier un état externe, comme ajouter des éléments à une collection. C'est une erreur fréquente qui va à l'encontre des principes de la programmation fonctionnelle (fonctions pures, immutabilité) et peut causer des bugs, notamment avec les Streams parallèles.
L'article ci-dessous explique très bien ce piège et la bonne manière de faire.
Programmation Fonctionnelle en Java : Part2 - API Stream
Cet article du blog SFEIR aborde des points avancés sur l'API Stream, notamment les bonnes pratiques.
Lisez la première section des "Bonnes pratiques et pièges à éviter" intitulée "Éviter les effets de bord". L'exemple badExample illustre exactement ce qu'il ne faut pas faire. Retenez la conclusion : pour créer une nouvelle collection, on n'utilise pas forEach mais collect.
3. collect : Le couteau suisse de l'agrégation
L'opération collect est sans doute l'opération terminale la plus puissante et la plus flexible. Elle permet de transformer les éléments d'un Stream en un résultat unique, le plus souvent une collection (List, Set, Map).
L'opération collect prend en argument un objet Collector, qui décrit la "recette" pour accumuler les éléments. Heureusement, la classe utilitaire java.util.stream.Collectors nous fournit une multitude de "recettes" prêtes à l'emploi.
Collecter les données via l'API Stream
Cet article de Franck Tounga est une excellente introduction à la collecte de données avec les Streams.
Lisez l'introduction et les sections "Les Collectors en un mot" et "Collecteurs prédéfinis". L'objectif est de comprendre le rôle de collect et de Collectors. Notez la comparaison entre l'approche impérative (avec des boucles) et l'approche fonctionnelle pour grouper des transactions : elle illustre parfaitement la puissance et la lisibilité des Streams.
Voyons les principaux Collectors que vous utiliserez au quotidien.
3.1. Résumer le Stream en une seule valeur
Ces collecteurs sont utiles pour calculer des statistiques sur vos données.
Collecter les données via l'API Stream
Cette section détaille les collecteurs de résumé les plus courants.
Lisez la section "Réduire et résumer" et ses sous-sections. Pour chaque collecteur, analysez l'exemple et le résultat produit : counting() : Pour compter le nombre d'éléments. maxBy() / minBy() : Pour trouver l'élément maximum ou minimum selon un Comparator. summingInt(), averagingInt() : Pour faire la somme ou la moyenne sur un champ numérique. summarizingInt() : Pour obtenir toutes les statistiques d'un coup (count, sum, min, average, max). joining() : Pour concaténer des chaînes de caractères, très utile pour créer des affichages.
Voici un exemple qui combine plusieurs de ces concepts. Imaginons que nous voulions obtenir des statistiques sur le prix des produits de notre catalogue :
import java.util.List;
import java.util.stream.Collectors;
import java.util.DoubleSummaryStatistics;

// En reprenant la classe Product de la leçon précédente
public class Main {
    public static void main(String[] args) {
        List<Product> products = List.of(
            new Product("Souris Gamer", 49.99),
            new Product("Écran 27 pouces", 349.00),
            new Product("Clavier Mécanique", 129.50)
        );

        // Obtenir des statistiques sur les prix
        DoubleSummaryStatistics stats = products.stream()
            .collect(Collectors.summarizingDouble(Product::getPrice));

        System.out.println(stats);
        // Affiche: DoubleSummaryStatistics{count=3, sum=528.49, min=49.99, average=176.16..., max=349.00}

        // Concaténer les noms des produits
        String names = products.stream()
            .map(Product::getName)
            .collect(Collectors.joining(", "));

        System.out.println(names);
        // Affiche: Souris Gamer, Écran 27 pouces, Clavier Mécanique
    }
}
3.2. Grouper les éléments avec groupingBy
groupingBy est l'un des collecteurs les plus puissants. Il permet de regrouper les éléments d'un Stream dans une Map, en se basant sur un critère (une fonction de classification). C'est l'équivalent du GROUP BY en SQL.
Collecter les données via l'API Stream
Cette section de l'article de Franck Tounga est consacrée au regroupement.
Lisez la section "Regroupement". Concentrez-vous sur le premier exemple qui groupe les plats par type (Dish::getType). Comprenez bien que le résultat est une Map<Type, List<Dish>>. Passez rapidement sur le regroupement multi-niveaux, juste pour voir que c'est possible d'imbriquer les groupingBy.
Par exemple, pour regrouper nos produits par catégorie de prix (disons "Abordable" si < 100€, "Cher" sinon) :
Map<String, List<Product>> productsByPriceCategory = products.stream()
    .collect(Collectors.groupingBy(
        p -> p.getPrice() < 100 ? "Abordable" : "Cher"
    ));

System.out.println(productsByPriceCategory);
// {Abordable=[Product{name='Souris Gamer', price=49.99}],
//  Cher=[Product{name='Écran 27 pouces', price=349.0}, Product{name='Clavier Mécanique', price=129.5}]}
On peut même combiner groupingBy avec d'autres collecteurs pour agréger les valeurs de chaque groupe. Par exemple, compter le nombre de produits dans chaque catégorie :
Map<String, Long> countByCategory = products.stream()
    .collect(Collectors.groupingBy(
        p -> p.getPrice() < 100 ? "Abordable" : "Cher",
        Collectors.counting() // Collecteur "en aval"
    ));

System.out.println(countByCategory); // {Abordable=1, Cher=2}
4. reduce : L'agrégation fondamentale
L'opération reduce est une forme plus primitive d'agrégation. Elle permet de combiner tous les éléments d'un Stream pour produire un résultat unique en appliquant de manière répétée une opération de combinaison.
La vidéo suivante, bien qu'en JavaScript, explique parfaitement le concept de reduce qui est universel en programmation fonctionnelle.
Tutoriel : La programmation fonctionnelle
Cette vidéo de Grafikart.fr explique les concepts de la programmation fonctionnelle. La section sur reduce est particulièrement claire.
Regardez la partie sur reduce qui commence à l'explication de reduce. Concentrez-vous sur l'idée d'un "accumulateur" qui est mis à jour à chaque élément du tableau. La logique est identique en Java.
En Java, reduce a deux signatures principales :

-
T reduce(T identity, BinaryOperator<T> accumulator)identity: La valeur de départ (ex: 0 pour une somme).accumulator: Une fonction qui prend deux arguments (le résultat accumulé jusqu'ici et l'élément suivant) et retourne le nouveau résultat accumulé.
Exemple : calculer la somme des prix.
double totalPrice = products.stream() .map(Product::getPrice) .reduce(0.0, (subtotal, price) -> subtotal + price); // ou plus simplement : .reduce(0.0, Double::sum); System.out.println(totalPrice); // 528.49 -
Optional<T> reduce(BinaryOperator<T> accumulator)- Cette version n'a pas de valeur de départ. Si le Stream est vide, il n'y a rien à retourner. C'est pourquoi le résultat est encapsulé dans un
Optional<T>.
Exemple : trouver le produit le plus cher.
Optional<Product> mostExpensiveProduct = products.stream() .reduce((p1, p2) -> p1.getPrice() > p2.getPrice() ? p1 : p2); mostExpensiveProduct.ifPresent(p -> System.out.println("Le plus cher : " + p)); - Cette version n'a pas de valeur de départ. Si le Stream est vide, il n'y a rien à retourner. C'est pourquoi le résultat est encapsulé dans un
5. collect vs reduce : Quand utiliser quoi ?
Vous avez peut-être remarqué qu'on peut parfois faire la même chose avec reduce et collect (par exemple, une somme). Alors, quelle est la différence ?
Collecter les données via l'API Stream
Cette section de l'article de F. Tounga aborde une distinction cruciale pour les bonnes pratiques et la performance.
Lisez attentivement la section "Collect vs reduce". Retenez le point principal : reduce est conçu pour une réduction immuable (créer une nouvelle valeur à chaque étape), tandis que collect est optimisé pour une réduction mutable (modifier un conteneur, comme ajouter un élément à une liste).
En résumé :
- Utilisez
reducelorsque vous voulez combiner une séquence d'éléments en une seule valeur primitive ou un objet immuable, et que la logique de combinaison est simple. Exemples : somme, produit, max, min, concaténation de chaînes. - Utilisez
collectlorsque vous voulez accumuler des éléments dans un conteneur mutable, comme uneList, unSet, ou uneMap.collectest plus sûr et plus performant pour ces cas, surtout en parallèle. Pour la plupart des cas d'usage en backend (regrouper des données, créer des DTOs),collectavec lesCollectorssera votre outil de prédilection.
Conclusion
Félicitations ! Vous avez maintenant une vision complète du pipeline de Stream, de la création à l'opération terminale. Vous êtes capable d'agréger les résultats de vos traitements de données de manière puissante et expressive.
Points clés à retenir :
- Les opérations terminales (
forEach,collect,reduce) déclenchent l'exécution du pipeline de Stream et produisent un résultat final. forEachs'utilise pour les effets de bord et ne doit pas modifier de collections externes.collectest l'outil le plus polyvalent pour accumuler des résultats dans desList,Set,Mapou autres conteneurs, grâce à la classe utilitaireCollectors.- Les
Collectorspermettent de faire des résumés (summingInt,counting), du regroupement (groupingBy) et de la concaténation (joining). reduceest l'opération d'agrégation fondamentale pour combiner tous les éléments en une seule valeur.- Préférez
collectpour accumuler dans des conteneurs (mutable) etreducepour des combinaisons simples (immuable).
Dans la prochaine leçon, nous verrons une autre application très pratique des Streams : la lecture et l'écriture de fichiers. Vous découvrirez comment l'API java.nio s'intègre parfaitement avec les Streams pour traiter des fichiers texte de manière élégante et efficace, une compétence très utile pour un développeur backend qui doit souvent manipuler des logs ou des fichiers de configuration.