Bonjour,
Dans la leçon précédente, nous avons établi les fondations de notre travail sur les graphes en définissant deux représentations en OCaml, et en privilégiant le type graphe = int list array pour sa performance dans le contexte des concours.
Aujourd'hui, nous mettons cette représentation en action. L'objectif est d'implémenter l'un des algorithmes les plus fondamentaux sur les graphes : le parcours en largeur, ou Breadth-First Search (BFS). Cet algorithme requiert une structure de données de type file d'attente. Le défi principal de cette leçon, et un point essentiel de la programmation fonctionnelle, sera de construire et d'utiliser une file fonctionnelle efficace, c'est-à-dire une structure de file persistante qui respecte le paradigme de l'immutabilité.
1. Le Parcours en Largeur (BFS) : Principe et Structure
Le parcours en largeur explore un graphe "par vagues" ou "par niveaux" successifs à partir d'un sommet source.
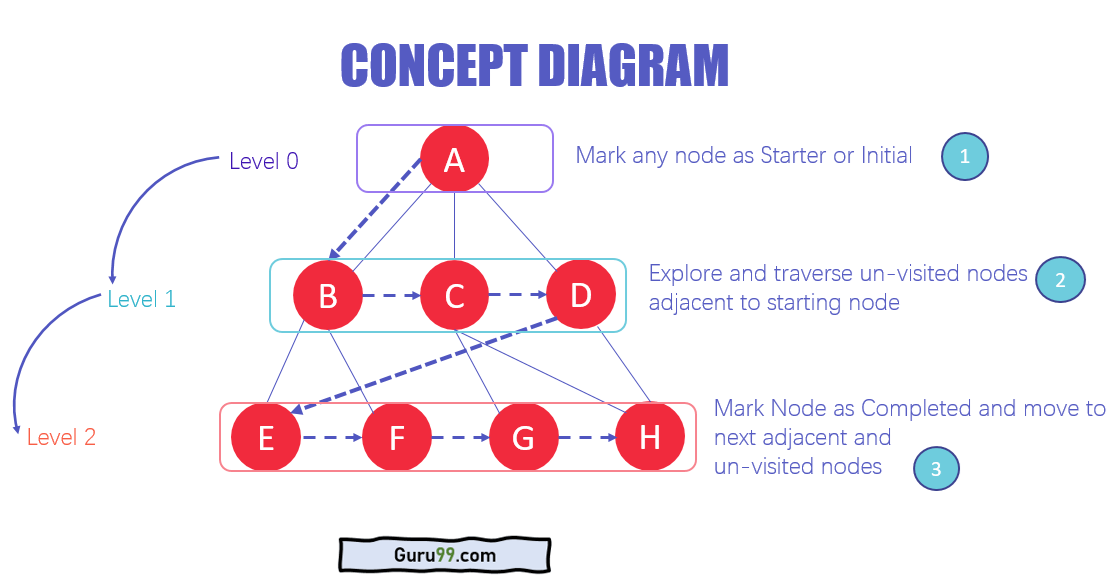
Pour gérer la frontière des sommets à visiter, le BFS s'appuie sur une structure de données premier entré, premier sorti (FIFO) : une file d'attente.
L'algorithme général est le suivant :
- Initialiser les distances de tous les sommets à l'infini, sauf pour le sommet source qui est à distance 0. Marquer comme visité.
- Créer une file d'attente et y insérer .
- Tant que la file n'est pas vide :
a. Défiler un sommet .
b. Pour chaque voisin de non encore visité :
i. Marquer comme visité.
ii. Mettre à jour sa distance (distance() = distance() + 1).
iii. Enfiler .
L'image suivante illustre parfaitement l'état initial pour un parcours partant du sommet s.

Le document ci-dessous, bien qu'utilisant une implémentation que nous allons critiquer, décrit très bien la logique de l'algorithme.
Implémentation et parcours de graphe en OcamL
Ce document explique la distinction entre parcours en largeur et en profondeur, et souligne le rôle central de la file pour le BFS.
Lisez les sections "III-A - Qu'est ce qu'un parcours ?" et "III-C - Exemple du parcours en largeur" (pages 4 à 8). Retenez surtout la conclusion de la page 8 : "Lorsque l'on ajoute les voisins à la liste des éléments à ajouter, on les place à la fin, et on lit le premier élément de la liste, cela correspond à une structure de file."
2. La File Fonctionnelle : de la Naïveté à l'Efficacité
La ressource LINK propose d'implémenter la file avec une simple liste OCaml et d'enfiler les nouveaux éléments avec l'opérateur de concaténation @ (file @ listelement). C'est une approche simple mais problématique.
Question : Sachant que l'opérateur l1 @ l2 a une complexité en , quelle est la complexité de l'opération enfiler proposée ? Pourquoi est-ce inacceptable pour un algorithme de BFS dont on attend une complexité en ?
Réponse
L'opération `file @ listelement` est en $O(|file|)$. À chaque fois que l'on ajoute des voisins à la file, on doit parcourir toute la file existante. Dans le pire des cas, la file peut contenir un grand nombre de sommets, rendant chaque opération d'enfilage très coûteuse. Cette accumulation de coûts dégraderait la complexité globale de l'algorithme bien au-delà du $O(|S| + |A|)$ attendu. Il nous faut donc une opération d'enfilage plus rapide.Pour résoudre ce problème, nous allons construire une file fonctionnelle (ou persistante) efficace. L'astuce classique consiste à utiliser non pas une, mais deux listes.
La vidéo suivante expose cette construction de manière très claire.
Functional Queues | OCaml Programming | Chapter 5 Video 7
Cette vidéo de Michael Ryan Clarkson explique comment implémenter une file fonctionnelle efficace en OCaml. Elle commence par l'approche naïve que nous venons de critiquer, puis introduit la solution à deux listes.
Regardez attentivement ces quatre parties : (00:00 - 01:40) : L'implémentation simple mais inefficace avec une seule liste (complexité linéaire pour enqueue). (01:47 - 04:02) : L'idée maîtresse : représenter la file par deux listes, front et back, où back est inversée. Comprenez bien l'invariant de la structure. (04:02 - 05:23) : Implémentation de enqueue. C'est une opération en temps constant. (05:23 - 07:45) : Implémentation de dequeue. Elle est généralement en temps constant, mais nécessite parfois une opération de renversement coûteuse. C'est le cœur de l'analyse de complexité amortie.
Pour formaliser cela, nous allons définir un module Queue respectant une signature précise.
Signature de la file :
module type QUEUE = sig
  (* Le type abstrait d'une file contenant des éléments de type 'a *)
  type 'a t

  (* La file vide *)
  val empty : 'a t

  (* Teste si la file est vide *)
  val is_empty : 'a t -> bool

  (* Ajoute un élément à l'arrière de la file. O(1) amorti. *)
  val enqueue : 'a -> 'a t -> 'a t

  (* Renvoie une option contenant la tête de la file, sans la modifier. O(1). *)
  val peek : 'a t -> 'a option

  (* Renvoie une option contenant un couple (tête, reste_de_la_file). O(1) amorti. *)
  val dequeue : 'a t -> ('a * 'a t) option
end
Exercice : En vous basant sur la vidéo, implémentez un module FunctionalQueue qui respecte cette signature QUEUE.
Solution
module FunctionalQueue : QUEUE = struct
  (* La file est un couple de listes: (front, back)
     - front: la partie avant de la file, dans le bon ordre
     - back: la partie arrière de la file, en ordre inverse *)
  type 'a t = 'a list * 'a list

  let empty = ([], [])

  let is_empty = function
    | ([], []) -> true
    | _ -> false

  (* L'invariant : si 'front' est vide, on la remplace par 'back' inversée. *)
  let norm = function
    | ([], back) -> (List.rev back, [])
    | q -> q

  let enqueue x (front, back) =
    norm (front, x :: back)

  let peek = function
    | ([], _) -> None
    | (h :: _, _) -> Some h

  let dequeue = function
    | ([], _) -> None
    | (h :: t, back) -> Some (h, norm (t, back))
end
Note sur la fonction norm : La vidéo présente une logique légèrement différente où la normalisation est effectuée uniquement au besoin dans dequeue. L'approche ci-dessus avec une fonction norm appelée par enqueue et dequeue est une variante courante qui maintient l'invariant de manière plus systématique. Les deux approches aboutissent au même résultat de complexité amortie. Pour l'agrégation, la maîtrise de l'une de ces variantes est attendue.
3. Implémentation du BFS avec la File Fonctionnelle
Maintenant que nous disposons d'une représentation de graphe (int list array) et d'une file fonctionnelle efficace (FunctionalQueue), nous pouvons assembler le tout pour implémenter le BFS.
Nous allons écrire une fonction bfs qui prend un graphe et un sommet de départ, et qui renvoie un tableau des distances de chaque sommet par rapport à la source. Une distance de -1 signifiera que le sommet est inaccessible.
L'algorithme sera implémenté via une fonction auxiliaire récursive, qui est l'équivalent fonctionnel de la boucle while de l'algorithme impératif. Cette fonction prendra en paramètres l'état courant : la file des sommets à visiter et le tableau des distances (qui sert aussi de tableau de "visités").
Voici l'implémentation complète et commentée.
(* On suppose que le module FunctionalQueue de l'exercice précédent est défini ici *)
module FQueue = FunctionalQueue

(* Le type graphe de la leçon précédente *)
type graphe = int list array

(*
  bfs graph start_node
  @param graph Le graphe (int list array).
  @param start_node Le sommet de départ pour le parcours.
  @return Un tableau où l'élément à l'index i est la distance entre
          start_node et i. -1 si inaccessible.
*)
let bfs (graph : graphe) (start_node : int) : int array =
  let n = Array.length graph in
  (* dist.(i) stocke la distance de start_node à i.
     Initialisé à -1 (non visité).
     Cet usage d'une structure mutable (array) pour les distances est une
     concession à la performance, classique et acceptée en OCaml, même
     dans un style fonctionnel, pour les algorithmes sur les graphes. *)
  let dist = Array.make n (-1) in

  (* Initialisation *)
  dist.(start_node) <- 0;
  let queue = FQueue.empty |> FQueue.enqueue start_node in

  (* La fonction récursive qui simule la boucle while *)
  let rec loop q =
    match FQueue.dequeue q with
    | None -> () (* La file est vide, le parcours est terminé *)
    | Some (u, next_q) ->
        let current_dist = dist.(u) in
        let neighbors = graph.(u) in

        (* 'fold_left' pour traiter chaque voisin de manière fonctionnelle *)
        let final_q = List.fold_left
          (fun acc_q v ->
            if dist.(v) = -1 then (* Si le voisin n'a pas été visité *)
              begin
                dist.(v) <- current_dist + 1; (* Mise à jour de la distance *)
                FQueue.enqueue v acc_q       (* On l'ajoute à la file *)
              end
            else
              acc_q (* Sinon, on ne change rien *)
          )
          next_q (* La file initiale pour ce tour est next_q *)
          neighbors (* La liste sur laquelle on itère *)
        in
        loop final_q (* Appel récursif avec la nouvelle file *)
  in

  loop queue;
  dist (* On retourne le tableau des distances *)
;;

(* ----- Exemple d'utilisation ----- *)
(* Reprenons le graphe de l'exercice de la leçon précédente *)
(* Graphe: 0->1, 0->2, 1->2, 2->0, 2->3, 3->3 *)
let g1 : graphe = [|
  [1; 2];      (* Voisins du sommet 0 *)
  [2];         (* Voisins du sommet 1 *)
  [0; 3];      (* Voisins du sommet 2 *)
  [3]          (* Voisins du sommet 3 *)
|];;

let distances_from_2 = bfs g1 2;;
(* On s'attend à obtenir :
   dist(2->0) = 1
   dist(2->1) = 2 (via 2->0->1)
   dist(2->2) = 0
   dist(2->3) = 1
   Le tableau devrait être [| 1; 2; 0; 1 |] *)

(* Affichage pour vérification *)
Array.iteri (fun i d -> Printf.printf "Distance from 2 to %d = %d\n" i d) distances_from_2;;
Prenez le temps d'étudier ce code. L'état (la file q) est passé explicitement d'un appel récursif à l'autre. La seule mutation concerne le tableau dist, une optimisation pragmatique pour éviter de passer une map ou une structure de données plus lourde à chaque appel.
Conclusion
Cette leçon vous a mené au cœur de l'algorithmique fonctionnelle en combinant un algorithme classique (BFS) avec une structure de données persistante non-triviale (la file fonctionnelle).
Points clés à retenir :
- Le BFS explore un graphe par niveaux et repose sur une file d'attente (FIFO).
- Une implémentation naïve d'une file avec la concaténation de listes (
@) est inefficace car son coût est linéaire. - La file fonctionnelle à deux listes est une structure classique qui atteint un coût amorti constant pour ses opérations, la rendant parfaitement adaptée.
- La structure récursive de l'implémentation du BFS en OCaml (
loop q) est un idiome commun pour traduire les boucles impératives dans un style fonctionnel. - L'utilisation d'un tableau mutable pour les distances ou les marques de visite est une pratique courante et efficace, un compromis pragmatique entre pureté fonctionnelle et performance.
Dans la prochaine et dernière leçon de ce module, nous prendrons du recul pour discuter des concepts théoriques que nous venons de mettre en pratique : l'immutabilité, la transparence référentielle et les avantages qu'ils apportent en termes de raisonnement sur le code et de concurrence.