Bonjour.
Lors de notre leçon précédente, nous avons implémenté la liste chaînée, une structure qui excelle pour les insertions et suppressions en tête en , mais impose un coût de recherche en . Nous avons vu que les tableaux, à l'inverse, offrent un accès par indice en mais rendent les insertions/suppressions coûteuses en .
Aujourd'hui, nous nous attaquons à une structure de données qui vise à combiner le meilleur des deux mondes : la table de hachage (ou dictionnaire, tableau associatif). L'ambition est d'atteindre une complexité moyenne en temps constant, , pour la recherche, l'insertion et la suppression. Cet objectif, s'il est atteint, est d'une puissance considérable pour de très nombreux problèmes algorithmiques.
Notre objectif pour cette leçon est d'expliquer le principe d'une table de hachage, le rôle de la fonction de hachage et la résolution des collisions par chaînage. Nous nous concentrerons sur les concepts fondamentaux, préparant ainsi le terrain pour l'implémentation pratique dans la leçon suivante.
1. Le besoin d'une structure associative efficace
Imaginons que nous devions stocker des données sous forme de paires (clé, valeur) — par exemple, un annuaire associant des noms à des numéros de téléphone. Comment le ferions-nous efficacement ? Une liste ou un tableau d'objets (nom, téléphone) nous obligerait à parcourir potentiellement toute la structure pour trouver un numéro, ce qui est inefficace.
Pour bien saisir la problématique, je vous propose de commencer par une courte lecture.
Table d'association ou table de Hachage - Introduction
Ce document de Grenoble INP pose le problème de manière très concrète avec l'exemple d'un annuaire, et montre pourquoi les structures de données que nous connaissons déjà (tableaux, listes) ne sont pas optimales.
Lisez la section 1, "Introduction : de la nécessité des tables". Concentrez-vous sur l'analyse des limites des tableaux et des listes pour le problème posé.
Le document met en évidence une idée simple mais puissante : si seulement nous pouvions utiliser les clés (par exemple, les noms) comme des indices dans un tableau, l'accès serait direct et en . Malheureusement, les indices d'un tableau sont des entiers, pas des chaînes de caractères.
2. Le principe : La fonction de hachage
C'est ici qu'intervient le concept central de la table de hachage. L'idée est de conserver la structure efficace du tableau et de trouver un moyen de transformer n'importe quelle clé (chaîne de caractères, objet complexe, etc.) en un indice de tableau valide (un entier). Ce mécanisme de transformation est appelé une fonction de hachage.
Fonction de hachage : Une fonction qui prend en entrée une clé de type quelconque et retourne un entier, appelé valeur de hachage (hash). Cet entier est ensuite typiquement ramené dans l'intervalle des indices du tableau (par exemple, avec une opération modulo) pour obtenir l'indice final.
clé -> fonction de hachage -> valeur de hachage (entier) -> indice du tableau
La vidéo suivante, issue du cours d'algorithmique du MIT, expose de manière très claire ce passage du concept d'accès direct à celui de hachage.
Cette vidéo explique la transition d'un tableau à accès direct (qui serait idéal mais irréalisable en pratique à cause de la taille de l'univers des clés) vers une table de hachage utilisant une fonction pour compresser l'espace des clés.
Regardez de 15:31 à 26:18. Concentrez-vous sur : Le concept du "direct access array" et son problème fondamental : l'espace mémoire requis peut être gigantesque. L'introduction de la fonction de hachage (h) comme une carte d'un grand univers de clés U vers un petit espace d'indices m.
Ce principe est la pierre angulaire des tables de hachage. Cependant, il soulève immédiatement une question critique.
3. Le problème inévitable : les collisions
Si nous mappons un grand ensemble de clés possibles (l'univers ) vers un petit ensemble d'indices (de 0 à , où est la taille du tableau), le principe des tiroirs (pigeonhole principle) nous assure qu'il est inévitable que plusieurs clés différentes produisent le même indice. C'est ce qu'on appelle une collision.
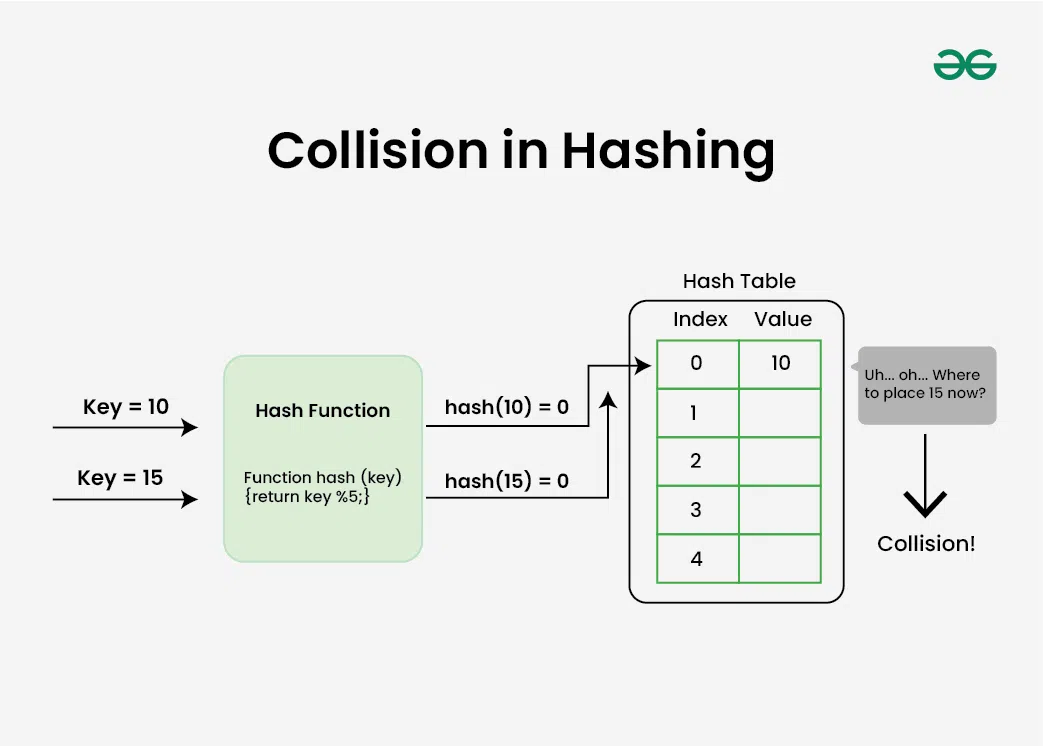
Une bonne fonction de hachage vise à minimiser la probabilité de collisions en répartissant les clés de manière aussi uniforme que possible sur l'ensemble des indices. Les propriétés essentielles d'une bonne fonction de hachage sont :
- Rapidité : Le calcul du hachage doit être très rapide, sinon on perd tout l'avantage de la structure.
- Déterminisme : La même clé doit toujours produire le même hachage.
- Uniformité : La fonction doit bien répartir les clés sur les indices disponibles pour éviter de créer des "points chauds" où les collisions s'accumulent.
La méthode de hachage la plus simple est la méthode de la division : indice = hash(clé) mod M. Pour cette méthode, le choix de (la taille du tableau) est crucial. Il est fortement recommandé de choisir pour un nombre premier qui n'est pas trop proche d'une puissance de 2. Cela aide à mieux répartir les clés qui pourraient avoir des motifs réguliers. Vous pouvez trouver une explication détaillée de ce point dans la section 2.2.3 du document de l'Université Paris Cité (ressource LINK).
Même avec la meilleure des fonctions, les collisions restent possibles. Il nous faut donc une stratégie pour les gérer.
4. La solution classique : le chaînage séparé
L'une des stratégies les plus courantes et les plus simples à comprendre pour résoudre les collisions est le chaînage séparé (separate chaining).
L'idée est la suivante : au lieu que chaque case du tableau contienne directement une valeur, elle contient un pointeur vers une autre structure de données qui stocke toutes les paires (clé, valeur) ayant produit cet indice. Et quelle structure est parfaitement adaptée pour stocker une liste d'éléments de taille variable et permettre des ajouts rapides ? La liste chaînée, que nous avons étudiée lors de la leçon précédente.
Chaque case du tableau de hachage devient donc la tête d'une liste chaînée. Ces listes sont souvent appelées "alvéoles" ou "buckets".
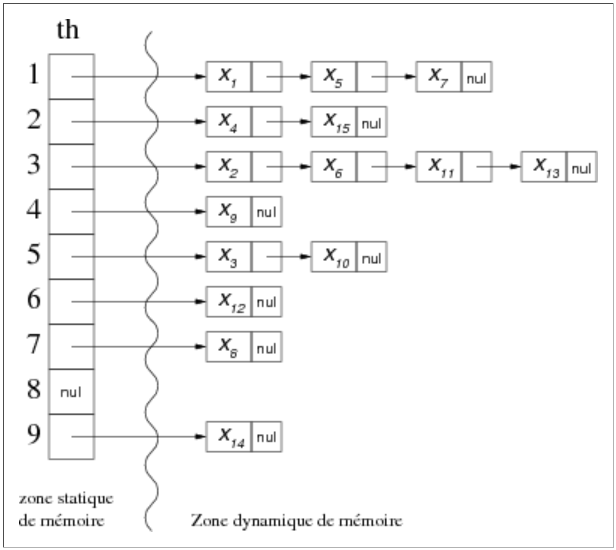
Pour voir ce mécanisme en action, je vous propose deux courtes vidéos. La première explique le concept et la seconde le visualise de manière très concrète.
Cette première vidéo très courte formalise ce qu'est le chaînage séparé et comment il résout le problème des collisions.
Regardez la première minute de la vidéo (00:00 à 01:07). Elle définit clairement le rôle de la structure de données auxiliaire (typiquement, une liste chaînée).
Maintenant, voyons une illustration pas à pas de l'insertion dans une table de hachage avec chaînage.
Regardez de 01:07 à 04:36. Observez comment, lorsqu'une collision se produit (par exemple, à l'indice 4), le nouvel élément est simplement ajouté à la fin de la liste chaînée existante.
Avec le chaînage séparé, les opérations de base se redéfinissent comme suit :
- Insertion(clé, valeur) :
- Calculer
indice = hash(clé) mod M. - Ajouter la paire
(clé, valeur)à la liste chaînée située àtableau[indice]. L'ajout en tête de liste est une opération en .
- Calculer
- Recherche(clé) :
- Calculer
indice = hash(clé) mod M. - Parcourir la liste chaînée à
tableau[indice]pour trouver la clé exacte (car plusieurs clés peuvent être dans la même liste).
- Calculer
- Suppression(clé) :
- Calculer
indice = hash(clé) mod M. - Parcourir la liste chaînée à
tableau[indice]pour trouver la clé et la supprimer de la liste (en manipulant les pointeurs comme nous l'avons appris).
- Calculer
Analyse de complexité
Le facteur de charge () d'une table de hachage est défini comme , où est le nombre d'éléments stockés et est la taille du tableau. Ce facteur représente la longueur moyenne des listes chaînées.
- Pire cas : Toutes les clés que nous insérons hachent vers le même indice. Notre table de hachage dégénère en une unique liste chaînée. Les opérations de recherche, d'insertion (si on vérifie la non-présence) et de suppression deviennent en .
- Cas moyen (attendu) : Si notre fonction de hachage est suffisamment "aléatoire" (hypothèse d'hachage uniforme simple), la longueur attendue d'une chaîne est . Si nous maintenons constant (par exemple, en redimensionnant le tableau lorsque devient trop grand par rapport à ), alors les opérations de recherche, d'insertion et de suppression se font en temps moyen . Le "1" représente le calcul du hachage et l'accès au tableau, et représente le parcours de la courte liste chaînée.
C'est cette performance attendue en qui fait des tables de hachage l'une des structures de données les plus utiles et les plus utilisées en pratique.
Conclusion
Aujourd'hui, nous avons décortiqué la théorie derrière les tables de hachage. C'est un changement de paradigme par rapport aux structures basées sur la comparaison ou la position séquentielle.
Points clés à retenir :
- Une table de hachage associe des clés à des valeurs en utilisant une fonction de hachage pour transformer une clé en un indice de tableau.
- L'objectif est d'atteindre une complexité moyenne de pour l'insertion, la suppression et la recherche.
- Les collisions (plusieurs clés mappées au même indice) sont inévitables.
- Le chaînage séparé est une stratégie de résolution de collision où chaque entrée du tableau pointe vers une liste chaînée contenant tous les éléments qui hachent à cet indice.
- La performance dépend crucialement de la qualité de la fonction de hachage et du maintien d'un facteur de charge faible.
Dans notre prochaine leçon, nous mettrons cette théorie en pratique. Nous allons implémenter les opérations d'une table de hachage avec chaînage en Python, en nous appuyant directement sur la classe LinkedList que nous avons construite précédemment. Vous verrez à quel point la théorie d'aujourd'hui et la pratique de la leçon passée s'articulent parfaitement.