Bonjour,
Dans la leçon précédente, nous avons étudié le parcours en largeur (BFS) et vu comment sa stratégie d'exploration par "couches" à l'aide d'une file (FIFO) permet de trouver les plus courts chemins dans un graphe non pondéré.
Aujourd'hui, nous abordons son "frère jumeau" : le parcours en profondeur, ou Depth-First Search (DFS). Comme son nom l'indique, cet algorithme privilégie l'exploration en profondeur : il s'enfonce le plus loin possible dans une branche du graphe avant de revenir sur ses pas (un processus appelé backtracking) pour explorer les alternatives.
L'objectif de cette leçon est de vous rendre capable d'implémenter le parcours en profondeur de manière récursive et itérative. Comprendre ces deux facettes d'un même algorithme est une compétence essentielle, non seulement pour le DFS lui-même, mais aussi pour votre compréhension générale des liens entre récursivité et itération.
1. L'intuition du parcours en profondeur
Si le BFS explore le graphe comme une onde qui se propage, le DFS se comporte plutôt comme un explorateur dans un labyrinthe qui suit un chemin jusqu'à une impasse, puis revient à la dernière intersection pour essayer une autre voie.
Pour visualiser cette philosophie, la vidéo suivante propose une excellente démonstration intuitive.
Depth First Search (DFS) Explained: Algorithm, Examples, and Code
La vidéo "Depth First Search (DFS) Explained" de la chaîne Reducible illustre de manière très claire le principe du DFS. Concentrez-vous sur la logique d'exploration : avancer tant que c'est possible, puis revenir en arrière.
Regardez le segment de 01:23 à 04:18. Observez comment l'explorateur virtuel choisit un chemin, le suit jusqu'à un 'cul-de-sac' (un sommet dont tous les voisins ont déjà été vus), puis 'revient sur ses pas' pour explorer une autre branche.
Cette stratégie "plonge d'abord" est rendue possible en changeant simplement la structure de données utilisée pour stocker les sommets à visiter : au lieu de la file (FIFO) du BFS, le DFS utilise une pile (LIFO - Last-In, First-Out).
2. L'implémentation itérative avec une pile explicite
Commençons par la version itérative, qui rend l'utilisation de la pile explicite. Le principe est très proche de celui du BFS, mais le comportement est radicalement différent.
Algorithme DFS itératif :
- Initialiser une pile vide et y empiler le sommet de départ
s. - Initialiser un ensemble
visitepour marquer les sommets déjà traités. - Tant que la pile n'est pas vide :
a. Dépiler un sommetu.
b. Siun'a pas été visité :
i. Marquerucomme visité.
ii. Traiteru(par exemple, l'ajouter à une liste de résultats).
iii. Pour chaque voisinvdeu, empilervsur la pile.
Le fait d'empiler les voisins et de toujours traiter le sommet au sommet de la pile garantit que l'on explore le plus récemment découvert en premier, nous menant ainsi en profondeur.
La vidéo suivante illustre parfaitement ce mécanisme.
Parcours en largeur et en profondeur d'un graphe | Réseaux de neurones 1
La vidéo "Parcours en largeur et en profondeur d'un graphe" d'Alexandre TL (en français) détaille l'exécution du DFS itératif. Elle fait suite à une brève introduction distinguant file et pile que nous allons inclure.
Regardez d'abord le segment de 04:04 à 05:22 pour bien saisir la distinction entre file (BFS) et pile (DFS). Puis, suivez attentivement l'exécution pas à pas de 07:03 à 08:31, en observant comment la pile (nommée 'à traiter') se remplit et se vide, dictant l'ordre de visite.
Implémentation en Python
En Python, une simple liste (list) peut servir de pile, en utilisant les méthodes append() pour empiler et pop() pour dépiler.
def dfs_iterative(graph, start_node):


    # graph: dictionnaire {sommet: [voisins]}

    stack = [start_node]
    visited = set()
    traversal_order = []

    while stack:
        node = stack.pop()

        if node not in visited:
            visited.add(node)
            traversal_order.append(node)


            # Empiler les voisins. Notez que l'ordre d'ajout peut changer le parcours.
            # Inverser les voisins pour un parcours plus "naturel" (ex: de gauche à droite)
            for neighbor in reversed(graph.get(node, [])):
                if neighbor not in visited:
                    stack.append(neighbor)

    return traversal_order
Note : L'instruction reversed() est une astuce. Si les voisins d'un sommet sont [B, C] et que vous les empilez dans cet ordre (B puis C), C sera traité avant B. Inverser la liste des voisins avant de les empiler permet souvent d'obtenir un parcours qui correspond à celui de la version récursive, plus intuitive.
3. L'implémentation récursive : l'élégance de la pile implicite
La nature du DFS se prête magnifiquement à une formulation récursive. La complexité de la gestion de la pile est alors déléguée au système, via ce qu'on appelle la pile d'appels (ou call stack).
Chaque fois que vous appelez une fonction, ses informations (variables locales, point de retour) sont empilées sur la pile d'appels. Lorsqu'une fonction se termine, elle est dépilée. Un appel récursif consiste donc à empiler une nouvelle instance de la même fonction. C'est exactement le comportement LIFO dont nous avons besoin.
Algorithme DFS récursif :
fonction DFS_rec(graphe, sommet_u, visite):
    marquer sommet_u comme visité
    traiter sommet_u

    pour chaque voisin v de sommet_u:
        si v n'a pas été visité:
            DFS_rec(graphe, v, visite)
C'est tout. La "pile" est gérée implicitement par les appels récursifs imbriqués.
La vidéo suivante explique remarquablement ce lien fondamental entre récursivité et pile d'appels, avant de l'appliquer au DFS.
Parcours en largeur et en profondeur d'un graphe | Réseaux de neurones 1
Cette partie de la vidéo d'Alexandre TL est cruciale. Elle démystifie la récursivité en montrant comment la pile d'appels de Python gère implicitement le mécanisme que nous avons codé manuellement avec une pile dans la version itérative.
Regardez attentivement le segment de 10:00 à 13:11. L'exemple de la fonction factorielle est une excellente introduction à la pile d'appels. Assurez-vous de bien comprendre comment la récursivité dans l'algorithme DFS remplace la gestion explicite de la pile.
Implémentation en Python
La version récursive est souvent plus concise et considérée comme plus élégante.
def dfs_recursive(graph, start_node):


    # graph: dictionnaire {sommet: [voisins]}

    visited = set()
    traversal_order = []

    def _dfs_util(node):
        visited.add(node)
        traversal_order.append(node)

        for neighbor in graph.get(node, []):
            if neighbor not in visited:
                _dfs_util(neighbor)

    _dfs_util(start_node)
    return traversal_order
4. Synthèse et comparaison formelle
Pour une préparation à l'Agrégation, il est important de pouvoir se référer à des descriptions formelles.
[PDF] Quelques rappels sur la théorie des graphes - CNRS
Le document du CNRS "Quelques rappels sur la théorie des graphes" présente les pseudo-codes formels pour les deux approches.
Consultez la page 10, 'Algorithme 3' pour la version itérative, puis la page 11, 'Algorithme 4' pour la version récursive. Comparez ces pseudo-codes avec les implémentations Python que nous venons de voir. Notez que la version formelle inclut des détails supplémentaires comme le calcul des dates de découverte et de fin, qui sont des éléments clés pour des applications plus avancées que nous verrons plus tard.
Récursif ou Itératif ?
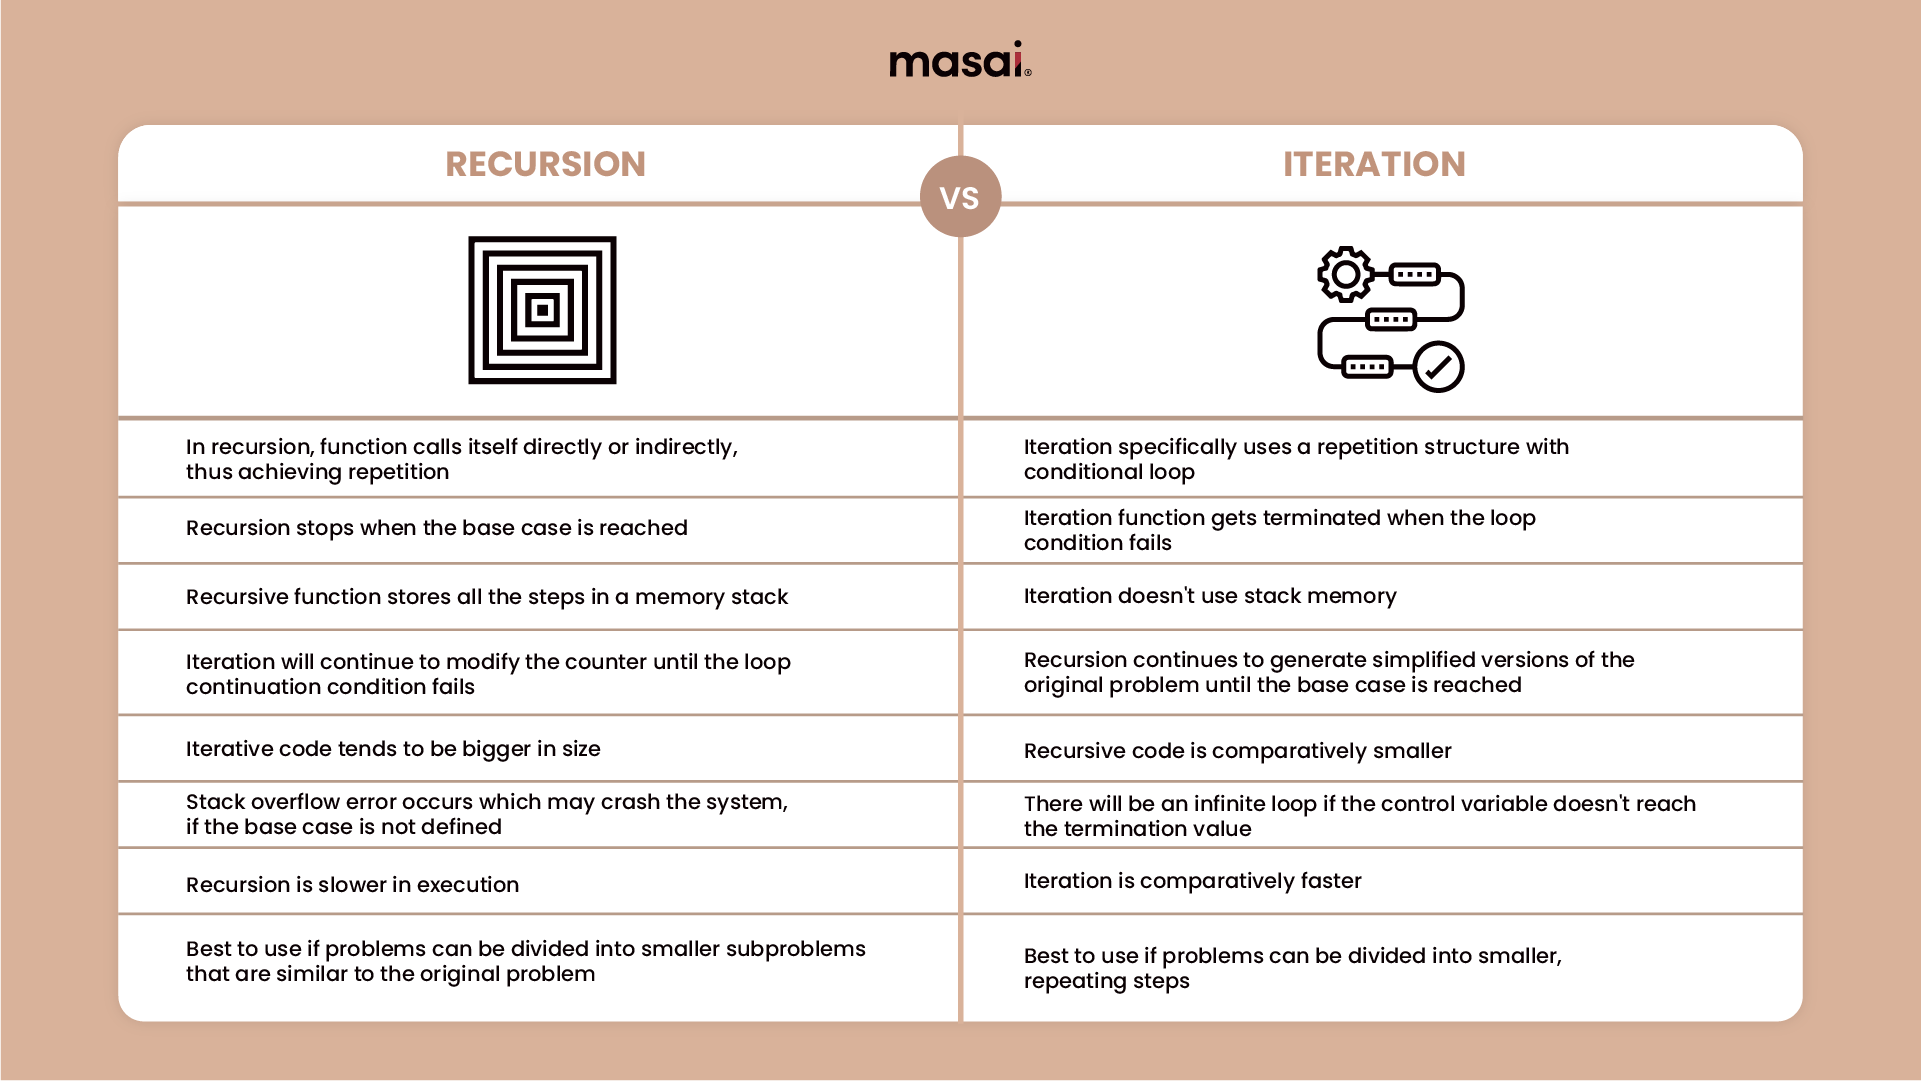
La complexité du DFS, quelle que soit l'implémentation, est de (ou où est le nombre de sommets et le nombre d'arêtes), car chaque sommet est visité une fois et chaque arête est traversée une fois (deux fois pour un graphe non orienté).
5. Exercice d'application
Appliquons maintenant nos connaissances. Considérons le graphe orienté suivant :

Le graphe peut être représenté par la liste d'adjacence suivante :graph = {0: [1, 2], 1: [], 2: [3, 4], 3: [4], 4: []}
Votre tâche (15 minutes) :
-
Trace itérative : En partant du sommet
0, déroulez l'algorithme DFS itératif. À chaque itération de la bouclewhile, notez :- Le sommet dépilé.
- L'état de la pile après avoir ajouté les voisins.
- L'ensemble des sommets visités.
- Quel sera l'ordre de parcours final (
traversal_order) ?
-
Trace récursive : En partant du sommet
0, déroulez l'algorithme DFS récursif. Montrez la séquence des appels récursifs (par exemple,_dfs_util(0)appelle_dfs_util(1)qui retourne, puis_dfs_util(0)appelle_dfs_util(2), etc.).- Quel sera l'ordre de parcours final ? Est-il identique à celui de la version itérative (avec l'astuce
reversed) ?
- Quel sera l'ordre de parcours final ? Est-il identique à celui de la version itérative (avec l'astuce
Prenez le temps de faire cet exercice sur papier. Il est essentiel pour solidifier votre compréhension des deux mécanismes.
Conclusion
Le parcours en profondeur est un algorithme aussi fondamental que le BFS, mais avec un caractère très différent. Sa capacité à s'enfoncer dans le graphe en fait un outil de choix pour de nombreuses applications.
Points clés à retenir :
- Le DFS explore un graphe en suivant une branche jusqu'au bout avant de revenir en arrière.
- Il s'appuie sur une structure de données LIFO (pile).
- L'implémentation itérative utilise une pile explicite (une liste en Python).
- L'implémentation récursive, souvent plus élégante, utilise la pile d'appels implicite du système.
- Les deux approches ont la même complexité mais des compromis différents en termes d'écriture et de robustesse (risque de stack overflow pour la récursivité).
Prochaine étape :
Maintenant que nous maîtrisons le mécanisme du DFS, nous allons l'utiliser pour résoudre un premier problème classique : la détection de cycles dans un graphe orienté. Nous verrons comment une simple modification du marquage des sommets (en utilisant des couleurs) pendant le parcours nous permet d'identifier efficacement les "retours en arrière" qui signalent la présence d'un cycle.