Bonjour,
Dans la leçon précédente, nous avons vu comment un parcours de graphe permet d'identifier les composantes connexes dans un graphe non orienté. Le concept de connexité y est symétrique : si un chemin existe de à , un chemin existe de à .
Aujourd'hui, nous abordons la notion de connectivité dans les graphes orientés, où cette symétrie disparaît. L'existence d'un chemin de à ne garantit en rien l'existence d'un chemin retour. Cette subtilité nous conduit à une notion plus forte et plus riche : la composante fortement connexe (CFC). L'objectif de cette leçon est de vous apprendre à appliquer des algorithmes de parcours pour identifier ces composantes, une compétence fondamentale et un sujet classique pour l'Agrégation.
1. Définition des Composantes Fortement Connexes (CFC)
Dans un graphe orienté , deux sommets et sont dits mutuellement accessibles s'il existe un chemin de vers ET un chemin de vers .
Cette relation de mutuelle accessibilité est une relation d'équivalence. Ses classes d'équivalence sont appelées les composantes fortement connexes du graphe.
Une composante fortement connexe est donc un sous-ensemble maximal de sommets tel que pour toute paire de sommets dans cet ensemble, on peut aller de à et de à .
La vidéo suivante introduit ce concept de manière très claire, en le contrastant avec la connexité simple des graphes non orientés.
Composantes fortement connexes d'un graphe orienté : c'est quoi ?
Cette vidéo de la chaîne 'À la découverte des graphes' pose les bases de la forte connexité. Elle vous aidera à visualiser ce que représente une CFC.
Regardez la vidéo jusqu'à 05:35. Concentrez-vous sur : La distinction entre connexité simple (graphes non orientés) et forte connexité (graphes orientés). La notion de 'double flèche' (chemin aller et retour) qui définit l'appartenance à une même CFC. L'exemple de partition du graphe en plusieurs CFC, dont certaines peuvent ne contenir qu'un seul sommet.

2. Algorithme de Kosaraju : Une approche en deux passes
Comment identifier ces CFC de manière algorithmique ? Un simple parcours en profondeur (DFS) depuis un sommet arbitraire ne suffit pas. Comme le montre le début de la vidéo suivante, un tel parcours peut "déborder" d'une CFC pour en visiter d'autres.
L'algorithme de Kosaraju propose une solution élégante en deux passes, toutes deux basées sur le DFS.
-
Première passe : On effectue un DFS sur le graphe original . L'objectif est de déterminer les dates de fin de traitement de chaque sommet. Une manière simple de s'en souvenir est d'empiler les sommets sur une pile au fur et à mesure qu'ils deviennent noirs (c'est-à-dire, après avoir exploré tous leurs descendants). Le sommet au sommet de la pile est celui qui a terminé en dernier.
-
Deuxième passe :
a. On calcule le graphe transposé, noté , obtenu en inversant le sens de tous les arcs de .
b. On effectue un DFS sur . La boucle principale de ce DFS ne choisit pas les sommets dans un ordre arbitraire, mais dans l'ordre de fin de traitement décroissant de la première passe (c'est-à-dire en les dépilant de la pile créée à l'étape 1).
c. Chaque arbre de la forêt DFS obtenue lors de cette seconde passe correspond exactement à une composante fortement connexe.
La vidéo ci-dessous détaille admirablement cet algorithme.
Algorithme pour les composantes fortement connexes d'un graphe orienté.
Cette seconde vidéo du même auteur explique et déroule l'algorithme de Kosaraju sur le même graphe d'exemple. C'est une ressource de choix pour comprendre le mécanisme en profondeur.
Regardez les sections suivantes : Pourquoi un seul DFS ne suffit pas (01:17 - 05:12) : Comprenez bien le problème du 'débordement' qui motive une approche plus sophistiquée. Partie 1 - DFS sur G (05:12 - 10:15) : Suivez la première passe et la construction de la liste (ou pile) des sommets ordonnée par date de fin. Partie 2 - DFS sur G-transposé (10:15 - 15:20) : Observez comment le parcours sur le graphe inversé, en utilisant l'ordre de la première passe, isole parfaitement chaque CFC.
Synthèse de l'algorithme de Kosaraju
Soit un graphe orienté .
- Appeler
DFS(G)pour calculer les dates de fin pour tout sommet . (Ou empiler les sommets à la fin de leur visite). - Calculer .
- Appeler
DFS(G^T), mais dans la boucle principale, considérer les sommets par ordre décroissant de . - Les arbres de la forêt de parcours de la 2ème étape sont les CFC de .
La complexité de l'algorithme est dominée par les deux parcours DFS. Le calcul du graphe transposé est aussi en . La complexité totale est donc , ce qui est optimal.
3. Algorithme de Tarjan : Une approche en une seule passe
Il existe un autre algorithme classique, souvent jugé plus subtil, qui identifie les CFC en une seule passe de DFS : l'algorithme de Tarjan. Il est essentiel de le connaître pour l'Agrégation.
L'idée est d'associer à chaque sommet deux valeurs lors du DFS :
d[u], la date de découverte (un simple compteur incrémenté à chaque visite).low[u](our[u]dans certaines notations), la plus petite date de découverte accessible depuis (y compris lui-même) en suivant des arcs de l'arbre DFS, puis au plus un arc "retour" (un arc menant d'un sommet à un de ses ancêtres dans l'arbre DFS).
Un sommet est la racine d'une CFC si et seulement si d[u] == low[u].
Lors du DFS, on maintient une pile des sommets en cours de visite. Quand on identifie une racine , tous les sommets sur la pile jusqu'à (inclus) forment une CFC.
Le document ci-dessous fournit une explication formelle, le pseudo-code et une preuve de correction de l'algorithme de Tarjan.
[PDF] Notes de cours d'algorithmique – L3
Ce document de cours de niveau L3 offre une présentation rigoureuse de l'algorithme de Tarjan, indispensable pour une préparation sérieuse.
Lisez les sections 6, 6.1 et 6.2 (pages 50 à 59). Section 6 : Comprenez la propriété clé qui lie les CFC à la forêt de parcours en profondeur. Section 6.1 : Focalisez-vous sur la définition du coefficient r[x] (équivalent à low[x]) et la propriété 23 qui stipule qu'un sommet x est racine d'une CFC ssi r(x) = d[x]. Section 6.2 : Étudiez les algorithmes 12 et 13. Essayez de faire le lien entre le pseudo-code et le calcul des coefficients rA[x] et l'utilisation de la pile P.
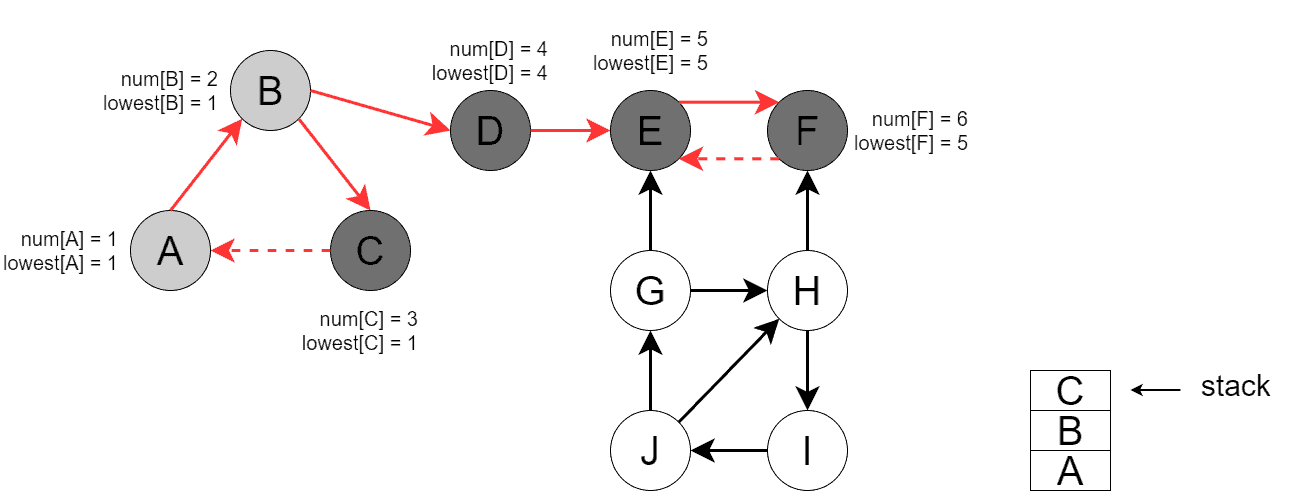
La complexité de l'algorithme de Tarjan est également de . Bien que plus complexe à appréhender, son implémentation en une seule passe le rend souvent plus efficace en pratique.
Conclusion
La notion de composante fortement connexe est un des piliers de l'analyse structurelle des graphes orientés. Sa maîtrise est non négociable pour votre concours.
Points clés à retenir :
- Une CFC est un ensemble maximal de sommets mutuellement accessibles dans un graphe orienté.
- L'algorithme de Kosaraju identifie les CFC en deux passes de DFS : la première sur pour ordonner les sommets, la seconde sur pour extraire les composantes. Son principe est robuste et plus simple à démontrer.
- L'algorithme de Tarjan est une méthode plus avancée en une seule passe, qui utilise des valeurs de "low-link" pour identifier les racines des CFC durant le parcours.
- Les deux algorithmes ont une complexité linéaire en , ce qui est optimal. Ils illustrent la puissance du parcours en profondeur comme outil d'investigation algorithmique.
Prochaine étape :
Nous avons jusqu'ici exploré la structure de "qui peut atteindre qui". Dans notre prochaine leçon, nous introduirons une nouvelle dimension : le coût des déplacements. Nous commencerons à étudier les algorithmes de plus court chemin dans les graphes pondérés, en débutant par le célèbre algorithme de Dijkstra.