Bonjour,
Dans la leçon précédente, nous avons implémenté l'algorithme de Prim pour trouver un arbre couvrant de poids minimum (MST). Nous avons vu que cet algorithme, très similaire à celui de Dijkstra, construit l'arbre de manière progressive en partant d'un sommet et en y agrégeant l'arête la moins chère connectée à un nouveau sommet.
Aujourd'hui, nous allons étudier une structure de données fondamentale, l'Union-Find (aussi appelée Disjoint Set Union ou DSU). Cette structure est non seulement élégante et extrêmement performante, mais elle est aussi la pierre angulaire de l'algorithme de Kruskal, l'autre grande méthode pour calculer des MST que nous verrons dans la prochaine leçon. L'objectif de cette leçon est donc d'implémenter la structure Union-Find avec ses deux optimisations majeures : la compression de chemins et l'union par rang.
1. Le Problème des Ensembles Disjoints
Imaginez que vous avez une collection d'éléments et que vous souhaitez les regrouper en ensembles disjoints (c'est-à-dire sans aucun élément commun). La structure Union-Find est conçue pour gérer efficacement ces ensembles avec deux opérations principales :
union(a, b): Fusionne l'ensemble contenant l'élémentaavec celui contenant l'élémentb.find(a): Renvoie un identifiant unique, ou "représentant", pour l'ensemble auquel appartient l'élémenta. Cette opération permet de vérifier si deux élémentsaetbsont dans le même ensemble, simplement en testant sifind(a) == find(b).
Cette structure est utilisée pour résoudre de nombreux problèmes, comme la détection de composantes connexes dans un graphe ou la détection de cycles.
Pour visualiser le concept et comprendre son implémentation de base, je vous propose de regarder la vidéo suivante.
Structure de données : le UnionFind
Cette vidéo de Grafikart.fr introduit la structure Union-Find de manière très claire et pratique. Elle explique le problème que la structure résout et présente l'idée fondamentale d'une représentation sous forme d'arborescence.
Regardez la vidéo du début jusqu'à 06:04. Concentrez-vous sur la définition du problème, les deux opérations find et union, et la première implémentation avec un tableau de parents où chaque élément est initialement son propre parent.
La représentation la plus courante pour une structure Union-Find est une forêt d'arbres. Chaque arbre représente un ensemble, et la racine de l'arbre est le représentant de cet ensemble. Pour implémenter cela, nous utilisons un simple tableau parent où parent[i] contient le parent de l'élément i. Si parent[i] == i, alors i est une racine.
2. Les Limites d'une Implémentation Naïve et les Optimisations
Une implémentation naïve, où lors d'une union on attache arbitrairement une racine à l'autre, peut conduire à des arbres très déséquilibrés, qui dégénèrent en de longues chaînes. Dans ce pire des cas, une opération find pourrait nécessiter de parcourir tous les éléments, menant à une complexité linéaire , ce qui est inefficace.
Pour pallier ce problème, deux optimisations sont presque toujours utilisées conjointement. Elles permettent d'atteindre une complexité quasi constante en pratique.
Optimisation 1 : Union par Rang (ou Taille)
Pour éviter de créer des arbres longs et fins, on utilise une heuristique lors de l'opération union. L'idée est d'attacher systématiquement l'arbre le plus "petit" à la racine de l'arbre le plus "grand".
Il y a deux manières courantes de mesurer la "grandeur" d'un arbre :
- Union par taille : On maintient la taille (nombre de nœuds) de chaque ensemble et on attache l'ensemble le plus petit au plus grand.
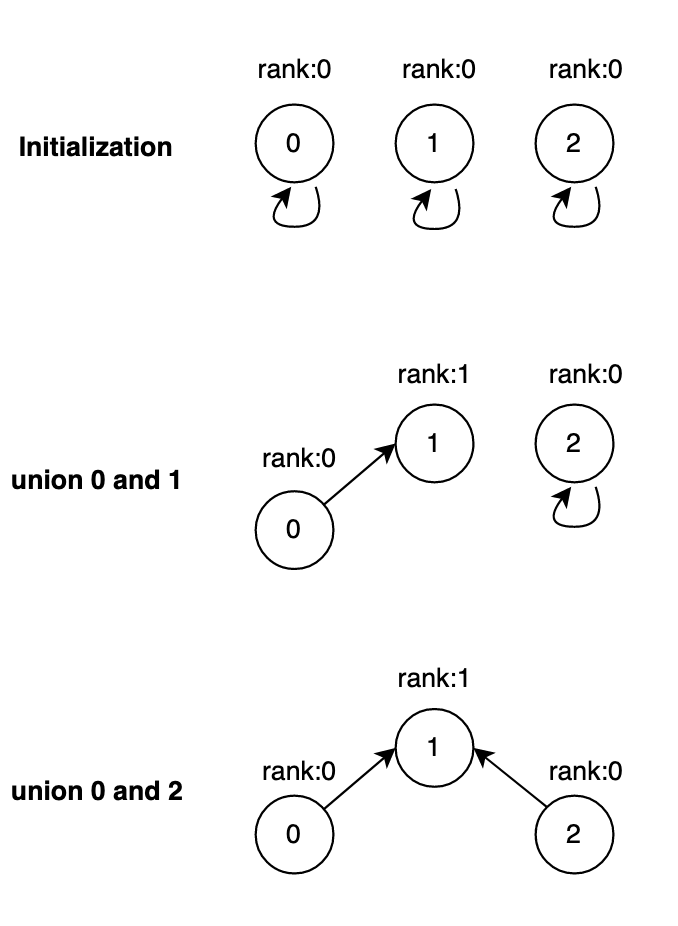
- Union par rang : On maintient le "rang" de chaque racine, qui est une borne supérieure de la hauteur de l'arbre. On attache l'arbre de plus petit rang à celui de plus grand rang.
Ces deux approches sont très similaires et visent le même objectif : garder les arbres aussi plats que possible.
La vidéo suivante explique très bien l'union par taille, qui est conceptuellement équivalente à l'union par rang.
Structure de données : le UnionFind
Cette partie de la vidéo de Grafikart.fr explique l'optimisation par "groupement par taille" (union by size). Elle montre pourquoi il est préférable d'attacher le plus petit arbre au plus grand pour minimiser la hauteur globale.
Regardez la section de 12:00 à 15:56. Observez comment un tableau sizes est utilisé pour suivre la taille de chaque ensemble et comment la logique de l'union est modifiée pour prendre cette information en compte.
Pour visualiser l'union par rang, qui est la terminologie la plus classique attendue en concours, observez l'image suivante.
Optimisation 2 : Compression de Chemins
Cette optimisation accélère considérablement l'opération find. L'idée est simple : chaque fois que l'on parcourt un chemin depuis un nœud x jusqu'à sa racine r, on en profite pour "aplatir" ce chemin en rattachant tous les nœuds rencontrés directement à la racine r.
Ainsi, les futures opérations find sur ces mêmes nœuds (ou leurs descendants) seront beaucoup plus rapides, car le chemin vers la racine aura été drastiquement raccourci.
Structure de données : le UnionFind
Cette section de la même vidéo explique la compression de chemins. C'est une optimisation très puissante qui a lieu pendant l'opération find.
Regardez de 10:27 à 12:06. Notez comment, après avoir trouvé la racine, la fonction find modifie les pointeurs parent des nœuds sur le chemin pour qu'ils pointent directement vers la racine.
L'image ci-dessous illustre parfaitement cet effet d'aplatissement.

3. Implémentation en Python
Maintenant, mettons en pratique ces deux optimisations. Une bonne pratique est d'encapsuler la logique dans une classe. Nous utiliserons des listes pour représenter les tableaux parent et rank.
La vidéo suivante, bien qu'en anglais, propose une implémentation Python très propre et didactique que nous allons suivre.
Number of Connected Components in an Undirected Graph - Union Find - Leetcode 323 - Python
Cette vidéo de NeetCode propose une implémentation complète en Python de la structure Union-Find, incluant l'union par rang et la compression de chemins, dans le contexte d'un problème LeetCode (compter les composantes connexes).
Regardez les sections suivantes : De 04:25 à 05:20 : Introduction des tableaux parent et de la forêt d'arbres. De 05:56 à 07:42 : Explication de l'union par rang (appelée rank mais basée sur la taille, ce qui est conceptuellement identique). De 11:15 à 14:36 : Implémentation en direct des fonctions find (avec compression de chemins) et union (avec union par rang). Concentrez-vous sur la logique du code Python.
En nous basant sur cette approche, voici une implémentation Python complète que vous devez maîtriser.
class UnionFind:
    """
    Implémentation de la structure de données Union-Find avec union par rang
    et compression de chemins.
    """
    def __init__(self, n):
        """
        Initialise la structure pour n éléments, de 0 à n-1.
        Chaque élément est initialement dans son propre ensemble.
        """


        # parent[i] stocke le parent de l'élément i.
        self.parent = list(range(n))


        # rank[i] stocke le rang (hauteur) de l'arbre dont i est la racine.
        self.rank = [0] * n

    def find(self, i):
        """
        Trouve le représentant de l'ensemble contenant i, avec compression de chemins.
        """


        # Si i n'est pas la racine de son arbre
        if self.parent[i] != i:


            # On rattache i directement à la racine de son arbre.
            # C'est ici que la compression de chemin a lieu, de manière récursive.
            self.parent[i] = self.find(self.parent[i])
        return self.parent[i]

    def union(self, i, j):
        """
        Fusionne les ensembles contenant i et j, en utilisant l'union par rang.
        Retourne True si une fusion a eu lieu, False sinon.
        """


        # 1. Trouver les représentants des deux ensembles.
        root_i = self.find(i)
        root_j = self.find(j)


        # 2. Si les éléments sont déjà dans le même ensemble, ne rien faire.
        if root_i == root_j:
            return False


        # 3. Union par rang : attacher l'arbre de plus petit rang à celui de plus grand rang.
        if self.rank[root_i] < self.rank[root_j]:
            self.parent[root_i] = root_j
        elif self.rank[root_i] > self.rank[root_j]:
            self.parent[root_j] = root_i
        else:


            # Si les rangs sont égaux, on choisit arbitrairement un nouveau parent
            # et on incrémente son rang.
            self.parent[root_j] = root_i
            self.rank[root_i] += 1

        return True


```grasp
{
  "type": "exercise",
  "id": "9c4cc719-5ceb-4082-9d7d-5ee6bc2d92b9"
}
--- Exemple d'utilisation ---
if name == 'main':
# Créons une structure pour 10 éléments (0 à 9)
uf = UnionFind(10)

print("Initial parent:", uf.parent)

uf.union(1, 2)
uf.union(3, 4)
uf.union(1, 3) # Fusionne les ensembles {1, 2} et {3, 4}

print("Parent après quelques unions:", uf.parent)
print("Rang après quelques unions: ", uf.rank)


# Test de find avec compression de chemins
print(f"Représentant de 4 : {uf.find(4)}") # find(4) va rattacher 4 à la racine
print("Parent après find(4):", uf.parent)

print(f"1 et 4 sont dans le même ensemble: {uf.find(1) == uf.find(4)}") # Devrait être True
print(f"1 et 5 sont dans le même ensemble: {uf.find(1) == uf.find(5)}") # Devrait être False
**Exercice :**
Exécutez ce code pas à pas avec un débogueur ou des `print` pour tracer les changements dans les tableaux `parent` et `rank`. Assurez-vous de bien comprendre comment la compression de chemin modifie `parent` lors d'un appel à `find`, et comment l'`union` met à jour les tableaux en fonction des rangs.

---


### 4. Analyse de Complexité

Lorsqu'on utilise conjointement l'union par rang et la compression de chemins, la complexité amortie par opération est **$O(\alpha(n))$**, où $\alpha(n)$ est la **fonction inverse d'Ackermann**.

Cette fonction croît de manière extraordinairement lente. Pour toute valeur de $n$ que l'on peut manipuler en pratique (même des nombres plus grands que le nombre d'atomes dans l'univers), $\alpha(n)$ ne dépasse pas 5. Pour le concours, vous pouvez donc considérer que les opérations se font en **temps quasi constant**.

Le document suivant, destiné à la préparation de l'agrégation, confirme cette analyse et la situe dans le contexte attendu.

```grasp
{
  "type": "reading",
  "title": "Quelques développements pour l'agrég de maths",
  "id": "[LINK](https://nguyentito.eu/vieux-fr/dev-info.pdf)",
  "url": "https://nguyentito.eu/vieux-fr/dev-info.pdf",
  "relevant_section_indices": [
    0,
    1,
    2
  ],
  "par_intro": "Ce document, tiré de notes pour l'agrégation de mathématiques option informatique, formalise la structure Union-Find et ses optimisations. Il énonce le théorème sur la complexité amortie, qui est un résultat théorique important à connaître.",
  "par_directions": "Lisez la section 3 \"Union-find avec compression de chemin\". Portez une attention particulière à la description des deux optimisations (union par rang et compression de chemins) et au théorème qui énonce la complexité amortie. Notez le pseudo-code qui formalise l'implémentation.",
  "estimated_time": "5 minutes"
}
Conclusion
Aujourd'hui, nous avons disséqué l'une des structures de données les plus élégantes et efficaces de l'algorithmique.
Les points clés à retenir :
- La structure Union-Find gère une partition d'un ensemble d'éléments et supporte efficacement les opérations
unionetfind. - Elle est implémentée comme une forêt d'arbres, stockée dans un tableau de parents.
- Les optimisations d'union par rang (pour garder les arbres plats) et de compression de chemins (pour raccourcir les chemins vers la racine) sont cruciales.
- Combinées, ces optimisations donnent une complexité amortie quasi constante (), un résultat théorique majeur.
Nous sommes maintenant équipés d'un outil puissant. Dans la prochaine leçon, nous l'appliquerons directement pour implémenter l'algorithme de Kruskal, qui adopte une approche gloutonne différente de celle de Prim pour construire un arbre couvrant de poids minimum. Vous verrez que grâce à Union-Find, la détection de cycles, qui est au cœur de l'algorithme de Kruskal, devient une opération triviale et ultra-rapide.