Bonjour.
Dans notre leçon précédente, nous avons établi les fondations mathématiques de l'analyse d'algorithmes en définissant formellement les notations asymptotiques O, Ω et Θ. Vous avez appris à prouver rigoureusement qu'une fonction de coût, comme , appartient à une classe de complexité, par exemple .
Aujourd'hui, nous passons de l'abstrait au concret. L'objectif est d'appliquer ces outils à des algorithmes réels. À la fin de cette leçon, vous saurez calculer la complexité temporelle dans le pire des cas et la complexité spatiale d'un algorithme itératif. Il s'agit d'une compétence absolument centrale, qui consiste à traduire un fragment de code en une expression de complexité, nous permettant ainsi de raisonner sur son efficacité.
1. Modèle de calcul et coût des opérations
Pour analyser un algorithme, nous devons d'abord définir ce que nous comptons. Nous ne mesurons pas le temps en secondes, mais en nombre d'opérations élémentaires. Nous faisons l'hypothèse que notre algorithme s'exécute sur une machine idéalisée (souvent appelée modèle RAM - Random Access Machine) où certaines opérations de base ont un coût constant, que nous notons .
La question devient alors : quelles opérations sont considérées comme élémentaires ?
Complexité d'un algorithme I Généralités
Pour répondre à cette question de manière pragmatique, ce document de cours destiné aux CPGE détaille les opérations que nous considérons comme ayant un coût constant en Python. C'est notre catalogue de 'briques de base' pour le calcul de complexité.
Lisez attentivement la section I.2 'Mesure de la complexité temporelle'. Concentrez-vous sur la liste des opérations considérées comme élémentaires (opérations arithmétiques, comparaisons, affectations, accès à un élément de liste par son index, etc.). Notez également les exemples d'opérations qui ne sont PAS élémentaires (ex: la recherche d'un élément dans une liste).
En résumé, vous pouvez considérer les opérations suivantes comme coûtant :
- Affectation de variable (
x = 5,c = c + 1) - Opérations arithmétiques (
+,-,*,/) - Comparaisons (
==,<,>) - Instructions de contrôle (
if,for,while- l'instruction elle-même, pas le bloc qu'elle exécute) - Accès à un élément de liste par son indice (
t[i]) - Appel à
len(t)sur une liste.
Avec ce catalogue, nous pouvons définir plus formellement nos deux mesures de complexité :
- Complexité temporelle : C'est une fonction qui lie la taille de l'entrée, notée , au nombre d'opérations élémentaires exécutées par l'algorithme dans le pire des cas.
- Complexité spatiale : C'est une fonction qui lie la taille de l'entrée à la quantité de mémoire supplémentaire (en plus de celle requise pour stocker l'entrée) utilisée par l'algorithme.
Par défaut, et c'est la convention à l'Agrégation, lorsque l'on demande "la complexité", il s'agit de la complexité temporelle asymptotique dans le pire des cas.
2. Une méthode systématique pour le calcul
Analyser la complexité d'un algorithme itératif n'est pas un art divinatoire ; c'est une procédure systématique qui repose sur quelques règles simples pour combiner les coûts des opérations de base.
La vidéo suivante expose ces règles de manière très claire et pédagogique.
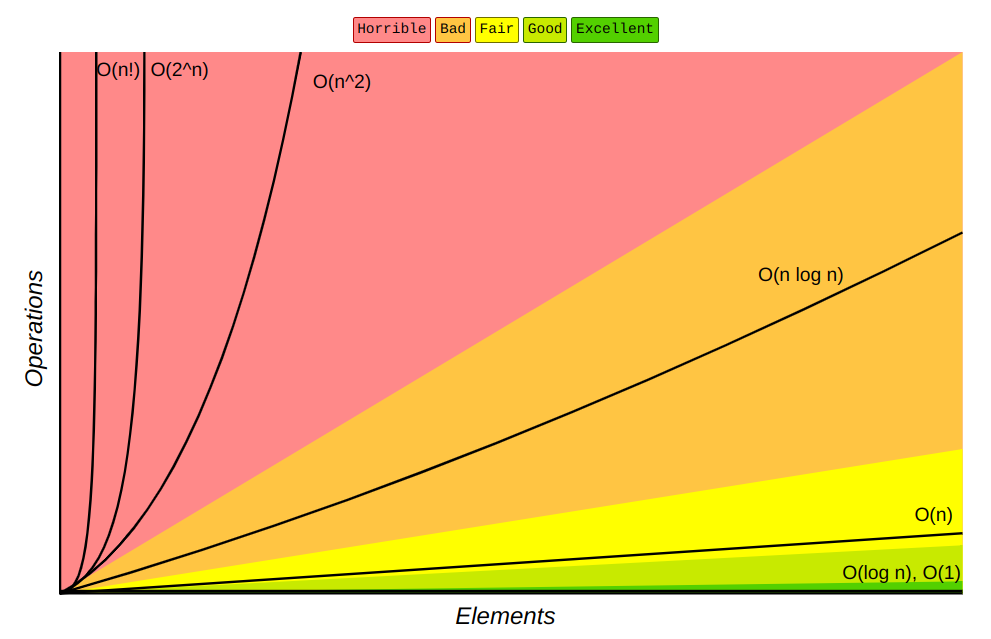
Algorithme 22: Complexité d'un algorithme O(1), O(log n), O(n), O(n log n), O(2^n), O(n!).
Cette vidéo de Hassan EL BAHI est une excellente ressource qui formalise les règles de calcul de complexité pour les structures algorithmiques de base (séquences, conditions, boucles).
Regardez la section de 33:56 à 43:42. Concentrez-vous sur la manière de calculer la complexité pour : Les instructions de base (Règle 1). Les séquences de blocs (Règle 4). Les structures conditionnelles si/sinon (Règle 3). Les boucles (Règle 2). Les règles de simplification asymptotique (Règles 5, 6, 7), qui sont une application directe de ce que nous avons vu dans la leçon précédente.
Synthétisons ces règles fondamentales :
-
Séquence d'instructions : Si un bloc d'instructions A est suivi d'un bloc B, la complexité de la séquence est le maximum des deux.
En notation asymptotique, cela revient à une somme, car le terme dominant absorbe les autres : . Par exemple, . -
Instruction conditionnelle : Pour un
if-else, la complexité dans le pire des cas est celle du test, plus la complexité de la branche la plus coûteuse. -
Boucle : La complexité d'une boucle est (approximativement) le nombre d'itérations multiplié par la complexité (dans le pire des cas) du corps de la boucle. C'est la règle la plus importante.
3. Exemples d'application
Appliquons cette méthode à des algorithmes Python concrets.
Exemple 1 : Complexité Linéaire O(n) et Spatiale O(1)
Considérons une fonction simple qui cherche le nombre d'occurrences d'un élément dans une liste. C'est l'exemple nbre_occurrences du document LINK.
def nbre_occurrences(x, t):


    # n = len(t) est la taille de l'entrée

    c = 0                   # 1. Coût O(1)

    for i in range(len(t)): # 2. Boucle exécutée n fois
        if t[i] == x:       # 3. Corps de la boucle, coût O(1)
            c = c + 1       # 4. (partie du corps)

    return c                # 5. Coût O(1)
Analyse de la complexité temporelle :
- Ligne 1 (
c = 0): Une affectation, coût . - Ligne 2 (
for...): La boucle s'exécute fois, où . - Ligne 3 (
if...): À l'intérieur de la boucle, le testt[i] == ximplique un accès (t[i]) et une comparaison (==), les deux sont . Si le test est vrai, la ligne 4 (c = c+1) coûte aussi . Le corps de la boucle a donc une complexité de dans le pire des cas. - Ligne 5 (
return c): Coût .
La complexité totale est la somme des complexités séquentielles : .
Le terme dominant est .
Donc, la complexité temporelle de l'algorithme est .
Analyse de la complexité spatiale :
Nous devons compter la mémoire supplémentaire allouée.
- L'entrée
tetxne compte pas. - L'algorithme utilise deux variables :
c(un entier) eti(l'index de la boucle).
La taille de ces variables ne dépend pas de la taillende la liste. La mémoire utilisée est constante.
La complexité spatiale est donc .
Exemple 2 : Complexité Quadratique O(n²)
Analysons deux cas de boucles imbriquées (inspirés de f1 et f2 dans LINK).
Cas A : Boucles carrées
def f1(n):
    x = 0
    for i in range(n):      # Boucle externe: n itérations
        for j in range(n):  # Boucle interne: n itérations
            x += 1          # Coût O(1)
    return x
La boucle interne exécute une opération , fois. Son coût est donc .
La boucle externe exécute cette boucle interne (de coût ), fois.
La complexité totale est .
Cas B : Boucles triangulaires
def f2(n):
    x = 0
    for i in range(n):      # Boucle externe: n itérations
        for j in range(i):  # Boucle interne: i itérations
            x += 1          # Coût O(1)
    return x
Ici, le nombre d'itérations de la boucle interne dépend de la variable i de la boucle externe.
- Quand
i = 0, la boucle interne fait 0 tour. - Quand
i = 1, la boucle interne fait 1 tour. - ...
- Quand
i = n-1, la boucle interne faitn-1tours.
Le nombre total d'exécutions de x += 1 est la somme . C'est la somme d'une série arithmétique :
Cette fonction est bien . La complexité est quadratique, même si le nombre d'opérations est environ la moitié du cas précédent.
Exemple 3 : Complexité Logarithmique O(log n)
Considérons une boucle où la variable de contrôle est divisée à chaque étape (inspiré de f3 dans LINK).
def f3(n):
    x, i = 0, n
    while i > 1:    # Combien d'itérations?
        x += 1      # Coût O(1)
        i //= 2     # Division entière par 2
    return x
La question est : combien de fois peut-on diviser n par 2 avant d'atteindre 1 ?
Soit le nombre d'itérations. Les valeurs successives de i sont approximativement .
La boucle s'arrête lorsque , c'est-à-dire .
Le nombre d'itérations est donc de l'ordre de . Comme le corps de la boucle est en , la complexité temporelle est .
Exercice
Mettez en pratique la méthode sur cet algorithme (inspiré de f4 dans LINK). Quelle est sa complexité temporelle dans le pire des cas ?
def f4(n):
    x, i = 0, n
    while i > 1:
        for j in range(n):
            x += 1
        i //= 2
    return x
Analysez-le pas à pas :
- Identifiez la boucle externe (
while) et la boucle interne (for). - Calculez la complexité de la boucle interne.
- Déterminez combien de fois la boucle externe s'exécute.
- Combinez les deux pour trouver la complexité totale.
Solution
1. La boucle externe est la boucle while, la boucle interne est la boucle for.
2. La boucle interne for j in range(n) exécute une opération O(1), n fois. Sa complexité est donc O(n).
3. La boucle externe while i > 1 s'exécute log₂(n) fois, comme nous l'avons vu dans l'exemple 3.
4. La complexité totale est le produit du nombre d'itérations de la boucle externe par la complexité de son corps (qui est dominé par la boucle interne). Cela donne : $$ O(\log n) \times O(n) = O(n \log n) $$ La complexité de cet algorithme est quasi-linéaire.
Conclusion
Aujourd'hui, nous avons franchi une étape cruciale en appliquant nos outils mathématiques à du code. Vous avez appris une méthode systématique pour analyser la performance d'algorithmes itératifs.
Points clés à retenir :
- Le calcul de complexité repose sur un modèle d'opérations élémentaires coûtant .
- La complexité temporelle est le nombre de ces opérations en fonction de la taille de l'entrée , dans le pire des cas.
- La complexité spatiale mesure la mémoire additionnelle requise.
- L'analyse se fait systématiquement en combinant les coûts des séquences (max), conditions (max des branches) et boucles (produit).
Dans notre prochaine leçon, nous changerons de perspective. Après avoir analysé la performance d'un algorithme ("à quelle vitesse s'exécute-t-il ?"), nous nous demanderons s'il produit le bon résultat ("fonctionne-t-il ?"). Pour cela, vous découvrirez un outil formel puissant pour prouver la correction d'un algorithme itératif : l'invariant de boucle.