Merhaba! Önceki dersimizde, bir PySpark dönüşüm fonksiyonu için tek bir "mutlu yol" (happy path) senaryosunu test eden bir birim testi yazdık. assertDataFrameEqual kullanarak dönüşümün çıktısının beklenen DataFrame ile eşleştiğini doğruladık. Bu, test altyapımızın temelini oluşturmak için harika bir adımdı.
Ancak gerçek dünya verileri nadiren bu kadar temiz ve öngörülebilirdir. Veri işlem hatlarınızın (data pipelines) sağlam (robust) olması için null değerler, boş metinler (empty strings) veya beklenmedik formatlar gibi sınır durumlarını (edge cases) da doğru şekilde işlemesi gerekir. Her bir senaryo için ayrı bir test fonksiyonu yazmak (test_with_null_values, test_with_empty_strings vb.) hızla yönetilemez hale gelir ve kod tekrarına yol açar.
Bu derste, bu sorunu zarif bir şekilde çözen güçlü bir pytest özelliğini öğreneceğiz: pytest.mark.parametrize. Bu özellik sayesinde, aynı test mantığını birden çok girdi ve beklenen çıktı senaryosuyla çalıştırarak kodumuzu daha verimli bir şekilde daha kapsamlı test edebileceğiz.
Parametrizasyon: Neden ve Nasıl?
Yazılım testinde temel bir ilke, kodu tekrar etmemektir (Don't Repeat Yourself - DRY). Eğer birden çok test, küçük veri farklılıkları dışında aynı adımları izliyorsa, bu bir kod kokusudur (code smell). parametrize, bu durumu çözmek için tasarlanmıştır.
Aşağıdaki görsel, her senaryo için ayrı test fonksiyonları yazmak ile aynı işi tek bir parametrize edilmiş test fonksiyonuyla yapmayı karşılaştırarak bu konsepti mükemmel bir şekilde özetliyor.
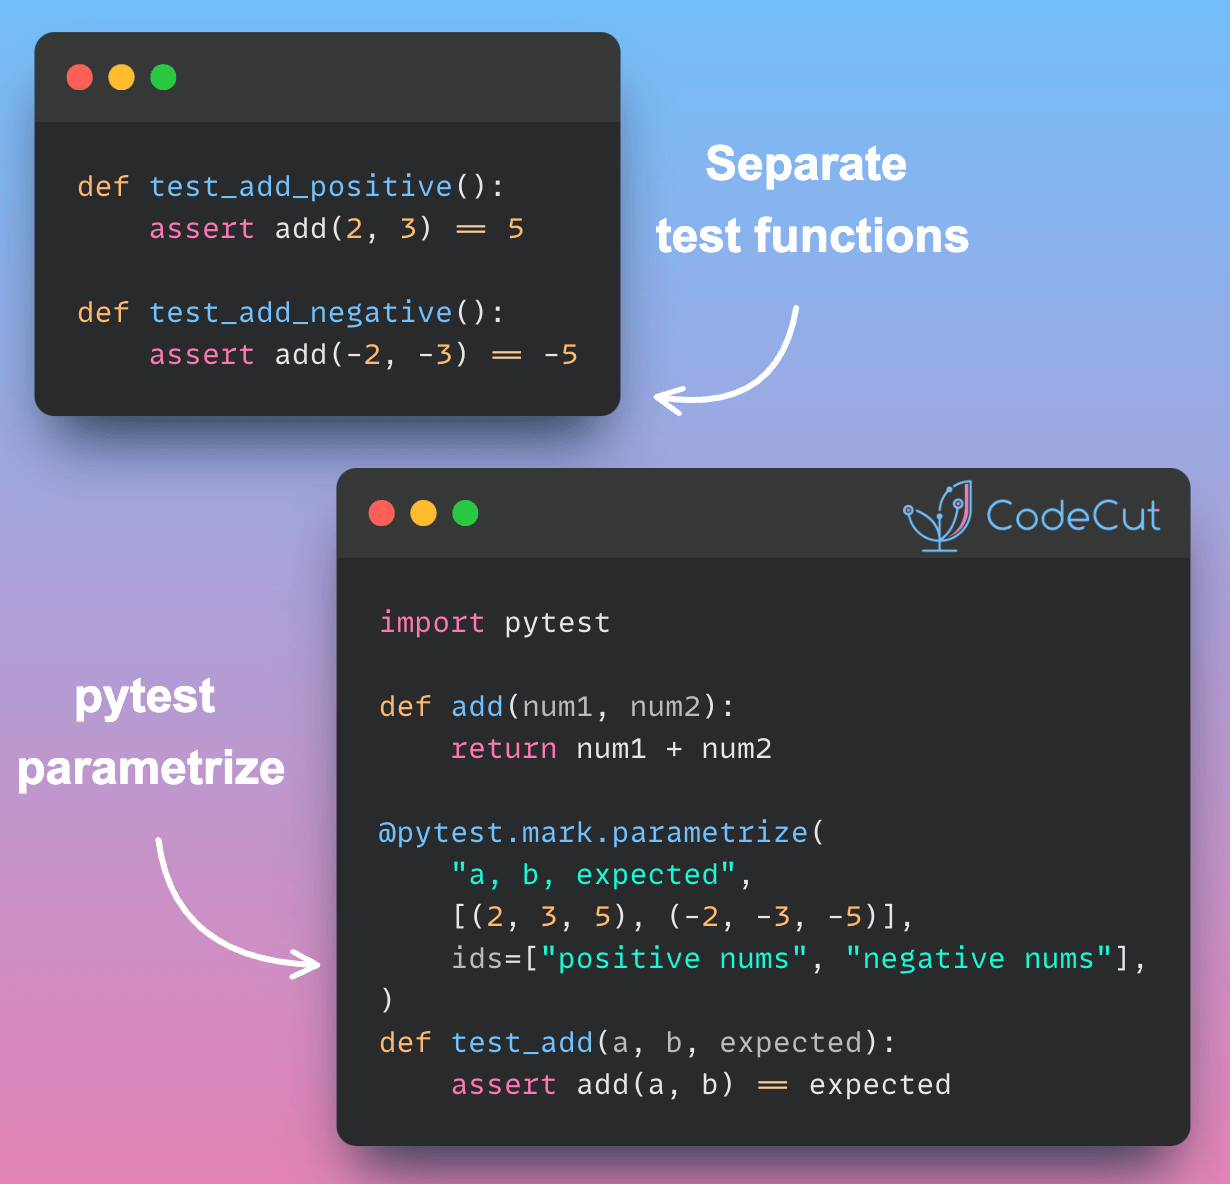
Gördüğünüz gibi, parametrize bir test fonksiyonunu bir şablona dönüştürür ve bu şablonu sağladığınız her bir veri seti için ayrı ayrı çalıştırır.
@pytest.mark.parametrize Sözdizimi
Parametrizasyonu nasıl kullanacağımızı anlamak için temel sözdizimini inceleyelim.
pytest's parametrize (beginner - intermediate) anthony explains #027
anthonywritescode kanalından bu video, pytest.mark.parametrize'ın arkasındaki mantığı ve temel kullanımını harika bir şekilde açıklıyor.
Videonun 01:23 - 04:29 arasındaki bölümünü izleyin. Sunucunun, bir square fonksiyonunu test etmek için yazdığı birden çok test fonksiyonunu nasıl tek bir parametrize edilmiş teste dönüştürdüğüne odaklanın. Sözdizimine dikkat edin: @pytest.mark.parametrize dekoratörü, parametre adlarını içeren bir string ('input_x, expected') ve test verilerini içeren bir demet (tuple) listesi.
Videodan da öğrendiğiniz gibi, @pytest.mark.parametrize dekoratörü iki temel argüman alır:
- Parametre Adları: Test fonksiyonunuza geçirilecek argüman adlarını içeren, virgülle ayrılmış bir string. Örnek:
"input_a, input_b, expected_output". - Parametre Değerleri: Her biri bir test senaryosunu temsil eden bir demet (tuple) listesi. Her demetin içindeki değerler, ilk argümandaki parametre adlarıyla sırayla eşleşir.
PySpark Testlerini Parametrize Etmek
Peki bu konsepti PySpark DataFrame'leriyle nasıl kullanırız? Parametre olarak bütün DataFrame nesnelerini geçirmek yerine, daha pratik bir yaklaşım benimseyeceğiz: DataFrame'i oluşturmak için gereken ham veriyi (örneğin, sözlük veya demet listeleri) parametrize edeceğiz. Test fonksiyonumuzun içinde, spark fixture'ını kullanarak bu ham veriden anlık olarak DataFrame'ler oluşturacağız.
Bu yaklaşım, testlerinizi daha okunabilir hale getirir, çünkü test verileri doğrudan test tanımının içinde açıkça görünür.
Aşağıdaki blog yazısı, bu deseni bir PySpark testinde nasıl uygulayacağınızı gösterir.
How to be Test Driven with Spark: Chapter 3 - First Spark test
Bu makale, Spark ile test güdümlü geliştirme (Test-Driven Development) üzerine odaklanıyor. Bizi ilgilendiren kısım, test verilerini test mantığından ayırmak için parametrize kullanımını göstermesi.
Makalede 'The actual test is still not ideal as test case generation is part of the test itself.' cümlesiyle başlayan bölümü bulun. Bu bölümdeki @pytest.mark.parametrize ile yazılmış kod örneğini inceleyin. Test verilerinin (demet listeleri ve şemalar) nasıl parametre olarak geçirildiğine ve DataFrame'lerin test fonksiyonunun içinde spark_session kullanılarak nasıl oluşturulduğuna dikkat edin.
Uygulama Zamanı: with_full_name Fonksiyonunu Sağlamlaştıralım
Şimdi öğrendiklerimizi bir araya getirme ve önceki derste yazdığımız test_with_full_name testini refaktör etme zamanı. Testimizi, null ve boş string gibi sınır durumlarını da kapsayacak şekilde genişleteceğiz.
tests/test_transformations.py dosyanızı açın ve test_with_full_name fonksiyonunu aşağıdaki gibi güncelleyin:
# tests/test_transformations.py

import pytest # pytest'i import etmeyi unutmayın
from etl_pipeline.transformations import with_full_name
from pyspark.testing.utils import assertDataFrameEqual


# ... diğer testler ...


# Test senaryolarımızı tanımlıyoruz
# Her senaryo: (input_data, expected_data) içeren bir demet
test_cases = [


    # 1. Senaryo: "Happy Path" - Normal veri
    (
        [{"first_name": "John", "last_name": "Doe"}],
        [{"first_name": "John", "last_name": "Doe", "full_name": "John Doe"}]
    ),


    # 2. Senaryo: Sınır Durumu - Soyadı null
    (
        [{"first_name": "Jane", "last_name": None}],
        [{"first_name": "Jane", "last_name": None, "full_name": None}]
    ),


    # 3. Senaryo: Sınır Durumu - Adı boş string
    (
        [{"first_name": "", "last_name": "Smith"}],
        [{"first_name": "", "last_name": "Smith", "full_name": " Smith"}] # concat_ws davranışı
    ),


    # 4. Senaryo: Sınır Durumu - İki isim de null
    (
        [{"first_name": None, "last_name": None}],
        [{"first_name": None, "last_name": None, "full_name": None}]
    )
]

@pytest.mark.parametrize("input_data, expected_data", test_cases)
def test_with_full_name(spark, input_data, expected_data):
    """
    'with_full_name' dönüşümünü çeşitli senaryolarla test eder:
    - Normal veri
    - Null değerler
    - Boş stringler
    """


    # 1. Arrange
    input_df = spark.createDataFrame(input_data)


    # Beklenen DataFrame'i oluştururken şemayı dinamik olarak belirliyoruz
    expected_df = spark.createDataFrame(expected_data)


    # 2. Act
    actual_df = with_full_name(input_df)


    # 3. Assert
    assertDataFrameEqual(actual_df, expected_df)
Terminalde pytest komutunu çalıştırdığınızda, pytest'in test_with_full_name fonksiyonunu test_cases listesindeki her bir eleman için ayrı ayrı çalıştırdığını göreceksiniz. Eğer bir hata olursa, pytest size tam olarak hangi senaryonun başarısız olduğunu söyleyecektir.
Test Raporlarını İyileştirme: Test ID'leri
pytest'i çalıştırdığınızda, çıktıdaki test adlarının test_with_full_name[0], test_with_full_name[1] gibi göründüğünü fark etmiş olabilirsiniz. Bu varsayılan adlandırma, hangi senaryonun başarısız olduğunu anlamayı zorlaştırabilir.
Neyse ki, pytest.param kullanarak her bir senaryoya özel, okunabilir bir kimlik (ID) atayabiliriz.
pytest's parametrize (beginner - intermediate) anthony explains #027
Şimdi, test raporlarımızı nasıl daha anlamlı hale getirebileceğimizi görelim. anthonywritescode'un videosunun bu kısa bölümü, pytest.param ile özel test ID'leri oluşturmayı gösteriyor.
Videonun 05:01 - 06:00 arasındaki bölümünü izleyin. pytest.param kullanarak her bir test senaryosuna id parametresi ile nasıl özel bir ad verildiğine dikkat edin.
Bu tekniği kendi kodumuza uygulayalım. tests/test_transformations.py dosyasındaki test_cases listesini şu şekilde güncelleyin:
# ... import'lar ...
import pytest


# ...


# Test senaryolarımızı pytest.param ile ve ID'lerle tanımlıyoruz
test_cases = [
    pytest.param(
        [{"first_name": "John", "last_name": "Doe"}],
        [{"first_name": "John", "last_name": "Doe", "full_name": "John Doe"}],
        id="happy_path"
    ),
    pytest.param(
        [{"first_name": "Jane", "last_name": None}],
        [{"first_name": "Jane", "last_name": None, "full_name": None}],
        id="null_last_name"
    ),
    pytest.param(
        [{"first_name": "", "last_name": "Smith"}],
        [{"first_name": "", "last_name": "Smith", "full_name": " Smith"}],
        id="empty_first_name"
    ),
    pytest.param(
        [{"first_name": None, "last_name": None}],
        [{"first_name": None, "last_name": None, "full_name": None}],
        id="all_null"
    )
]


# @pytest.mark.parametrize dekoratörü ve test_with_full_name fonksiyonu aynı kalır.
# ...
Şimdi pytest -v komutunu çalıştırırsanız, test çıktısında test_with_full_name[happy_path] PASSED gibi çok daha açıklayıcı isimler göreceksiniz. Bu, özellikle bir CI/CD ortamında test loglarını incelerken hayat kurtarıcıdır.
Özet ve Sonraki Adımlar
Bu dersle birlikte, PySpark ETL testlerinizi çok daha güçlü ve sürdürülebilir hale getiren önemli bir aracı cephanenize eklediniz.
Temel Çıkarımlar:
@pytest.mark.parametrize, tek bir test fonksiyonunu birden çok veri setiyle çalıştırarak kod tekrarını önler.- Bu özellik, veri dönüşüm fonksiyonlarını normal senaryolar, sınır durumları ve hata senaryoları gibi çeşitli koşullar altında test etmek için idealdir.
- PySpark testlerinde, DataFrame'lerin kendisini değil, onları oluşturmak için gereken ham veriyi parametrize etmek yaygın ve etkili bir desendir.
pytest.paramile özelid'ler kullanmak, test raporlarının okunabilirliğini büyük ölçüde artırır ve hata ayıklamayı kolaylaştırır.
Gelecek Dersin Önizlemesi:
Artık tekil fonksiyonlar için kapsamlı testler yazabiliyoruz. Ancak bir CI ortamında bu testleri çalıştırmak, sadece pytest komutunu girmekten ibaret değildir. Testleri seçerek çalıştırma, çıktıları yorumlama ve başarısızlık raporlarını anlama gibi becerilere ihtiyacımız olacak.
Bir sonraki dersimizde, pytest'i komut satırından nasıl etkili bir şekilde kullanacağımızı ve test sonuçlarını nasıl yorumlayacağımızı öğreneceğiz. Bu, testlerimizi otomatize edilmiş iş akışlarına entegre etmeden önceki son hazırlık adımımız olacak.