Bonjour !
Au cours des dernières leçons de ce module sur le web scraping, nous avons assemblé toutes les pièces du puzzle. Vous avez appris à récupérer du contenu web avec le nœud HTTP Request, à l'analyser avec HTML Extract et les sélecteurs CSS, à gérer la pagination, à respecter les sites avec le nœud Wait, et enfin, à paraître plus légitime en personnalisant les en-têtes User-Agent.
Il est temps de mettre toute cette théorie en pratique. Cette leçon est l'exercice de synthèse du module. Votre objectif est de construire un workflow de A à Z qui scrape les annonces de produits d'un site e-commerce et structure les données proprement. C'est une compétence fondamentale que vous pourrez appliquer à d'innombrables cas d'usage professionnels, de la veille concurrentielle à l'alimentation de bases de données.
Énoncé de l'Exercice
Votre mission est de construire un workflow n8n qui accomplit les tâches suivantes :
- Cible : Le site e-commerce de démonstration https://scrapeme.live/shop/.
- Action : Scraper tous les produits de la première page.
- Données à extraire pour chaque produit :
- Le nom du produit (ex: "Pikachu V-UNION Special Collection Box")
- Le prix (ex: "£24.99")
- L'URL de la page du produit (une URL absolue, ex:
https://scrapeme.live/shop/product/pikachu-v-union-special-collection-box/) - L'URL de l'image du produit (une URL absolue)
- Structuration : Le workflow doit produire en sortie une liste d'objets JSON propres, où chaque objet représente un produit avec les quatre champs ci-dessus.
- Bonnes pratiques : Votre nœud
HTTP Requestdoit utiliser unUser-Agentpersonnalisé pour simuler un vrai navigateur.
C'est parti !
Partie 1 : Récupérer le HTML de la Page
La première étape, comme toujours, est de récupérer le code source HTML de la page cible.
- Créez un nouveau workflow et démarrez avec un nœud
Triggerde type On-demand / Manual. - Ajoutez un nœud HTTP Request.
- Configurez-le comme suit :
- Request Method :
GET - URL :
https://scrapeme.live/shop/
- Request Method :
- Activez les Headers > Send Headers et sélectionnez Using JSON. Collez-y un en-tête
User-Agentréaliste, comme nous l'avons vu dans la leçon précédente :{ "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/125.0.0.0 Safari/537.36" } - Exécutez le nœud. Vous devriez voir le code HTML brut de la page en sortie.
Complete Guide to Building n8n Web Scraping Workflows (2025)
Cette première étape est la base de tout workflow de scraping. Cet article de Decodo, que nous utiliserons comme fil rouge, décrit précisément ce processus initial.
Relisez les étapes 1, 2 et 3 de la section "Simple product data pipeline". Elles correspondent exactement à ce que nous venons de faire : créer le workflow, ajouter un déclencheur manuel et configurer le nœud HTTP Request pour l'URL cible.
Partie 2 : Isoler les Blocs de Produits
Le HTML brut est inutilisable. Nous devons d'abord extraire les "cartes" ou "blocs" qui correspondent à chaque produit sur la page.
Pour cela, faites un clic droit sur un produit sur https://scrapeme.live/shop/ et choisissez "Inspecter" pour ouvrir les outils de développement de votre navigateur. Vous remarquerez que chaque produit est contenu dans une balise <li> avec la classe product. Le sélecteur CSS sera donc li.product.
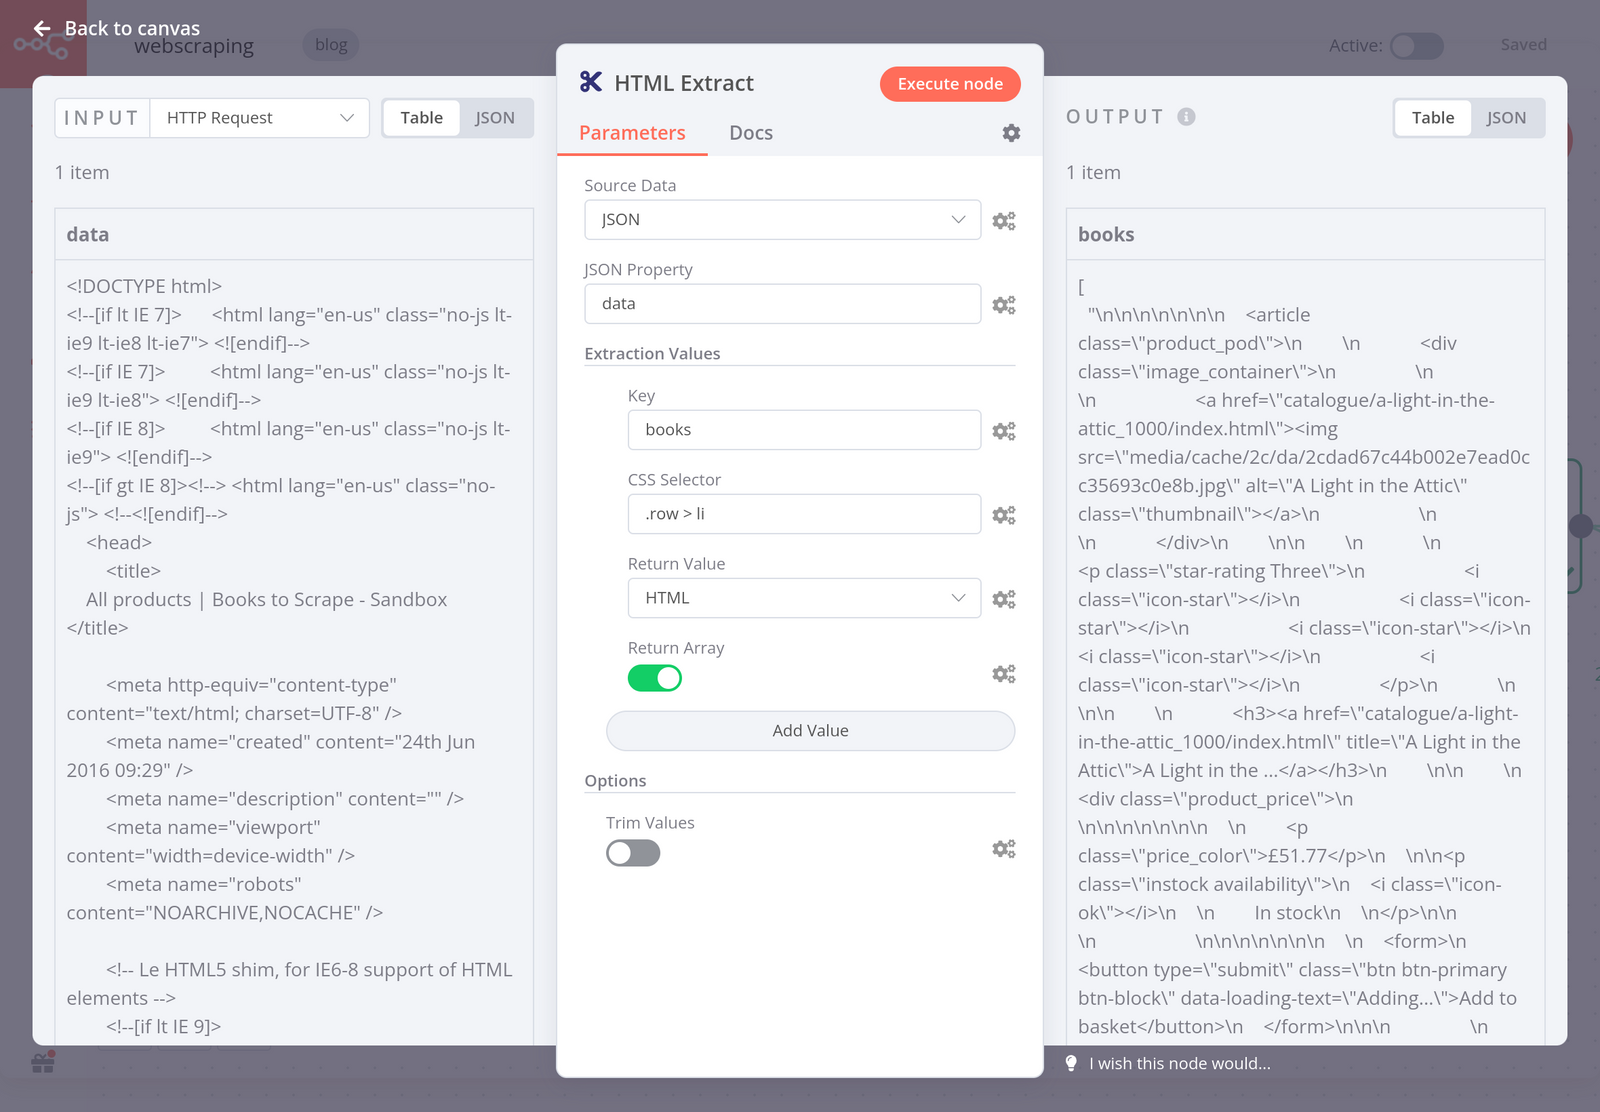
- Ajoutez un nœud HTML après votre nœud
HTTP Request. - Configurez-le pour extraire les blocs de produits :
- Operation :
Extract HTML Content - Source Data : Laissez la valeur par défaut
From Previous Node Input. - Source Data Field :
data(le champ qui contient le HTML du nœud précédent). - Extraction Values :
- Key :
products(un nom de votre choix) - CSS Selector :
li.product - Return Value :
HTML - Return Array : Activez cette option.
- Key :
- Operation :
Exécutez ce nœud. La sortie doit être un item unique contenant un tableau (products) avec plusieurs extraits de code HTML, un pour chaque produit de la page.
Partie 3 : Extraire les Détails de Chaque Produit
Maintenant que nous avons isolé chaque produit, nous allons passer sur chacun de ces blocs HTML pour en extraire les informations qui nous intéressent.
- Ajoutez un second nœud HTML. Il s'exécutera pour chaque produit trouvé.
- Configurez-le ainsi :
-
Operation :
Extract HTML Content -
Source Data :
From Previous Node Input. -
Source Data Field :
products(le champ contenant le HTML de chaque produit individuel, que nous avons créé à l'étape précédente). -
Extraction Values : Cliquez sur Add Value pour créer une entrée pour chaque information.
-
Pour le nom :
- Key :
name - CSS Selector :
h2.woocommerce-loop-product__title - Return Value :
Text
- Key :
-
Pour le prix :
- Key :
price - CSS Selector :
span.price - Return Value :
Text
- Key :
-
Pour l'URL de la page :
- Key :
productUrl - CSS Selector :
a.woocommerce-LoopProduct-link - Return Value :
Attribute - Attribute :
href
- Key :
-
Pour l'URL de l'image :
- Key :
imageUrl - CSS Selector :
img.attachment-woocommerce_thumbnail - Return Value :
Attribute - Attribute :
src
- Key :
-
n8n Web Scraping: Complete Automation Guide
Cette vidéo montre la même logique : un premier nœud HTML pour isoler les conteneurs, puis un second pour extraire les détails de chaque conteneur. Observez bien la configuration du second nœud.
Regardez de 09:19 à 10:37. L'auteur utilise un second nœud HTML pour extraire le titre et le prix de chaque carte de produit, en utilisant le même principe de sélecteurs CSS que nous venons d'appliquer.
Exécutez ce nœud. Vous devriez maintenant avoir une liste de 16 items (le nombre de produits par page), chacun avec les champs name, price, productUrl et imageUrl.
Partie 4 : Nettoyer et Finaliser les Données
Vous remarquerez un petit problème : les URLs (productUrl et imageUrl) sont relatives (ex: /product/bulbasaur-funko-pop/). Elles ne sont pas utilisables telles quelles. Nous devons les transformer en URLs absolues en ajoutant le nom de domaine au début.
-
Ajoutez un nœud Set après le second nœud
HTML. -
Configurez-le pour reconstruire les URLs :
- Cliquez sur Add Field.
- Name :
productUrl(nous allons écraser la valeur existante). - Value : Cliquez sur l'icône d'éclair pour ouvrir l'éditeur d'expressions et entrez :
https://scrapeme.live{{ $json.productUrl }}. Cela concatène le domaine avec le chemin relatif.
- Name :
- Cliquez à nouveau sur Add Field.
- Name :
imageUrl - Value :
https://scrapeme.live{{ $json.imageUrl }}.
- Name :
- Cliquez sur Add Field.
-
Assurez-vous que l'option Keep Only Set est désactivée pour conserver les autres champs (
name,price).
Exécutez ce dernier nœud. La sortie est maintenant parfaite : une liste d'objets JSON propres et directement utilisables !

Solution Complète
Comme promis, voici le code JSON complet du workflow que vous pouvez importer dans n8n pour vérifier votre travail.
{
  "name": "Exercice Scraping E-commerce",
  "nodes": [
    {
      "parameters": {},
      "id": "1e78988a-360e-436f-b2e1-432a9a7a6bb5",
      "name": "Start",
      "type": "n8n-nodes-base.start",
      "typeVersion": 1,
      "position": [
        240,
        300
      ]
    },
    {
      "parameters": {
        "url": "https://scrapeme.live/shop/",
        "options": {
          "headers": {
            "header": [
              {
                "name": "User-Agent",
                "value": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/125.0.0.0 Safari/537.36"
              }
            ]
          }
        }
      },
      "id": "ddb0439c-2795-46aa-8367-e9a988d5761a",
      "name": "HTTP Request",
      "type": "n8n-nodes-base.httpRequest",
      "typeVersion": 4.1,
      "position": [
        460,
        300
      ]
    },
    {
      "parameters": {
        "sourceData": "html",
        "extractionValues": {
          "values": [
            {
              "key": "products",
              "cssSelector": "li.product",
              "returnValue": "html",
              "returnArray": true
            }
          ]
        }
      },
      "id": "921869e5-6b45-427f-9ad0-47b2c01990c8",
      "name": "HTML Extract Products",
      "type": "n8n-nodes-base.html",
      "typeVersion": 2,
      "position": [
        680,
        300
      ]
    },
    {
      "parameters": {
        "sourceData": "html",
        "sourceDataJson": "={{$json.products}}",
        "extractionValues": {
          "values": [
            {
              "key": "name",
              "cssSelector": "h2.woocommerce-loop-product__title",
              "returnValue": "text"
            },
            {
              "key": "price",
              "cssSelector": "span.price",
              "returnValue": "text"
            },
            {
              "key": "productUrl",
              "cssSelector": "a.woocommerce-LoopProduct-link",
              "returnValue": "attribute",
              "attribute": "href"
            },
            {
              "key": "imageUrl",
              "cssSelector": "img.attachment-woocommerce_thumbnail",
              "returnValue": "attribute",
              "attribute": "src"
            }
          ]
        }
      },
      "id": "100cdbc8-6019-482a-9e73-0aa839ec9b0b",
      "name": "HTML Extract Details",
      "type": "n8n-nodes-base.html",
      "typeVersion": 2,
      "position": [
        900,
        300
      ]
    },
    {
      "parameters": {
        "values": {
          "string": [
            {
              "name": "productUrl",
              "value": "=https://scrapeme.live{{$json.productUrl}}"
            },
            {
              "name": "imageUrl",
              "value": "=https://scrapeme.live{{$json.imageUrl}}"
            }
          ]
        },
        "options": {}
      },
      "id": "060d4750-f1ce-4d51-a9f4-18c946e382b9",
      "name": "Set Absolute URLs",
      "type": "n8n-nodes-base.set",
      "typeVersion": 3.4,
      "position": [
        1120,
        300
      ]
    }
  ],
  "connections": {
    "Start": {
      "main": [
        [
          {
            "node": "HTTP Request",
            "type": "main",
            "index": 0
          }
        ]
      ]
    },
    "HTTP Request": {
      "main": [
        [
          {
            "node": "HTML Extract Products",
            "type": "main",
            "index": 0
          }
        ]
      ]
    },
    "HTML Extract Products": {
      "main": [
        [
          {
            "node": "HTML Extract Details",
            "type": "main",
            "index": 0
          }
        ]
      ]
    },
    "HTML Extract Details": {
      "main": [
        [
          {
            "node": "Set Absolute URLs",
            "type": "main",
            "index": 0
          }
        ]
      ]
    }
  }
}
Conclusion et Prochaines Étapes
Félicitations ! Vous avez construit un workflow de scraping fonctionnel et robuste qui applique toutes les techniques vues dans ce module. Vous êtes maintenant capable d'extraire des données structurées de pages web statiques, une compétence extrêmement précieuse.
Points clés à retenir :
- Un workflow de scraping se décompose en étapes logiques : Requête -> Extraction des conteneurs -> Extraction des détails -> Nettoyage.
- L'utilisation de deux nœuds
HTML Extractest une méthode efficace pour d'abord isoler les éléments d'une liste, puis en extraire les détails. - La manipulation de données avec le nœud
Setest souvent nécessaire pour nettoyer les résultats (comme la conversion d'URLs relatives en absolues). - Les bonnes pratiques comme l'utilisation d'un
User-Agentpersonnalisé sont indispensables pour des projets réels.
Dans le prochain module, "Logique Avancée et Modularité", nous irons encore plus loin. Vous apprendrez à écrire votre propre logique avec le nœud Code pour des transformations complexes, et à créer des sous-workflows pour rendre vos automatisations modulaires et réutilisables. Cela vous ouvrira la porte à des projets d'une tout autre envergure.