Bonjour !
Dans la leçon précédente, nous avons fait un grand pas en avant en apprenant à utiliser un LLM pour classifier du texte et en extraire des données structurées au format JSON. Cette compétence est fondamentale pour transformer des informations non structurées en entrées fiables pour nos processus automatisés.
Aujourd'hui, nous allons nous attaquer à un autre défi majeur du traitement de texte : utiliser un LLM pour résumer des documents longs ou des fils d'emails. Cette capacité est cruciale pour des cas d'usage comme la veille informationnelle, la gestion de la communication client ou la création de synthèses pour la prise de décision.
Le principal obstacle technique est la limite de la "fenêtre de contexte" des LLMs, qui ne peuvent traiter qu'une quantité finie de texte en une seule fois. Cette leçon vous montrera précisément comment surmonter cet obstacle avec les outils spécialisés de n8n.
1. Le Défi des Documents Longs et le Nœud Summarization Chain
Lorsque le texte que vous souhaitez analyser (un long rapport, une page web, ou un fil d'emails) dépasse la fenêtre de contexte de votre modèle (par exemple, quelques milliers de mots), une simple requête au LLM échouera. La solution consiste à découper le texte en morceaux ("chunks"), à les traiter, puis à combiner les résultats.
n8n propose un nœud spécifiquement conçu pour cette tâche : le Summarization Chain.

Pour comprendre en détail le fonctionnement de ce nœud puissant, la vidéo suivante est une excellente ressource. Bien qu'elle soit en anglais, les démonstrations visuelles des réglages sont très claires. Je vais résumer les concepts clés en français juste après.
Every AI Node in n8n EXPLAINED | ONLY Guide You Need (Agents, RAG, Parsers & More)
Cette vidéo de la chaîne FuturMinds explique en détail le fonctionnement du nœud Summarization Chain.
Regardez la section de 15:59 à 19:49. Concentrez-vous sur les trois concepts fondamentaux qu'elle présente : Chunking Strategy (Stratégie de découpage) : Comment le texte est découpé en morceaux. Summarization Method (Méthode de résumé) : Comment les morceaux sont traités pour créer le résumé final. Data Input (Source des données) : Comment fournir le texte au nœud.
Les Concepts Clés du Summarization Chain
Comme vous l'avez vu, la configuration de ce nœud repose sur deux choix essentiels :
A. La Stratégie de Découpage (Chunking Strategy)
- Simple : Découpe le texte en fonction d'un nombre fixe de caractères. C'est rapide mais imprécis, car cela peut couper des mots ou des phrases en plein milieu.
- Advanced : Permet d'utiliser des méthodes plus intelligentes. La plus recommandée est le
Recursive Character Text Splitter. Il essaie de préserver la structure sémantique en découpant d'abord par paragraphe, puis par phrase, et enfin par mot, jusqu'à ce que chaque morceau respecte la taille définie. C'est la méthode à privilégier dans la plupart des cas.
B. La Méthode de Résumé (Summarization Method)
C'est ici que vous définissez comment le LLM va traiter les morceaux découpés.
- Stuff : La méthode la plus simple. Elle tente de "fourrer" (to stuff) tous les morceaux dans un seul et même prompt. Elle ne fonctionne que si la totalité du texte, une fois découpé, tient dans la fenêtre de contexte du modèle. Utile pour des textes courts à moyens.
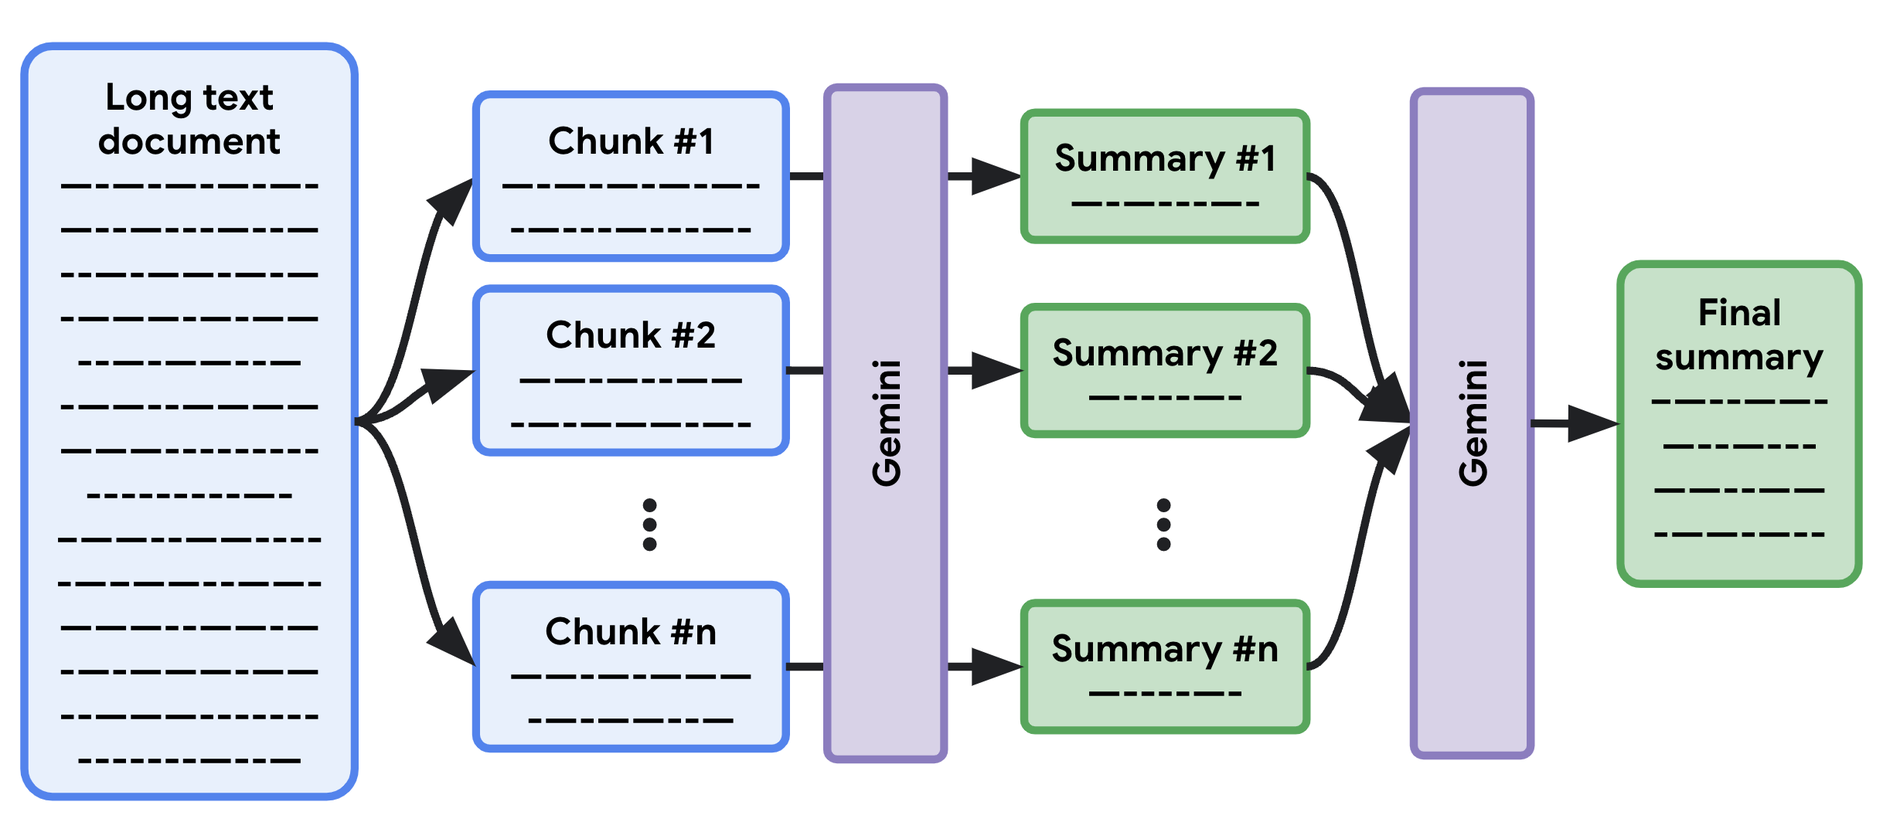
- Map-Reduce : La solution la plus robuste pour les documents longs.
- Phase "Map" : Le LLM génère un résumé indépendant pour chaque morceau de texte.
- Phase "Reduce" : Le LLM prend ensuite tous ces résumés intermédiaires et les utilise pour générer un résumé final global.
- Refine : Une approche itérative. Le LLM résume le premier morceau. Ensuite, il prend ce premier résumé et le second morceau, et "affine" le résumé pour inclure les informations du second morceau. Il répète ce processus jusqu'au dernier morceau. C'est utile si vous souhaitez construire un résumé qui évolue et gagne en détail au fil du document.
2. Application Pratique : Résumer un Fil d'Emails
Maintenant, appliquons ces concepts à un cas concret : résumer un fil d'emails. La logique est légèrement différente de celle d'un document unique. Nous devons d'abord récupérer tous les messages d'une même conversation (thread) et les assembler avant de les passer à notre outil de résumé.
L'article du Journal du Net ci-dessous montre une approche simple pour récupérer plusieurs emails et les combiner.
n8n, des fonctionnalités et un peu de complexité
Cet article du Journal du Net présente la construction d'un workflow qui résume les derniers emails reçus.
Lisez la section "n8n, des fonctionnalités et un peu de complexité". Observez comment ils utilisent le nœud "Get many messages" pour récupérer les emails, puis un nœud "Code in Javascript" pour agréger les différents messages en un seul texte avant de l'envoyer au LLM. C'est une excellente technique pour préparer les données.
La vidéo suivante, en français, va plus loin et montre comment gérer des conversations par email de manière contextuelle, ce qui est directement applicable à notre besoin de résumé de fil de discussion.
Automatise ta boite mail de ZÉRO avec N8N (Guide Débutant)
Cette vidéo de Julien Sanson sur l'automatisation de boîte mail est une mine d'or pour notre cas d'usage. Elle aborde la récupération d'emails, l'utilisation de l'IA et surtout, la gestion des conversations.
Regardez ces deux segments clés : Configuration du déclencheur (00:32 - 03:53) : Voyez comment configurer le nœud Gmail pour récupérer les emails. Portez une attention particulière au champ threadId qui est la clé pour regrouper les messages d'une même conversation. Utilisation de la mémoire (27:41 - 29:18) : L'auteur connecte une mémoire à l'agent IA en utilisant le threadId comme identifiant de session (session ID). C'est exactement le principe dont nous avons besoin pour que notre résumé porte sur l'ensemble de la conversation et non sur un seul email isolé.
Exercice : Construire un Summarizer de Fil d'Emails
Créons un workflow qui, à partir d'un threadId fourni, récupère tous les emails de la conversation, les combine, et en génère un résumé en utilisant la méthode Map-Reduce.
Votre Workflow :
-
Déclencheur
Manual: Pour démarrer le workflow manuellement. -
Nœud
Set: Pour simuler la réception d'unthreadId.- Créez un champ nommé
threadId. - Collez-y un
threadIdréel provenant de votre boîte Gmail. Pour en trouver un, ouvrez un email dans Gmail, cliquez sur les trois points "Plus" et choisissez "Afficher l'original". LeMessage-IDcontient une chaîne de caractères, mais lethreadIdest plus facilement accessible via l'API de n8n. Une façon simple de l'obtenir est de créer un workflow temporaire avec unGmail Trigger, de récupérer un email, et de copier la valeur du champthreadIddepuis le panneau de sortie.
- Créez un champ nommé
-
Nœud
Gmail: Pour récupérer tous les messages du thread.- Authentication : Sélectionnez vos identifiants.
- Resource :
Message. - Operation :
Get Many. - Dépliez les Options et cliquez sur Add Option > Query.
- Dans le champ
Query, utilisez une expression pour filtrer sur lethreadId:thread:{{ $json.threadId }}.
-
Nœud
Code: Pour agréger le contenu de tous les emails en un seul bloc de texte.- Mode : Laissez
Run Once for All Items. - Dans le champ JavaScript Code, insérez le code suivant. Il va parcourir tous les emails récupérés et concaténer leur contenu (champ
textAsHtmloutext, selon ce que vous préférez).
// Agréger le contenu de tous les emails en un seul texte.
const allEmails = items.map(item => {
  const from = item.json.from.map(f => f.email).join(', ');
  const date = new Date(item.json.internalDate).toLocaleString('fr-FR');
  // On utilise textAsHtml, qui est souvent plus riche que 'text'.
  // On le nettoie basiquement des balises HTML.
  const content = item.json.textAsHtml ? item.json.textAsHtml.replace(/<[^>]*>/g, '\n') : item.json.text;
  return `--- Email de ${from} le ${date} ---\n\n${content}\n\n`;
}).join('');

return [{ json: { full_thread_content: allEmails } }];
Ce code crée un champ unique
full_thread_contentcontenant toute la conversation. - Mode : Laissez
-
Nœud
Summarization Chain: Le cœur de notre workflow.- Connectez l'entrée du
Summarization Chainà la sortie du nœudCode. - Data to Summarize:
JSON. - Source of Text: Utilisez une expression pour cibler notre texte agrégé :
{{ $json.full_thread_content }}. - Chunking Strategy:
Advanced. Dans les options qui apparaissent, laissezRecursive Character Text Splitter. Vous pouvez ajusterChunk Sizesi besoin. - Summarization Method:
Map-Reduce. - Model: Connectez un nœud
OpenAI Chat Model(ou un autre modèle de votre choix) configuré avec vos identifiants.
- Connectez l'entrée du
-
Exécution et Vérification : Exécutez le workflow. Inspectez la sortie du nœud
Summarization Chain. Vous devriez y trouver un champresultcontenant un résumé concis de toute la conversation.
Solution (Workflow JSON)
Comme convenu, voici le code JSON du workflow complet. Vous pouvez le copier et le coller directement dans votre éditeur n8n (Ctrl/Cmd + V) pour l'importer. N'oubliez pas de configurer vos identifiants Gmail et OpenAI.
{
  "name": "Email Thread Summarizer",
  "nodes": [
    {
      "parameters": {},
      "id": "2b311749-6238-4e1a-8f43-080c360c7d42",
      "name": "Start",
      "type": "n8n-nodes-base.start",
      "typeVersion": 1,
      "position": [
        460,
        300
      ]
    },
    {
      "parameters": {
        "values": {
          "string": [
            {
              "name": "threadId",
              "value": "VOTRE_THREAD_ID_ICI"
            }
          ]
        },
        "options": {}
      },
      "id": "e98e29d7-8321-4f10-9b36-eb2a5ec65f49",
      "name": "Set Thread ID",
      "type": "n8n-nodes-base.set",
      "typeVersion": 1,
      "position": [
        680,
        300
      ]
    },
    {
      "parameters": {
        "resource": "message",
        "operation": "getAll",
        "options": {
          "query": "thread:{{ $json.threadId }}"
        }
      },
      "id": "0df81e2e-2e57-4b72-a1b7-7813a772c72b",
      "name": "Get Thread Messages",
      "type": "n8n-nodes-base.gmail",
      "typeVersion": 1,
      "position": [
        900,
        300
      ],
      "credentials": {
        "gmailOAuth2": {
          "id": "VOS_IDENTIFIANTS_GMAIL",
          "name": "Gmail account"
        }
      }
    },
    {
      "parameters": {
        "jsCode": "const allEmails = items.map(item => {\n  const from = item.json.from.map(f => f.email).join(', ');\n  const date = new Date(item.json.internalDate).toLocaleString('fr-FR');\n  const content = item.json.textAsHtml ? item.json.textAsHtml.replace(/<[^>]*>/g, '\\n') : item.json.text;\n  return `--- Email de ${from} le ${date} ---\\n\\n${content}\\n\\n`;\n}).join('');\n\nreturn [{ json: { full_thread_content: allEmails } }];"
      },
      "id": "4b9a8960-93ff-4e6f-be3d-4c3a64706509",
      "name": "Aggregate Content",
      "type": "n8n-nodes-base.code",
      "typeVersion": 1,
      "position": [
        1120,
        300
      ]
    },
    {
      "parameters": {
        "source": "json",
        "text": "={{ $json.full_thread_content }}",
        "chunkingStrategy": "advanced",
        "method": "mapReduce"
      },
      "id": "67406a1f-ec25-4b35-8663-c79b940e4f24",
      "name": "Summarization Chain",
      "type": "n8n-nodes-base.summarizationChain",
      "typeVersion": 1,
      "position": [
        1340,
        300
      ]
    },
    {
      "parameters": {},
      "id": "6d9dd6f9-052b-426c-85fa-805128ffccb9",
      "name": "OpenAI Chat Model",
      "type": "n8n-nodes-base.openAiChatModel",
      "typeVersion": 1,
      "position": [
        1340,
        500
      ],
      "credentials": {
        "openAiApi": {
          "id": "VOS_IDENTIFIANTS_OPENAI",
          "name": "OpenAI account"
        }
      }
    }
  ],
  "connections": {
    "Start": {
      "main": [
        [
          {
            "node": "Set Thread ID",
            "type": "main",
            "index": 0
          }
        ]
      ]
    },
    "Set Thread ID": {
      "main": [
        [
          {
            "node": "Get Thread Messages",
            "type": "main",
            "index": 0
          }
        ]
      ]
    },
    "Get Thread Messages": {
      "main": [
        [
          {
            "node": "Aggregate Content",
            "type": "main",
            "index": 0
          }
        ]
      ]
    },
    "Aggregate Content": {
      "main": [
        [
          {
            "node": "Summarization Chain",
            "type": "main",
            "index": 0
          }
        ]
      ]
    },
    "Summarization Chain": {
      "main": [
        []
      ],
      "model": [
        [
          {
            "node": "OpenAI Chat Model",
            "type": "main",
            "index": 0
          }
        ]
      ]
    }
  }
}
Conclusion
Félicitations ! Vous maîtrisez désormais une technique essentielle pour l'automatisation intelligente. Vous savez comment surmonter la limitation de la fenêtre de contexte pour analyser et synthétiser des contenus longs.
Points clés à retenir :
- Le nœud
Summarization Chainest l'outil spécialisé pour résumer de longs textes dans n8n. - La stratégie de découpage
RecursiveCharacterTextSplitterest la plus fiable pour préserver le sens du texte. - La méthode de résumé
Map-Reduceest la solution standard pour les documents qui dépassent la fenêtre de contexte. - Pour traiter des fils d'emails, l'étape de préparation des données (récupérer les messages par
threadIdet les agréger) est aussi importante que le résumé lui-même.
Dans la prochaine leçon, nous allons explorer le chaînage de prompts. Vous apprendrez à construire des workflows où la sortie d'un premier appel LLM devient l'entrée d'un second, permettant de créer des logiques d'IA encore plus complexes et sophistiquées.