Olá! Vamos para a nossa próxima lição.
Na aula anterior, exploramos como testar e validar a capacidade do nosso agente Rovo de recuperar informações das fontes de conhecimento que configuramos, como o Google Drive e repositórios Git. Vimos que a recuperação eficaz é a base para qualquer ação inteligente que o agente venha a tomar. Se o agente não consegue encontrar a informação certa, ele não pode gerar o código certo.
Agora, vamos aprofundar um passo crucial nesse processo. O objetivo desta lição é refinar as estratégias de chunking e indexação com base na estrutura específica de documentos de negócio e arquivos de código. "Chunking" é o processo de dividir grandes volumes de informação em pedaços menores e mais gerenciáveis para que o sistema de RAG possa entendê-los e recuperá-los. A forma como fazemos isso tem um impacto direto e profundo na qualidade da recuperação. Para o seu objetivo, isso significa a diferença entre o agente entender uma regra de negócio inteira ou apenas um fragmento dela.
1. O Que é Chunking e Por Que é Fundamental?
Antes de indexar qualquer conteúdo para busca, ele precisa ser dividido. Imagine tentar encontrar uma frase específica em um livro que não tem capítulos, parágrafos ou sequer frases—apenas um bloco de texto contínuo. Seria extremamente ineficiente. O chunking serve para criar essas divisões lógicas no nosso conteúdo digital.
Uma estratégia de chunking ruim pode quebrar o contexto, separar ideias relacionadas e, no final, fornecer ao LLM informações fragmentadas ou incompletas, levando a respostas erradas.
Para uma introdução visual ao conceito, vamos assistir a um trecho de um vídeo que explica o que é chunking e por que uma boa estratégia é tão importante.
Chunking Strategies in RAG: Optimising Data for Advanced AI Responses
O vídeo 'Chunking Strategies in RAG' explica a importância do chunking e os problemas que surgem de abordagens ingênuas.
Assista ao início do vídeo (00:00:00 - 00:01:45). Preste atenção na demonstração de como uma divisão por tamanho fixo de caracteres pode quebrar palavras e o sentido do texto, resultando em "chunks" de baixa qualidade.
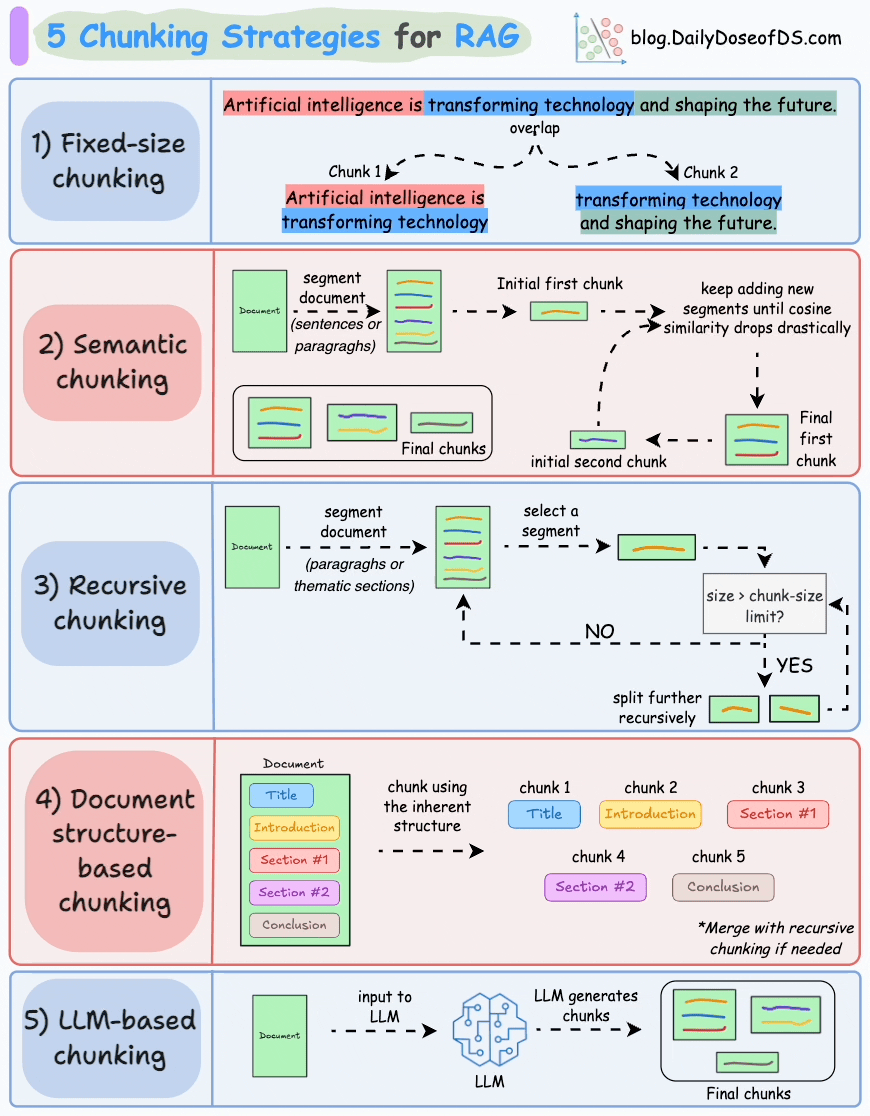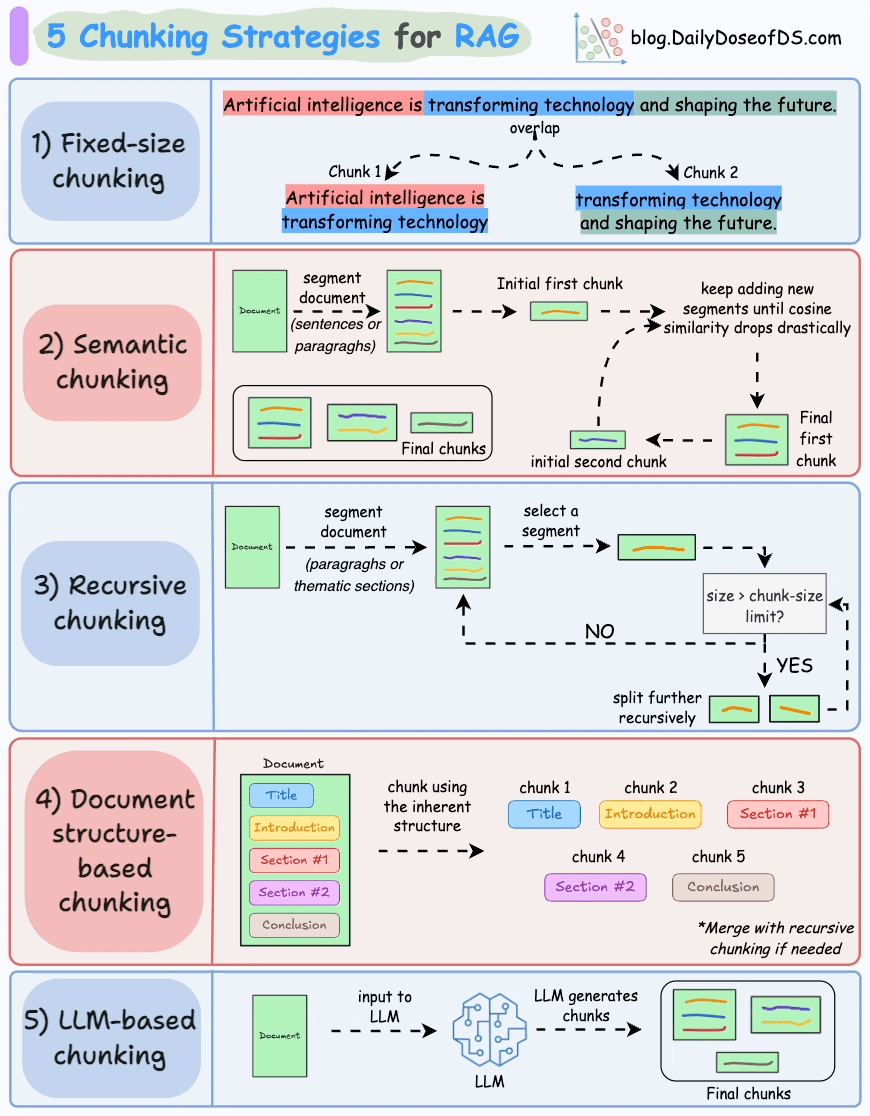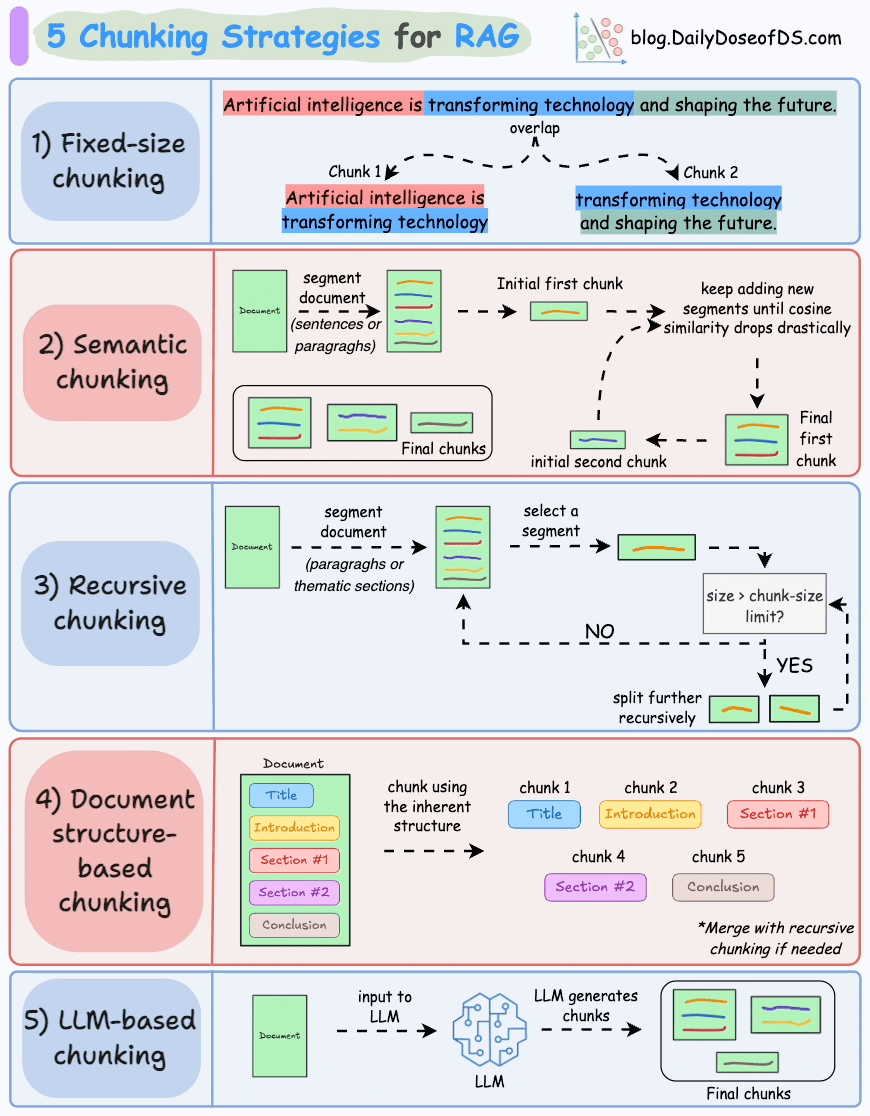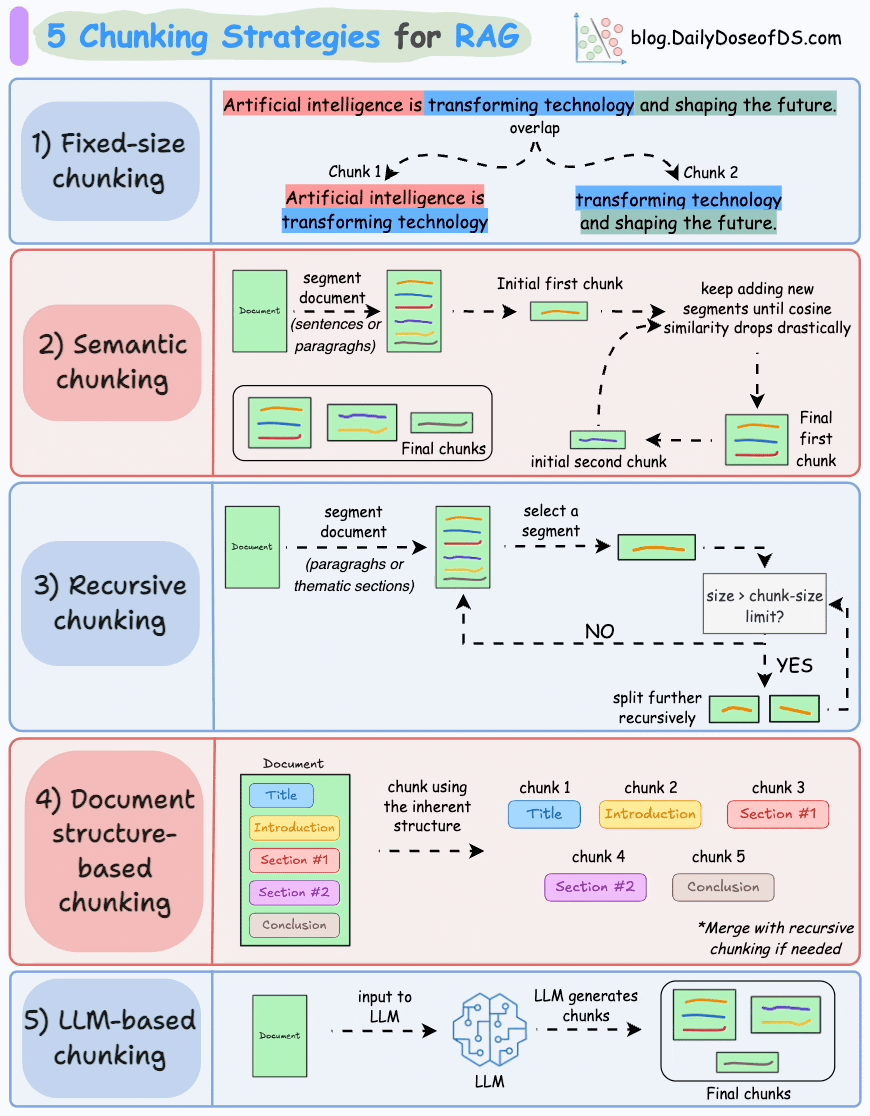
Existem várias maneiras de abordar o chunking, cada uma com seus prós e contras. A imagem abaixo oferece um excelente resumo visual de algumas das principais estratégias.
2. Estratégias para Documentos de Negócio (Google Drive)
Seus documentos de regras de negócio no Google Drive provavelmente consistem em texto não-estruturado ou semi-estruturado (com títulos, seções e listas). Para este tipo de conteúdo, precisamos de estratégias que preservem o significado e o contexto.
Abordagens Comuns:
-
Chunking Recursivo de Caracteres: Esta é uma melhoria inteligente em relação ao chunking de tamanho fixo. Ele tenta dividir o texto usando uma hierarquia de separadores. Primeiro, tenta dividir por parágrafos (
\n\n), depois por frases (.), depois por espaços ( -
Chunking Semântico: Esta abordagem mais avançada vai além da estrutura do texto e foca no significado. Ela converte sentenças ou parágrafos em embeddings (vetores numéricos) e agrupa aqueles que são semanticamente semelhantes. O objetivo é criar chunks que contenham um conceito completo, mesmo que ele se estenda por várias frases.
-
Chunking Agêntico (LLM-based): Aqui, usamos um LLM para realizar o chunking. Uma técnica é a chunking baseada em proposições, onde o LLM reescreve o texto em uma série de "proposições" atômicas, onde cada uma é uma afirmação que pode ser entendida de forma independente. Isso é extremamente poderoso para regras de negócio, pois garante que cada regra recuperada seja uma unidade completa de informação.
O vídeo a seguir demonstra essas estratégias, desde a recursiva até a agêntica.
Chunking Strategies in RAG: Optimising Data for Advanced AI Responses
Vamos voltar ao vídeo 'Chunking Strategies in RAG' para ver a implementação prática de estratégias mais avançadas para documentos de texto.
Assista às seguintes seções: Recursive Character Text Splitting (00:05:36 - 00:06:52): Veja como essa técnica usa separadores como quebras de linha para criar chunks mais lógicos. Semantic Chunking (00:08:19 - 00:09:40): Entenda como os embeddings são usados para agrupar ou dividir o texto com base no significado. Agentic Chunking (00:09:40 - 00:13:44): Explore as técnicas de ponta, como a criação de proposições e o agrupamento de chunks por categoria usando um LLM. Isso é particularmente relevante para destilar regras de negócio complexas.
Como o Rovo Lida com Isso?
Felizmente, você não precisa implementar esses algoritmos do zero no Rovo. A plataforma já possui um pipeline sofisticado para processar documentos. No entanto, entender esses princípios ajuda você a estruturar seus documentos de uma forma que o Rovo possa interpretar melhor.
Unraveling Rovo search relevance
O artigo 'Unraveling Rovo search relevance' da Atlassian nos dá uma visão de como a plataforma lida com o chunking internamente.
Releia a seção 'Smart Answer workflow' do artigo. Foque na parte que descreve o pipeline de transformação: "...we chunk all documents into manageable passage snippets. After chunking, passages are ranked using cross-encoder models... we also add page-level metadata such as the URL and the document title into each passage.".
A principal lição aqui é que o Rovo não apenas divide os documentos, mas também os enriquece com metadados (como título e URL), o que é crucial para a citação de fontes. Ao escrever seus documentos de regras de negócio, usar uma estrutura clara com títulos e seções ajudará o pipeline do Rovo a criar chunks mais significativos.

3. Estratégias para Arquivos de Código (Repositórios Git)
Esta é a parte mais crítica para o seu objetivo. Código-fonte é texto altamente estruturado. Aplicar as mesmas estratégias de chunking de texto natural a um arquivo de código é uma receita para o desastre, pois ignora completamente a sintaxe e a lógica da programação.
Imagine que uma função C# seja dividida no meio. O chunk resultante seria sintaticamente inválido e inútil para o LLM.
Enhancing LLM Code Generation with RAG and AST-Based Chunking
Este artigo, 'Enhancing LLM Code Generation with RAG and AST-Based Chunking', explica perfeitamente por que o chunking tradicional falha para o código e apresenta a solução correta.
Leia as seções 'The Problem with Traditional Chunking for Code' e 'AST-Based Chunking: A Better Approach'. O exemplo em C++ ilustra claramente como o chunking por caracteres produz fragmentos de código malformados. Em seguida, entenda o conceito de uma Árvore de Sintaxe Abstrata (AST) como a solução.
A solução, como o artigo aponta, é o chunking baseado em AST (Abstract Syntax Tree). Como desenvolvedor, você sabe que o compilador não lê seu código como um bloco de texto, mas o analisa em uma estrutura de árvore que representa sua sintaxe: classes, métodos, laços for, instruções if, etc.
Podemos usar essa mesma abordagem. Ferramentas como o Tree-sitter são parsers que podem gerar uma AST para dezenas de linguagens de programação (incluindo C#, JavaScript e Dart). Podemos então percorrer essa árvore e definir nossos chunks com base em nós sintaticamente significativos, como:
- Uma classe inteira.
- Um método ou função.
- Um componente React.
- Um bloco de importações.
Isso garante que cada chunk seja uma unidade de código sintaticamente completa e logicamente coerente, fornecendo um contexto de altíssima qualidade para o LLM.
O vídeo a seguir mostra uma implementação prática desse conceito.
Build codebase indexing for RAG and semantic search with live update
O vídeo 'Build codebase indexing for RAG and semantic search' demonstra como usar o Tree-sitter para indexar um codebase de forma inteligente.
Assista aos seguintes trechos para ver o processo em ação: Introdução ao Tree-sitter (00:00:11 - 00:00:55): Entenda como ele analisa o código com base na estrutura da sintaxe. Linguagens Suportadas (00:01:09 - 00:01:59): Note que C++, JavaScript, Python e muitas outras linguagens relevantes para você são suportadas. Fluxo de Indexação (00:02:23 - 00:03:06): Veja o passo a passo: ler arquivo -> extrair extensão -> dividir o código em chunks semânticos usando o Tree-sitter. Implementação (00:04:51 - 00:05:58): Observe como a extensão do arquivo é passada como parâmetro para a função de chunking, permitindo que o Tree-sitter aplique o parser correto para cada linguagem.
Novamente, o Rovo e suas integrações (como o Bitbucket) provavelmente usam estratégias semelhantes nos bastidores. O ponto chave para você é entender que, ao consultar o código, o agente terá acesso a chunks estruturados de forma inteligente. Ao escrever diretrizes de arquitetura no seu arquivo AGENTS.md, você pode fazer referência a nomes de funções ou classes, confiante de que o sistema de RAG será capaz de localizar esses blocos de código completos.
4. Estratégias de Indexação: Enriquecendo o Contexto
O chunking é apenas metade da história. A outra metade é a indexação. Indexar não é apenas armazenar os chunks e seus embeddings. Uma estratégia de indexação robusta também armazena metadados valiosos junto com cada chunk.
Unraveling Rovo search relevance
Vamos revisitar o artigo 'Unraveling Rovo search relevance' para ver quais outros sinais o Rovo armazena em seu índice para melhorar a relevância.
Leia a seção 'Index' dentro do tópico 'Relevance'. Preste atenção aos tipos de sinais que eles enriquecem o índice: "popularity and authority signals such as number of contributors, engagement signals, type of container/folder (personal or public)".
Isso nos mostra que o contexto vai além do texto. Para o Rovo, um documento editado por muitas pessoas e localizado em uma pasta pública do Google Drive é provavelmente mais "autoritário" do que um rascunho pessoal.
Aplicação para seu projeto:
Embora muitos desses sinais sejam capturados automaticamente pelo Rovo, você pode otimizar seu conteúdo pensando nisso:
- Documentos de Negócio: Coloque as regras de negócio oficiais e finalizadas em uma pasta compartilhada e bem definida no Google Drive. Isso aumenta seu "sinal de autoridade".
- Arquivos de Código: Mantenha as diretrizes de arquitetura em arquivos bem documentados e conhecidos pela equipe, como o
AGENTS.mdna raiz de cada repositório. O Rovo é projetado para dar atenção especial a esses arquivos. - Metadados Estruturados: Ao escrever documentação, considere usar metadados explícitos, como tabelas ou front matter (em arquivos Markdown), para definir propriedades como
autor,data_revisao,dominio_tecnico, etc. Isso pode facilitar a criação de estratégias de recuperação mais avançadas no futuro.
Conclusão
Nesta lição, mergulhamos fundo nas estratégias que transformam conteúdo bruto em uma base de conhecimento inteligente e pesquisável. Vimos que não basta apenas conectar as fontes de dados; a forma como preparamos e estruturamos essas informações é fundamental para o sucesso do RAG.
Principais Pontos:
- Chunking é crítico: Estratégias ingênuas quebram o contexto. A escolha da estratégia deve corresponder ao tipo de conteúdo.
- Para Documentos de Texto: Estratégias como chunking recursivo, semântico ou baseado em LLM preservam o significado das regras de negócio.
- Para Código: O chunking baseado em AST (Árvore de Sintaxe Abstrata) é essencial. Ele respeita a estrutura sintática do código, garantindo que os chunks sejam unidades lógicas completas (funções, classes).
- Indexação é mais que Embeddings: Enriquecer o índice com metadados (como autoridade, popularidade, data, fonte) melhora drasticamente a relevância da recuperação.
Com uma base de conhecimento bem-processada e indexada, nosso agente está agora muito mais preparado para receber uma tarefa, encontrar o contexto exato de que precisa e, finalmente, agir sobre ele.
Na Próxima Lição:
Até agora, focamos em como o agente pensa e aprende (RAG e base de conhecimento). No próximo módulo, "Definindo Ações do Agente: Integrações de API", começaremos a ensinar nosso agente a fazer. Nossa primeira lição se concentrará em Definir uma 'ferramenta' ou 'ação' dentro do framework do agente Rovo, começando com a integração com a API do GitHub para realizar tarefas como criar branches e commitar arquivos.