Olá! Vamos para a nossa próxima lição.
Nas lições anteriores, você estabeleceu as bases do conhecimento do seu agente, configurando conectores para buscar regras de negócio do Google Drive e diretrizes de arquitetura de repositórios Git usando arquivos AGENTS.md. Agora que as pontes para essas fontes de dados foram construídas, nossa prioridade muda para a segurança e o controle.
O objetivo desta lição é definir escopos de acesso e permissões apropriados para todas as fontes de conhecimento configuradas. Um agente autônomo com acesso a código-fonte, documentos de negócio e APIs de sistema é poderoso, mas também apresenta riscos. Garantir que ele opere dentro de limites bem definidos não é apenas uma boa prática; é um requisito fundamental para a implantação segura em um ambiente corporativo.
Vamos explorar o modelo de permissões em camadas da Atlassian, desde quem pode usar o agente até quais informações ele pode ver e quais ações pode executar.
1. O Princípio Fundamental: O Agente Age em Nome do Usuário
Antes de mergulharmos nas configurações específicas, é crucial entender o princípio central de segurança do Rovo: um agente sempre herda as permissões do usuário que o invoca.
Isso significa que o Rovo não tem um conjunto de superpoderes próprio. Se um usuário não tem permissão para ver uma página específica no Confluence ou um repositório privado no GitHub, o agente, ao ser executado por esse usuário, também não terá.
Para aprofundar este conceito, vamos começar com um documento da Atlassian que o explica de forma clara.
Rovo agent permissions and governance
A documentação de suporte da Atlassian fornece a explicação mais direta sobre como as permissões de acesso a dados funcionam. Vamos ler a seção principal sobre isso.
Navegue até a seção intitulada 'What can users access when interacting with an agent?'. Esta seção resume de forma concisa o modelo de permissões herdadas, que é a base para tudo o que faremos nesta lição.
Essa filosofia de "agir em nome de" é uma pedra angular da segurança na plataforma. Ela garante que, por padrão, o agente não possa se tornar um vetor para escalonamento de privilégios. As permissões que você já gerencia para suas equipes no Jira, Confluence e GitHub são respeitadas nativamente.
A visão do produto da Atlassian reforça essa ideia de segurança integrada, como você pode ver neste trecho do keynote de lançamento.
Team '24 Founders' Keynote: The next era of Jira, Atlassian System of Work, Atlassian Rovo Launch
Para ver como este princípio é comunicado na visão geral do produto, assista a este breve clipe.
Assista ao trecho de 01:21:06 a 01:21:30. O apresentador enfatiza que toda a busca do Rovo e o 'teamwork graph' respeitam as permissões de nível empresarial do conteúdo de origem.
2. Permissions for External Knowledge Sources
O princípio da herança de permissões se aplica, mas para fontes externas como Google Drive e GitHub, há uma camada adicional de controle: os escopos de autorização concedidos no momento da conexão.
Google Drive via OAuth Scopes
Quando você configurou o conector do Google Drive, sua organização autorizou o aplicativo da Atlassian a agir em seu nome dentro de certos limites, definidos por escopos OAuth. Esses escopos determinam o que o aplicativo pode fazer (por exemplo, apenas ler arquivos, ler e escrever, listar arquivos, etc.).
A imagem a seguir, do Google Cloud Console, ilustra como esses escopos são selecionados durante o registro de um aplicativo.
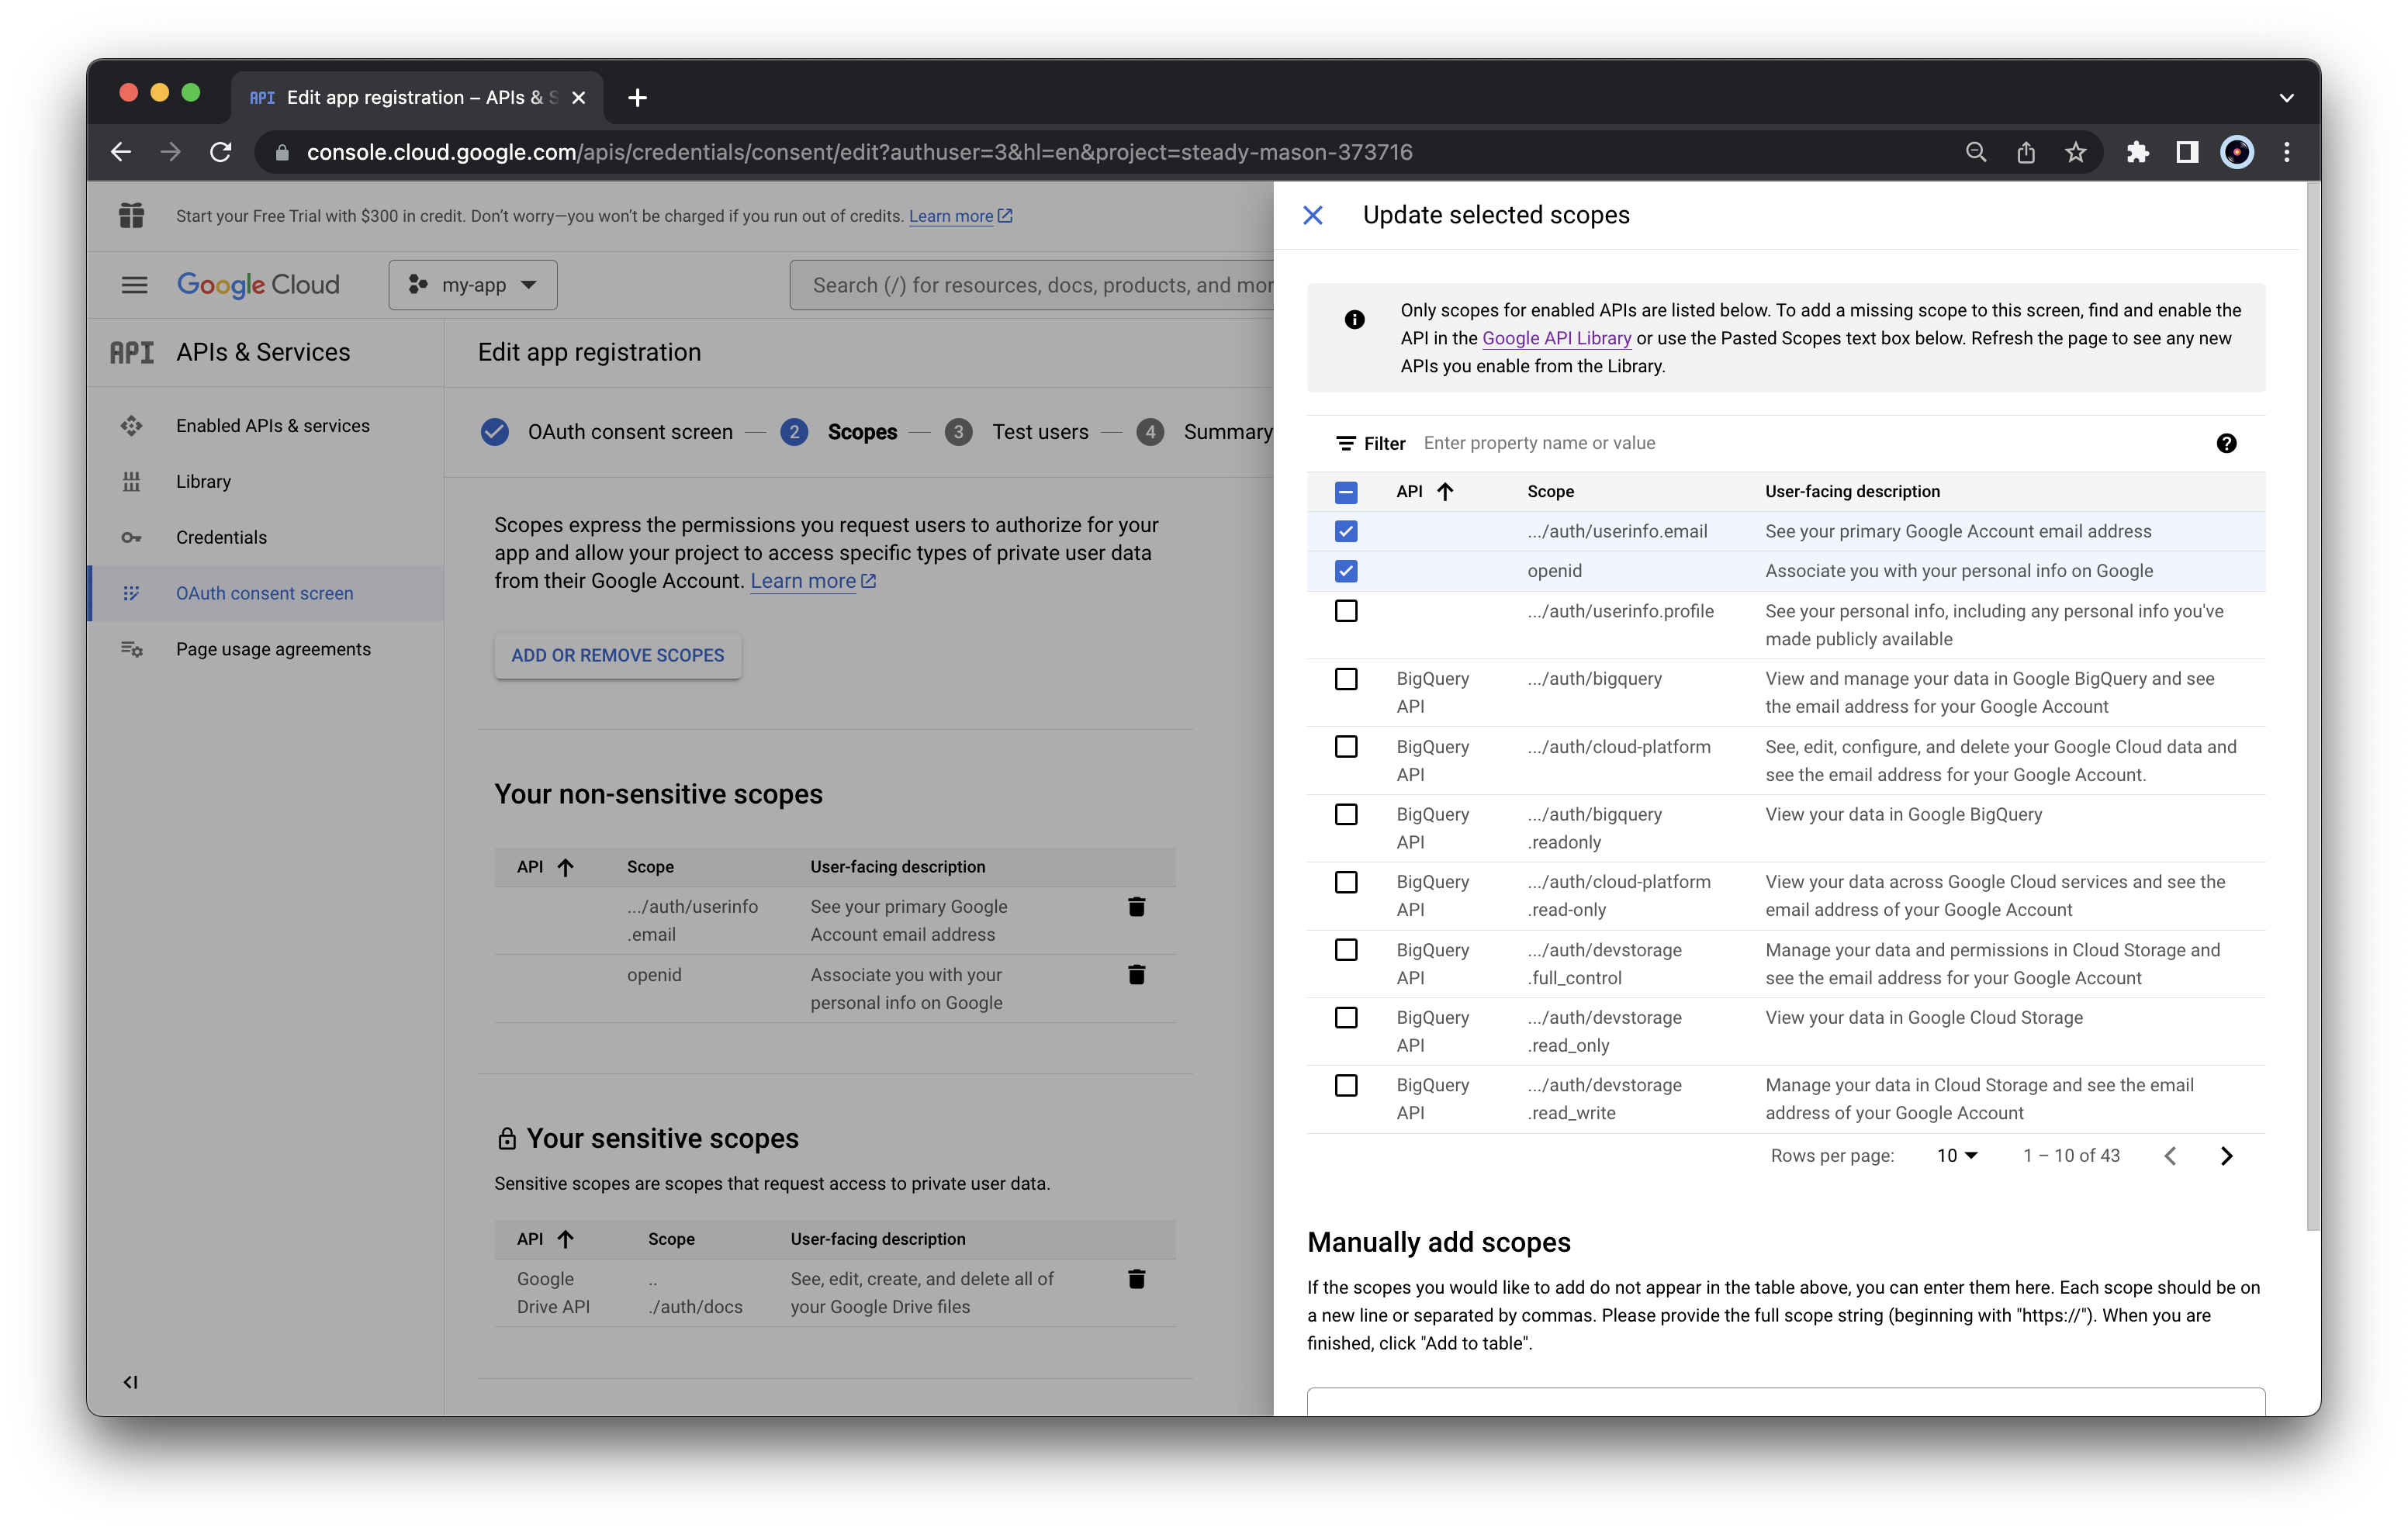
Para o seu agente, isso significa que o acesso aos documentos de regras de negócio no Google Drive é duplamente limitado:
- Pelo escopo concedido ao conector Rovo (ex:
readonly). - Pelas permissões de compartilhamento do usuário que executa o agente no próprio Google Drive.
GitHub via App Permissions e IP Allowlists
Da mesma forma, o acesso aos repositórios do GitHub é governado pelas permissões concedidas ao "GitHub for Jira app" durante a instalação. Mais importante, para ambientes corporativos com segurança de rede rigorosa, podem existir controles adicionais, como listas de permissões de IP.

Isso demonstra que a permissão não é apenas sobre identidade de usuário, mas também sobre a postura de segurança da rede, algo que sua experiência em redes e infraestrutura certamente destaca.
3. Governando a Criação e o Uso de Agentes
Agora, vamos subir um nível e olhar para a governança do próprio agente: quem pode criar, gerenciar e interagir com eles? Um controle inadequado aqui pode levar a uma proliferação de agentes redundantes ou mal configurados.
A documentação da Atlassian que lemos anteriormente detalha esses três níveis de governança.
Rovo agent permissions and governance
Vamos revisitar o documento 'Rovo agent permissions and governance' para entender os controles administrativos sobre os próprios agentes.
Leia as três primeiras seções: 'Manage who can create agents in Studio', 'Set edit permissions for your agent' e 'Control who can see and use your agent'. Preste atenção em como você pode restringir a criação por grupos, atribuir papéis de 'Editor' e 'Manager' e limitar a visibilidade de um agente.
Resumindo os pontos chave para o seu projeto:
- Criação de Agentes: Como administrador da organização, você pode decidir se todos os usuários, apenas grupos selecionados (ex: a equipe de desenvolvimento principal) ou apenas outros administradores podem criar novos agentes.
- Gerenciamento do Agente: Para o agente complexo que você está construindo, você pode adicionar outros membros da sua equipe como "Managers" (que podem editar e excluir o agente) ou "Editors" (que podem apenas editar as instruções e configurações).
- Acesso ao Agente: Inicialmente, você pode querer que o seu agente seja privado, visível apenas para você durante o desenvolvimento. Depois, você pode abrir o acesso para indivíduos específicos ou para toda a organização.
4. Limitando o Escopo do Conhecimento do Agente
Além de controlar o acesso, é vital controlar o escopo. Dar a um agente acesso a "todo o conhecimento" da empresa pode torná-lo lento, caro e propenso a usar informações irrelevantes. Para o seu agente de código, você quer que ele se concentre em fontes de conhecimento muito específicas.
É aqui que a configuração de "Knowledge" do agente entra em jogo.
How to create effective Rovo Agents | Team '25
O vídeo a seguir mostra a interface para configurar o 'cérebro' do agente, ou seja, suas fontes de conhecimento. Isso permite focar o agente nas informações mais relevantes.
Assista ao trecho de 00:19:39 a 00:21:27. O vídeo demonstra como, na interface de criação do agente, você pode alternar de 'All knowledge' para conhecimento específico, selecionando espaços do Confluence, projetos do Jira ou conectores de terceiros (como seu Google Drive).
Para seu caso de uso, você provavelmente criará um agente e o configurará para usar um escopo de conhecimento altamente restrito, incluindo apenas:
- O conector do Google Drive que aponta para a pasta de regras de negócio.
- Os conectores do GitHub para os repositórios de backend, frontend e mobile.
- Potencialmente, um espaço específico do Confluence onde a documentação de arquitetura de alto nível é mantida.
Isso garante que, quando o agente for analisar um ticket do Jira, ele não buscará informações em espaços do Confluence de RH ou marketing, otimizando a relevância e a precisão de suas respostas.
5. Controle Granular de Ações com o Rovo Dev CLI
Até agora, focamos principalmente no que o agente pode ver. Para um desenvolvedor como você, que irá interagir com o Rovo em um nível mais profundo, o controle sobre o que o agente pode fazer é igualmente importante. Isso é gerenciado através do Rovo Dev CLI e seu arquivo de configuração.
Dado seu background em desenvolvimento e DevOps, você apreciará este nível de controle declarativo.
Para o controle mais granular, especialmente sobre ações que modificam o sistema (como criar arquivos ou atualizar tickets), usamos o arquivo de configuração do Rovo Dev CLI. Vamos examinar as seções relevantes da documentação.
Leia as seções sobre 'MCP (Model Context Protocol)' e, mais importante, 'Tools' (toolPermissions). Observe como você pode definir uma política padrão ('allow', 'ask', 'deny') e, em seguida, especificar permissões para cada ferramenta individualmente, como create_file, updateJiraIssue e até mesmo comandos bash.
O arquivo config.yml do Rovo Dev CLI permite que você crie uma "sandbox" de segurança para as operações do agente. Por exemplo, você pode configurar:
default: "ask": O agente deve pedir sua confirmação para qualquer ação não listada explicitamente.open_files: "allow": Permitir que o agente leia arquivos sem perguntar.create_file: "ask": Exigir confirmação antes de criar um novo arquivo de código.delete_file: "deny": Proibir completamente que o agente exclua arquivos.bash: Definir permissões para comandos de shell, permitindolsecat(leitura), mas solicitando confirmação paragit commitoupnpm install.
Esse arquivo de configuração se tornará uma parte essencial do seu fluxo de trabalho, permitindo que você ajuste o equilíbrio entre autonomia e segurança para o seu agente.
Conclusão
Nesta lição, você explorou as múltiplas camadas de segurança e governança que protegem o ecossistema Rovo. Longe de ser um sistema "tudo ou nada", ele oferece controles granulares para gerenciar o que um agente é, o que ele pode ver e o que ele pode fazer.
Principais Pontos:
- Princípio da Herança: A regra mais importante é que um agente Rovo sempre opera com as permissões do usuário que o está executando.
- Escopos Externos: O acesso a fontes como Google Drive e GitHub é ainda limitado pelos escopos de permissão concedidos durante a configuração do conector.
- Governança do Agente: Você pode controlar quem na sua organização pode criar, editar e usar agentes.
- Escopo do Conhecimento: É uma boa prática restringir o "cérebro" de um agente a fontes de conhecimento específicas e relevantes para sua tarefa.
- Controle de Ações (Ferramentas): Para desenvolvedores, o arquivo
config.ymldo Rovo Dev CLI oferece controle granular sobre as ações que o agente pode executar, como operações de arquivo e comandos de shell.
Na Próxima Lição:
Agora que configuramos as fontes de conhecimento e definimos suas permissões, o próximo passo lógico é validar se o sistema de recuperação de informações está funcionando como esperado. Na próxima aula, vamos nos concentrar em testar a capacidade do agente de recuperar informações relevantes tanto do Google Drive quanto dos repositórios de código para uma determinada tarefa, garantindo que a base do nosso pipeline de RAG (Retrieval-Augmented Generation) está sólida.