Olá! Na lição anterior, estabelecemos uma base sólida para garantir a qualidade e a confiabilidade do seu agente de IA, projetando uma suíte de testes abrangente. Aprendemos a validar o comportamento do agente em cenários conhecidos, desde os "happy paths" até os casos de borda mais complexos.
Testes são essenciais para a confiança pré-implantação. Mas o que acontece quando o agente está operando em produção? Como sabemos se ele está saudável, performando bem e não encontrando erros inesperados? A resposta está no monitoramento contínuo e em alertas proativos.
Nesta lição, vamos focar em configurar monitoramento e alertas para as operações do seu agente usando os recursos de observabilidade da plataforma Atlassian Forge. Você aprenderá a ir além dos testes estáticos, implementando um sistema dinâmico que oferece visibilidade sobre o desempenho do agente em tempo real e notifica você e sua equipe quando problemas surgem.
1. Monitoramento vs. Observabilidade: Conhecendo o Estado do seu Agente
Antes de mergulharmos nas ferramentas do Forge, é crucial entender a distinção entre dois conceitos fundamentais no mundo de operações de software: monitoramento e observabilidade. Dado seu background em engenharia e sistemas, essa distinção será particularmente relevante.
-
Monitoramento é o ato de observar e rastrear métricas predefinidas ao longo do tempo. Ele responde a perguntas que você já sabe que precisa fazer, como: "Qual é a taxa de sucesso das invocações do meu agente?" ou "A latência está abaixo do nosso limite?". É um sistema de alerta para problemas conhecidos.
-
Observabilidade, por outro lado, é a capacidade de inferir o estado interno de um sistema a partir de seus outputs externos (logs, métricas, traces). Ela permite que você faça perguntas que não previu, como: "Por que as invocações relacionadas a tickets com a tag 'backend-refactor' estão falhando desde o último deploy?".
Observability vs Monitoring - Whats the difference?
Para aprofundar essa distinção, assista a este vídeo conciso do canal Better Stack. Ele usa uma excelente analogia do painel do carro versus uma ferramenta de diagnóstico.
Assista ao vídeo inteiro (cerca de 4 minutos). Preste atenção em como o monitoramento é o 'o quê' e o 'quando' (o painel do carro que acende a luz de alerta), enquanto a observabilidade é o 'como' e o 'porquê' (a ferramenta de diagnóstico que diz qual é o problema exato no motor). Para o seu agente, o monitoramento dirá que algo está errado, e as ferramentas de observabilidade do Forge ajudarão você a investigar a causa raiz.
Felizmente, a plataforma Atlassian Forge oferece recursos que abrangem ambos os aspectos, permitindo não apenas rastrear a saúde do seu agente, mas também investigar falhas.
2. Monitorando as Operações do Agente com o Forge
Seu agente de código, sendo uma aplicação Forge, terá todas as suas operações (funções, triggers, chamadas de API) executadas na infraestrutura da Atlassian. A plataforma coleta automaticamente métricas cruciais sobre essas operações, que podem ser visualizadas diretamente no Developer Console.
A documentação oficial do Atlassian Forge detalha as métricas de invocação disponíveis. Vamos explorar quais são e o que elas significam para o seu agente.
Leia as seções sobre as métricas de invocação, tempo de resposta e filtros. Ao ler, foque nos seguintes pontos: Invocation success rate: A principal métrica de saúde. Uma queda aqui é um forte indicador de problema. Invocation errors: Entenda os diferentes tipos, especialmente Unhandled exception, que sinaliza bugs no código do seu agente. Invocation response time: Preste atenção na explicação das métricas de percentil (P50, P90, P95). Elas são o padrão da indústria para medir a latência da perspectiva do usuário. Filters: Veja como os filtros (Environment, Sites, Function) são a sua primeira ferramenta de observabilidade para isolar problemas.
O painel de métricas no Developer Console se parecerá com isto:
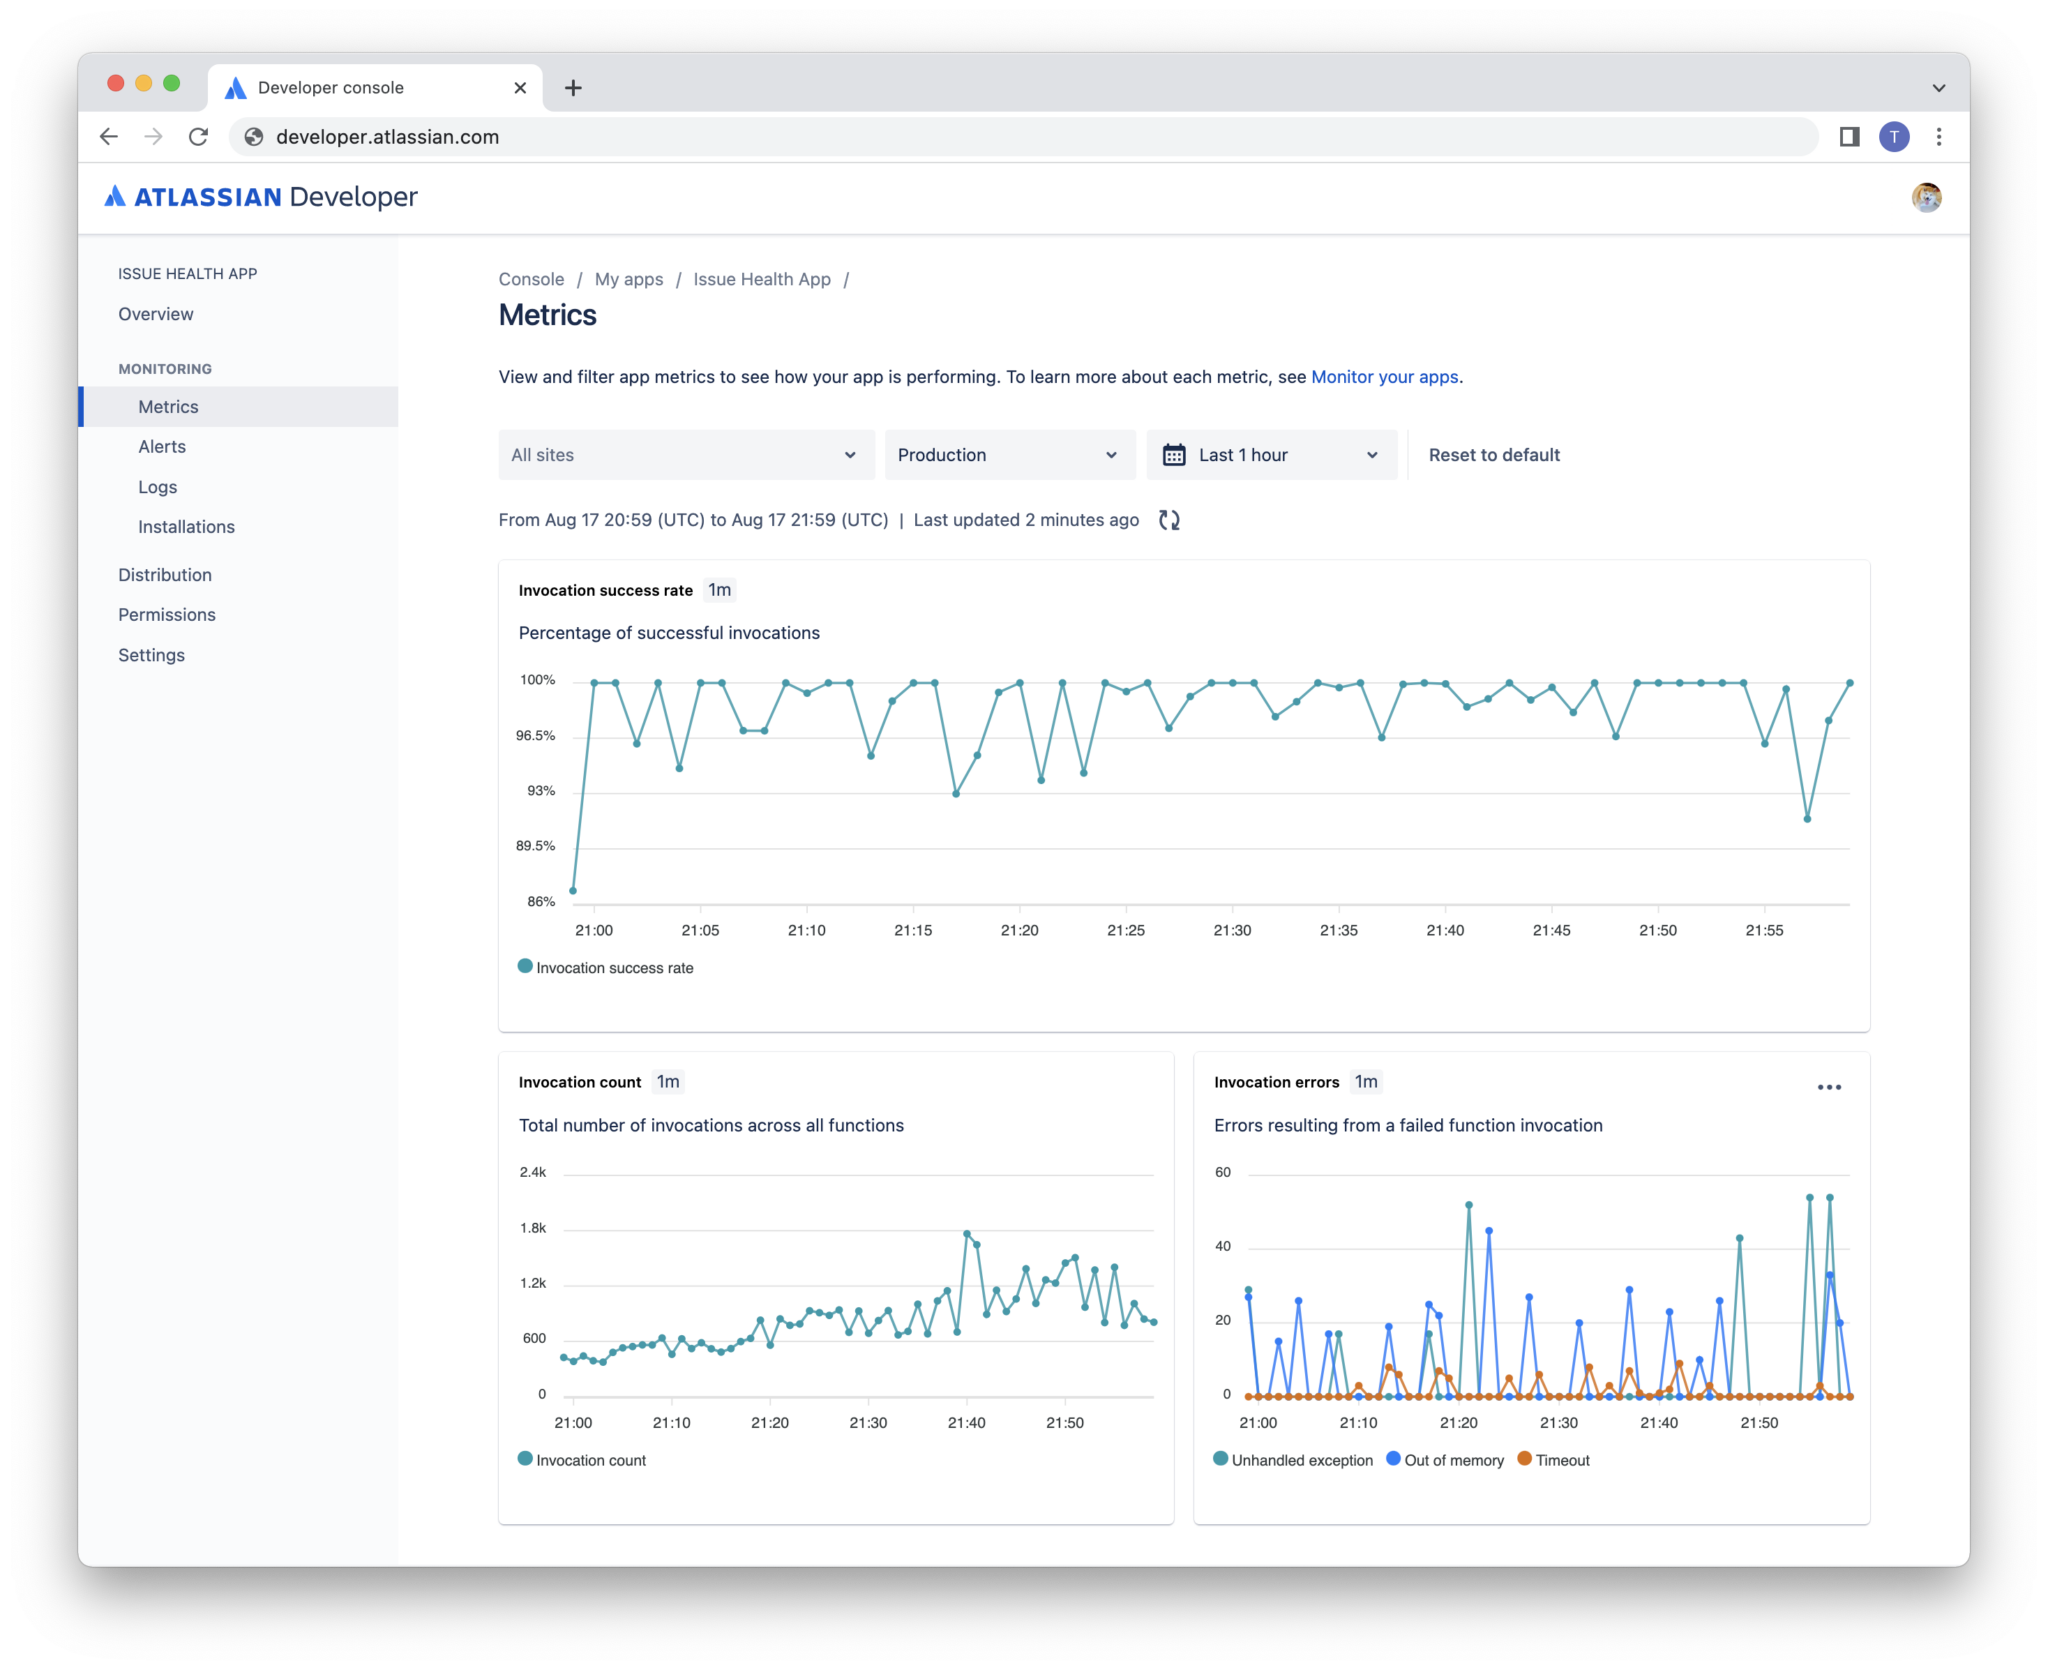
Para o seu agente, essas métricas se traduzem em insights diretos:
- Invocation success rate: Com que frequência o agente conclui uma tarefa (ex: analisar um ticket, gerar código) sem falhar?
- Invocation count: Quantas tarefas o agente está processando? Isso ajuda a entender a carga e a adoção.
- Invocation errors: Quando o agente falha, por quê? Foi um
Timeout(talvez uma chamada de LLM demorou demais),Out of memory, ou uma exceção não tratada no seu código? - Invocation response time: Quanto tempo o agente leva para completar um ciclo de
perceive-plan-act? O P95 lhe dirá qual é a experiência para os 5% de casos mais lentos.
Ter acesso a esses dados é ótimo, mas verificar um painel manualmente não é uma estratégia escalável. Precisamos que o sistema nos notifique proativamente quando algo estiver errado. É aqui que entram os alertas.
3. Configurando Alertas Proativos
Alertas são regras que você define sobre suas métricas. Quando uma métrica cruza um limite definido, um alerta é disparado e as pessoas designadas (responders) são notificadas, geralmente por e-mail. Isso transforma o monitoramento passivo em um sistema de vigilância ativo.
A criação de regras de alerta no Forge é um processo estruturado em quatro etapas. A documentação oficial nos guiará por esse processo.
Leia o guia completo para criar regras de alerta. Siga os quatro passos e pense em como você os aplicaria ao seu agente: Select alert source: Você escolheria Invocation success rate ou talvez Invocation errors filtrado por uma função crítica como generate_db_migration? Configure conditions: Qual seria um limiar razoável? Uma taxa de sucesso abaixo de 99% é um problema Minor ou Major? A configuração de alert tolerance é crucial para evitar ruído de picos temporários. Add responders: Quem na sua equipe deveria ser notificado? Specify alert details: Dê nomes claros como 'Critical Failure in DB Migration Generation' para que a equipe entenda a urgência imediatamente.
Uma regra de alerta configurada terá a seguinte aparência no console:

4. Estratégia de Alertas para o seu Agente
Vamos aplicar esses conceitos e criar uma estratégia de alertas inicial para o seu agente de código. Uma boa estratégia usa diferentes níveis de severidade para diferentes tipos de problemas.
Alerta de Saúde Geral (Major)
- Métrica:
Invocation success rate - Condição:
is below 95%durante um período de1 hour. - Tolerância:
2períodos consecutivos para evitar alertas por flutuações breves. - Descrição: "A taxa de sucesso geral do agente caiu abaixo de 95%. Isso indica um problema sistêmico que pode estar afetando múltiplos tipos de tarefas. A causa pode ser uma mudança na API do Jira/GitHub, um problema com o provedor de LLM, ou um bug introduzido no último deploy."
- Propósito: Este é o seu principal alerta de "saúde do sistema". Ele captura problemas generalizados.
Alerta de Performance (Minor)
- Métrica:
Invocation response time (P90) - Condição:
is above 15 secondsdurante um período de30 minutes. - Descrição: "90% das invocações do agente estão levando mais de 15 segundos para serem concluídas. A performance está degradada, o que pode impactar a produtividade. Investigar possíveis gargalos na busca de contexto ou na geração de código."
- Propósito: Detectar degradações de performance que afetam a experiência do usuário, mesmo que as tarefas não estejam falhando.
Alerta de Função Crítica (Critical)
- Métrica:
Invocation errors - Filtros:
Error Type:Unhandled exceptionFunction:generate_db_migration(o nome exato da sua função nomanifest.yml)
- Condição:
is above 0durante um período de15 minutes. - Tolerância:
1(queremos saber imediatamente). - Descrição: "Ocorreu uma falha crítica na função de geração de migração de banco de dados. Esta é uma operação de alto risco. A funcionalidade pode precisar ser desabilitada temporariamente até que a causa raiz seja encontrada."
- Propósito: Monitorar de perto as operações mais arriscadas do seu agente. Falhas aqui requerem atenção imediata para prevenir problemas de integridade de dados.
Esta combinação de alertas oferece uma cobertura robusta: um alerta geral para a saúde do sistema, um para a performance e um altamente específico para uma função de alto risco.
Conclusão
Nesta lição, você aprendeu como transformar seu agente de uma caixa-preta para um sistema transparente e observável. Passamos da teoria de monitoramento e observabilidade para a aplicação prática das ferramentas do Atlassian Forge.
Principais Pontos:
- Monitoramento e Observabilidade são Complementares: O monitoramento lhe diz se algo está errado, enquanto a observabilidade lhe dá as ferramentas (logs, métricas detalhadas, filtros) para descobrir por que está errado.
- Forge Metrics é seu Painel de Controle: O Developer Console fornece métricas essenciais prontas para uso, como taxa de sucesso, contagem de erros e latência de invocação.
- Alertas Tornam o Monitoramento Proativo: Ao configurar regras de alerta, você garante que sua equipe seja notificada sobre problemas assim que eles acontecem, permitindo uma resposta rápida.
- Estratégia de Alerta em Camadas: Combine alertas de diferentes severidades (
Minor,Major,Critical) para diferentes tipos de problemas (performance, saúde geral, falhas de funções críticas) para criar um sistema de monitoramento eficaz e com baixo ruído.
Com os testes da lição anterior e o monitoramento desta lição, você agora possui um framework completo para garantir a qualidade, confiabilidade e manutenção do seu agente de IA em um ambiente de produção.
Na nossa última lição, vamos consolidar todo o aprendizado e olhar para o futuro: desenvolver uma estratégia para atualizar e manter o agente ao longo do tempo, à medida que as regras de negócio, a arquitetura dos seus projetos e as próprias ferramentas de IA evoluem.