Olá! Bem-vindo ao nosso segundo módulo.
Na conclusão do módulo anterior, estabelecemos que, para construir seu agente de código, não basta ter uma arquitetura de planejamento e execução robusta; o agente precisa de conhecimento. Ele deve ser capaz de acessar e compreender informações que não faziam parte de seu treinamento original, como as regras de negócios da sua empresa em um Google Drive ou as diretrizes de arquitetura contidas em seus repositórios no GitHub.
Esta lição inaugura nossa exploração da tecnologia que torna isso possível. Nosso objetivo é explicar o conceito central de Retrieval-Augmented Generation (RAG) e sua necessidade para fundamentar LLMs em conhecimento específico. Ao final desta aula, você entenderá o que é RAG, por que é uma peça indispensável na construção de agentes de IA avançados e como ele se aplica diretamente ao seu projeto.
1. A Lacuna de Conhecimento: Por que LLMs Precisam de Ajuda
Large Language Models (LLMs) são incrivelmente poderosos, mas seu conhecimento não é infinito nem perfeito. Eles são treinados em um vasto, porém estático, corpus de dados. Isso leva a duas limitações fundamentais:
- Conhecimento Desatualizado: O conhecimento do modelo termina na data em que seu treinamento foi concluído. Ele não tem ciência de eventos, descobertas ou, no seu caso, novas regras de negócio ou atualizações de código que ocorreram após essa data.
- Falta de Conhecimento Específico/Privado: O modelo não foi treinado com os documentos internos da sua empresa. Ele não conhece suas políticas de RH, as especificidades do seu contrato com um cliente ou as diretrizes de arquitetura do seu projeto de backend.
Quando um LLM é questionado sobre algo que não sabe, ele pode "alucinar" — gerar uma resposta que parece plausível, mas é factualmente incorreta ou inventada.
Para começar, vamos assistir a um vídeo que ilustra esse problema de forma muito clara.
What is Retrieval-Augmented Generation (RAG)?
O vídeo 'What is Retrieval-Augmented Generation (RAG)?' do canal IBM Technology começa com uma excelente anedota para demonstrar os desafios dos LLMs, como fornecer informações desatualizadas sem fontes confiáveis.
Assista ao trecho inicial, de 00:00 a 01:46. Preste atenção nos dois problemas principais identificados: a falta de uma fonte para a informação e o fato de a informação estar desatualizada. Pense em como esses problemas se manifestariam se você perguntasse a um LLM padrão sobre as regras de arquitetura mais recentes do seu projeto.
Essas limitações tornam os LLMs, por si sós, inadequados para tarefas que exigem alta precisão e acesso a dados privados ou atuais — exatamente o cenário do seu agente de código. A solução para isso é um conceito chamado grounding.
2. Grounding: O "Exame com Consulta" para LLMs
O termo grounding (ou fundamentação) em IA refere-se ao processo de conectar as respostas de um LLM a uma fonte de conhecimento externa e verificável em tempo de inferência. Em vez de depender apenas do conhecimento "memorizado" durante o treinamento, o modelo é instruído a consultar uma fonte de informações relevante antes de responder.
Dada sua formação acadêmica, a analogia com o processo cognitivo humano pode ser útil. Quando nos deparamos com uma pergunta para a qual não sabemos a resposta, não inventamos; nós pesquisamos em uma fonte confiável (um livro, um artigo, a documentação) e baseamos nossa resposta nessa nova informação. O grounding permite que os LLMs façam o mesmo.
O artigo a seguir define formalmente o conceito de grounding e sua importância.
A Researcher's Guide to LLM Grounding
O artigo 'A Researcher's Guide to LLM Grounding' do blog Neptune.ai oferece uma explicação clara sobre o que é grounding e por que é um passo necessário para mitigar alucinações e preencher lacunas de conhecimento.
Leia as seções iniciais do artigo, começando logo após o sumário (TL;DR) até o final da seção 'What is LLM grounding?'. Concentre-se em entender a analogia com a cognição humana e como o grounding permite que as respostas do LLM sejam baseadas em informações suplementares, em vez de apenas no conhecimento pré-treinado.
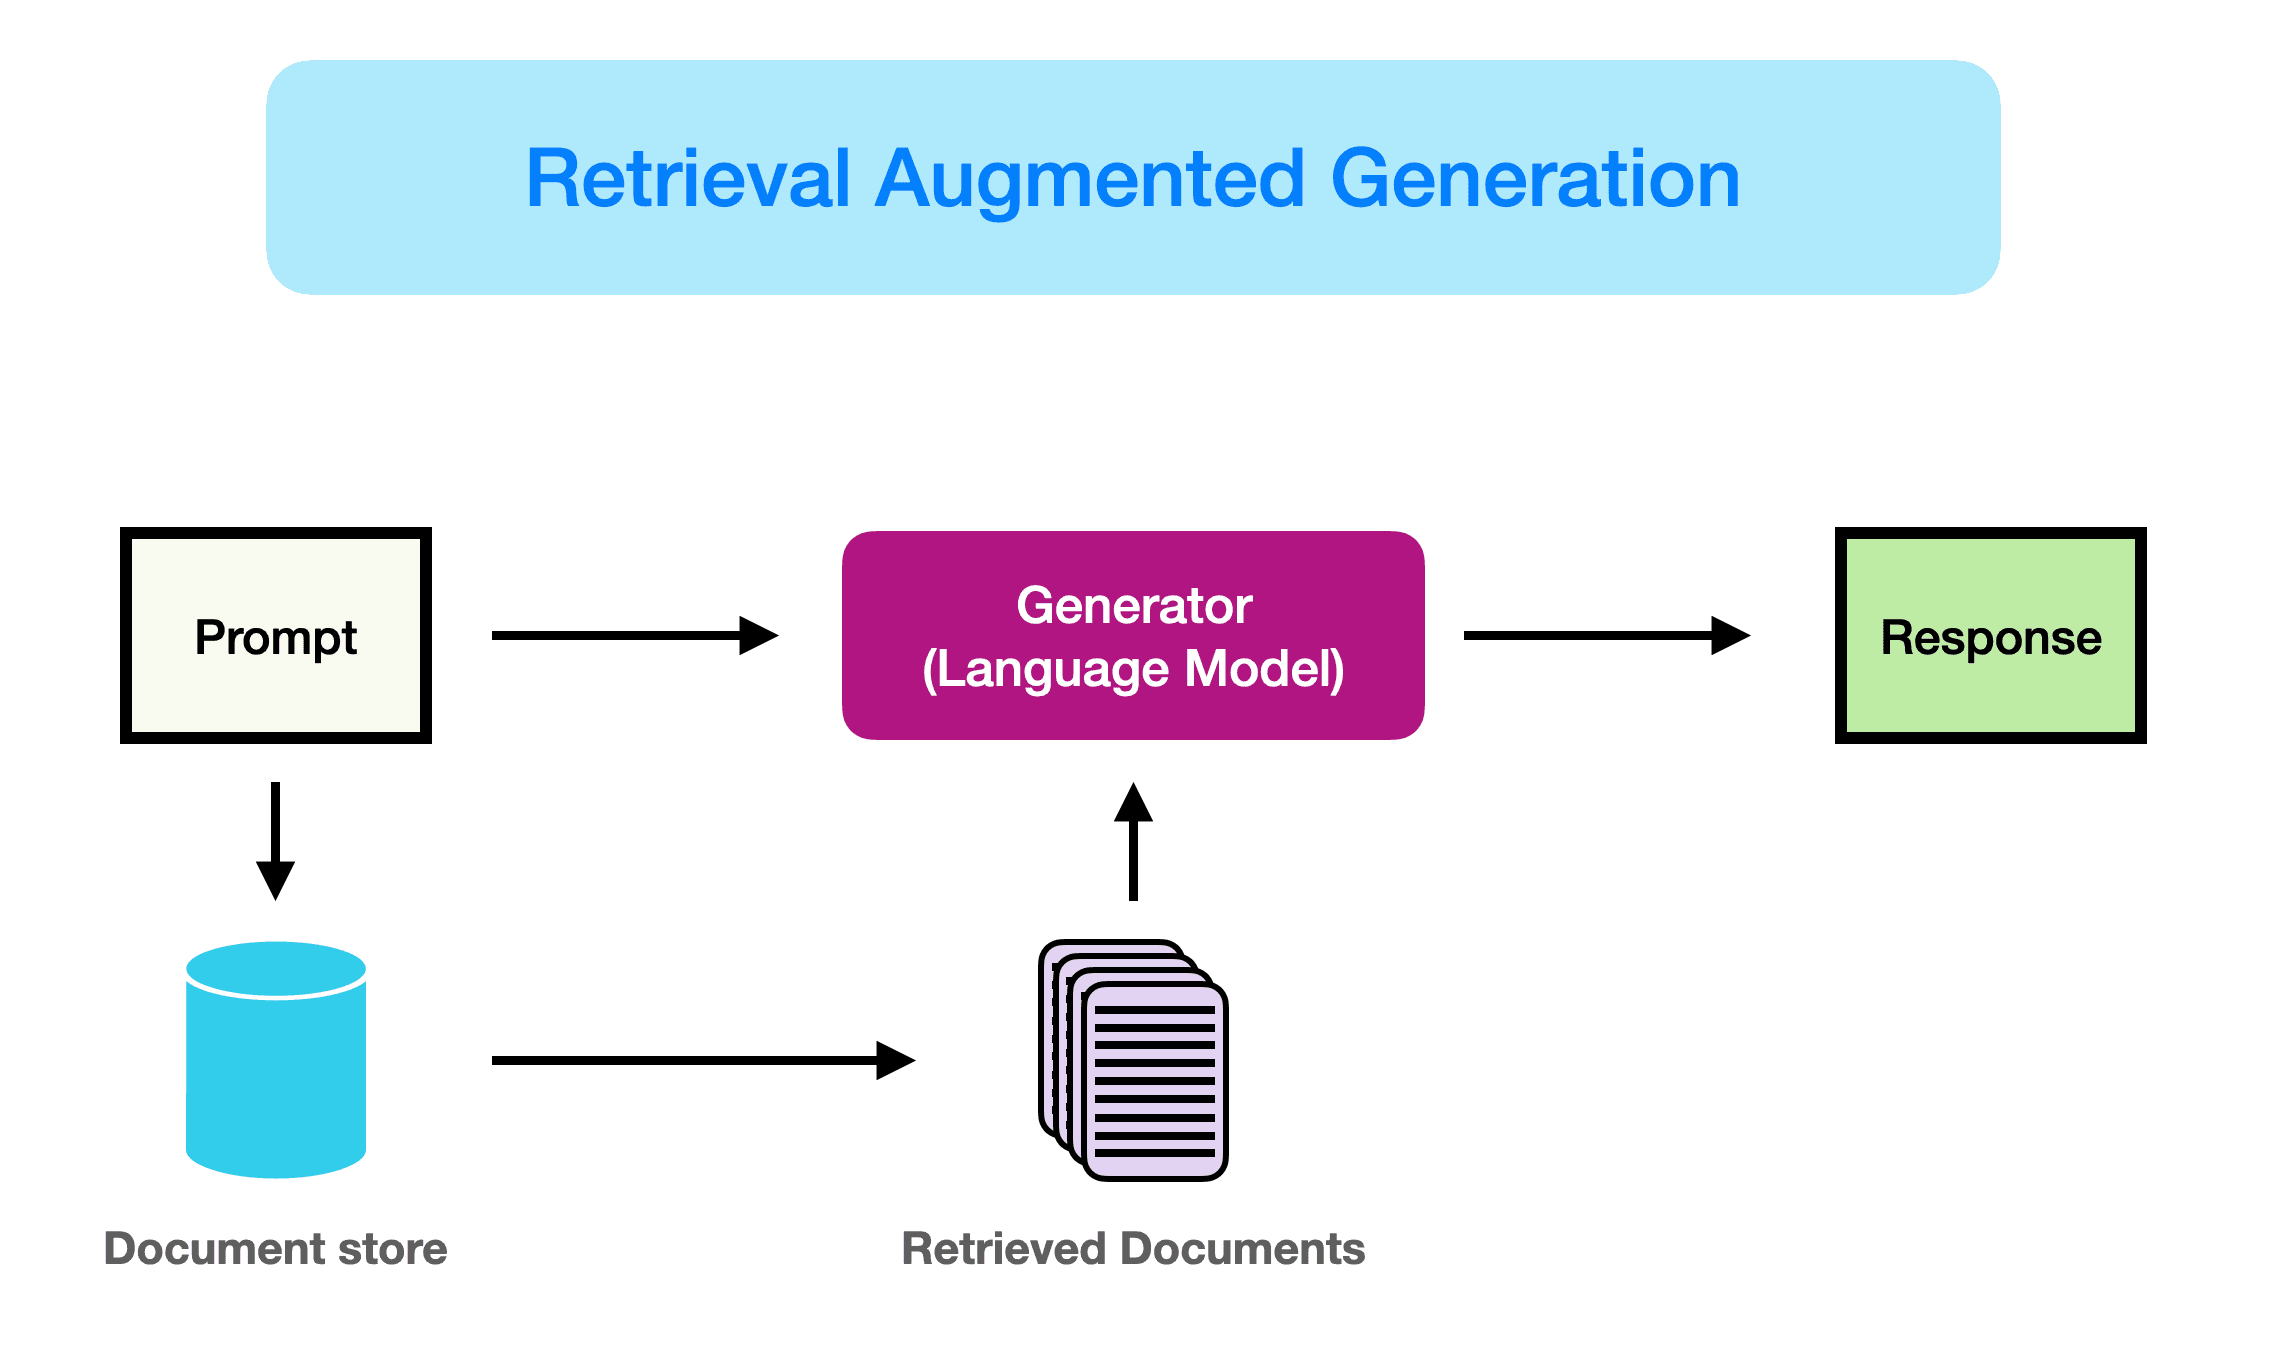
A principal técnica utilizada para implementar o grounding é a Retrieval-Augmented Generation (RAG). Como o nome sugere, o processo envolve duas fases principais:
- Retrieval (Recuperação): Encontrar e recuperar os trechos de informação relevantes da fonte de conhecimento externa.
- Generation (Geração): Usar essa informação recuperada para gerar uma resposta precisa e contextualizada.
A analogia mais comum, e talvez a mais eficaz, é a de um "exame com consulta" (open-book exam). Em um sistema sem RAG, o LLM faz um "exame de livro fechado", dependendo apenas de sua memória (parâmetros treinados). Com o RAG, ele pode consultar o livro (sua base de conhecimento externa) para encontrar a resposta correta.
3. O Framework RAG: Recuperação, Aumento e Geração
Vamos detalhar um pouco mais o fluxo de trabalho do RAG. O processo pode ser dividido em três etapas lógicas, que são essenciais para entender como seu agente irá interagir com os documentos do Google Drive e os arquivos do repositório.
O vídeo 'RAG Explained For Beginners' do canal KodeKloud divide o processo de RAG em três passos claros: Retrieval, Augmentation e Generation. Esta explicação é muito útil para estruturar o conceito.
Assista ao trecho de 01:41 a 03:58. O vídeo explica como a pergunta do usuário é usada para fazer uma busca semântica na base de conhecimento, como os resultados dessa busca são injetados (aumentados) no prompt e, finalmente, como o LLM gera uma resposta baseada nesse contexto enriquecido.
Resumindo as etapas que você acabou de ver:
-
Recuperação (Retrieval): Quando o agente recebe uma tarefa (por exemplo, "implementar a funcionalidade X conforme descrito no documento de regras de negócio Y"), ele não envia essa tarefa diretamente ao LLM. Primeiro, ele usa a essência da tarefa para buscar informações relevantes na sua base de conhecimento (Google Drive, repositórios de código, etc.). Nas próximas lições, veremos que isso é feito através de uma técnica chamada busca semântica com vector embeddings.
-
Aumento (Augmentation): Os trechos de texto recuperados (por exemplo, as seções relevantes do documento de regras de negócio) são então combinados com o prompt original. O novo prompt se parece com algo assim:
"Com base no seguinte contexto, implemente a funcionalidade X. Contexto: [trecho do documento de regras de negócio recuperado aqui]".
-
Geração (Generation): Apenas neste ponto o prompt aumentado é enviado ao LLM. O modelo agora tem o contexto exato e específico de que precisa para gerar uma resposta precisa e fundamentada, seja um trecho de código, um plano de ação ou um script de migração de banco de dados.
4. A Necessidade do RAG para Seu Agente
Agora, vamos conectar todos esses pontos ao seu objetivo final. O RAG não é apenas um conceito teórico interessante; é a tecnologia essencial que permitirá que seu agente execute as tarefas que você imaginou.
- Acessar Regras de Negócio: Quando uma tarefa do Jira mencionar um documento de especificação no Google Drive, o RAG será o mecanismo que permitirá ao agente "ler" esse documento e extrair as regras relevantes para a implementação.
- Seguir Diretrizes de Arquitetura: Se seu repositório contém arquivos
README.mdou documentos na pastadocs/que descrevem padrões de arquitetura e boas práticas, o RAG permitirá que o agente consulte esses arquivos para garantir que o código gerado esteja em conformidade. - Garantir Atualização e Precisão: As regras de negócio e as arquiteturas de software evoluem. Com o RAG, você não precisa treinar novamente um modelo de IA multibilionário. Basta atualizar os documentos na sua base de conhecimento (Google Drive, Git). O agente sempre terá acesso à versão mais recente.
- Reduzir Alucinações e Aumentar a Confiança: Ao forçar o agente a basear suas respostas em documentos concretos, você reduz drasticamente a chance de ele "inventar" uma implementação. Além disso, o sistema pode (e deve) citar suas fontes, permitindo que os desenvolvedores verifiquem de onde veio a lógica para a geração do código.
O artigo a seguir, do IBM Research, aprofunda esses benefícios e apresenta um exemplo prático no contexto empresarial.
What is retrieval-augmented generation (RAG)? - IBM Research
Para consolidar nosso entendimento, vamos ler o artigo 'What is retrieval-augmented generation (RAG)?' da IBM Research. Ele resume os benefícios e apresenta um cenário de uso corporativo.
Leia as seções destacadas no artigo: 'What is retrieval-augmented generation?': Reforce a definição e o principal benefício. 'RAG has additional benefits': Preste atenção na lista de vantagens, como redução de custos e de vazamento de dados sensíveis. 'Toward personalized and verifiable responses': Entenda como o RAG permite respostas personalizadas e o exemplo prático do chatbot de RH, que é muito análogo ao que seu agente fará (puxar dados de fontes específicas para responder a uma consulta). 'Teaching models to recognize when it doesn’t know': Veja como o RAG ajuda o modelo a evitar inventar respostas quando a informação não está disponível, um comportamento crucial para a confiabilidade do seu agente.
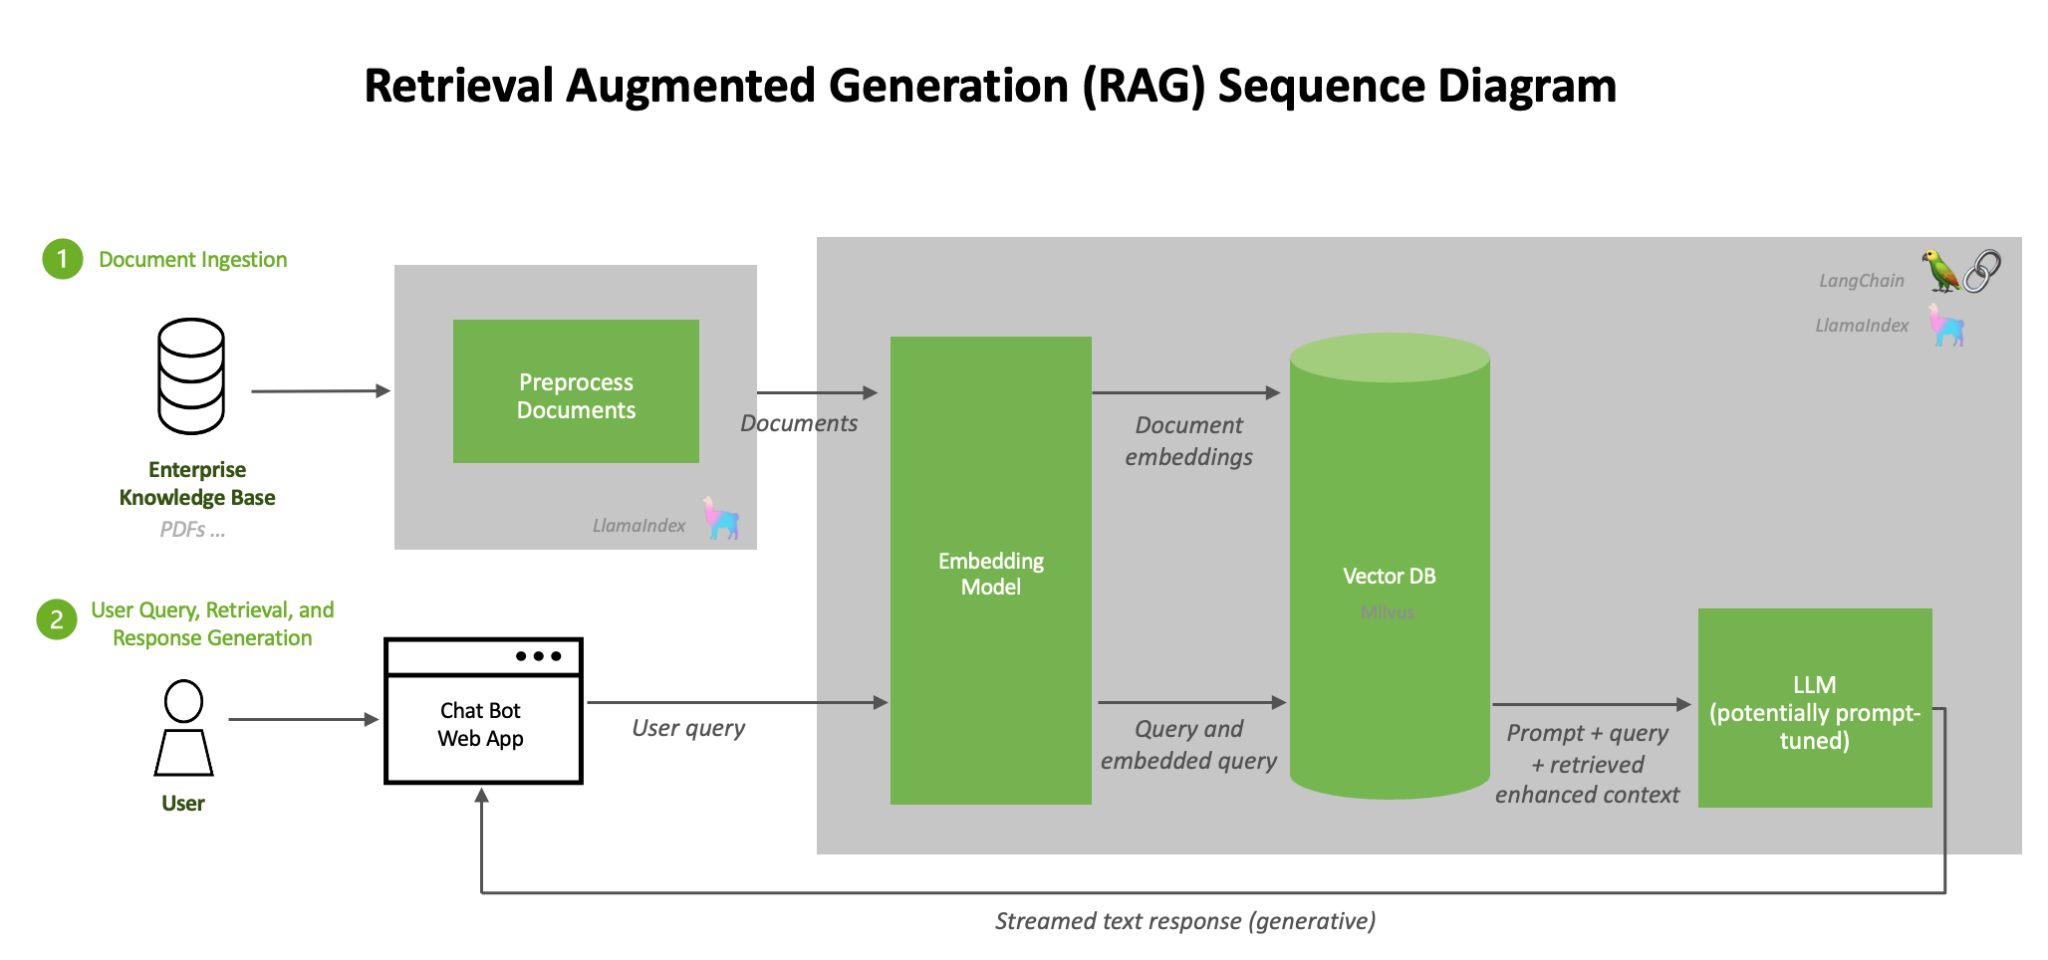
O diagrama abaixo, mais detalhado, mostra como a base de conhecimento é criada (ingestão) e como ela é usada para responder a uma pergunta (consulta). Nas próximas lições, vamos dissecar cada um desses blocos.
Conclusão
Nesta lição, estabelecemos a base para um dos pilares mais importantes do seu projeto. Vimos que os LLMs, apesar de suas capacidades impressionantes, possuem lacunas de conhecimento significativas que os impedem de realizar tarefas que exigem informações específicas, privadas ou atuais.
Principais Pontos:
- Grounding (Fundamentação) é o processo de conectar um LLM a uma fonte de conhecimento externa para garantir que suas respostas sejam precisas e verificáveis.
- Retrieval-Augmented Generation (RAG) é o principal framework para implementar o grounding. Ele funciona como um "exame com consulta", permitindo que o modelo recupere informações relevantes antes de gerar uma resposta.
- O fluxo do RAG consiste em três etapas: Recuperação de informações de uma base de conhecimento, Aumento do prompt do usuário com essas informações e Geração de uma resposta fundamentada pelo LLM.
- Para o seu agente de código, o RAG é a tecnologia necessária para acessar regras de negócio, diretrizes de arquitetura e outras informações proprietárias, garantindo que o código gerado seja preciso, atual e alinhado com os padrões da sua empresa.
Na Próxima Lição:
Agora que você entende o que é o RAG e por que ele é necessário, a próxima pergunta lógica é: como funciona a etapa de "Recuperação"? Como o sistema consegue encontrar os trechos de texto mais relevantes em um mar de documentos de forma eficiente? A resposta está nos vetores de embedding. A próxima lição, "Descrever como o texto é convertido em embeddings de vetores numéricos para busca semântica", mergulhará no coração matemático do processo de recuperação.