Olá! Vamos para a nossa sexta e última lição do módulo sobre os princípios da Geração Aumentada por Recuperação (RAG).
Introdução
Na lição anterior, orquestramos um pipeline RAG completo, unindo as etapas de recuperação, aumentação e geração para produzir respostas a partir de uma base de conhecimento. Construímos o motor, mas agora enfrentamos a pergunta mais crítica em qualquer projeto de engenharia: "Como sabemos que ele funciona bem?" e "O que fazemos quando ele falha?". Um agente de IA que gera código incorreto ou alucina fatos pode ser mais prejudicial do que útil.
O objetivo desta lição é aprender a avaliar a qualidade da saída de um pipeline RAG e a diagnosticar seus modos de falha comuns. Abordaremos como medir a eficácia de cada componente do pipeline de forma isolada, permitindo que você identifique e corrija problemas de maneira sistemática, assim como faria ao depurar um sistema de software complexo.
Ao final desta lição, você estará equipado com o conhecimento teórico e prático para transformar um RAG que "funciona" em um RAG que é confiável, preciso e pronto para produção.
1. Por Que a Avaliação de RAG é Complexa?
Quando um pipeline RAG produz uma resposta incorreta, a causa raiz pode estar em vários lugares. O sistema recuperou os documentos errados? Ou recuperou os documentos certos, mas o LLM os ignorou ou interpretou mal? Sem uma estratégia de avaliação, você fica apenas com o sintoma (a resposta errada), sem um diagnóstico claro.
O artigo a seguir explica essa complexidade e introduz o conceito de avaliação desagregada, que é a prática de testar os componentes de recuperação (retriever) e geração (generator) de forma independente.
Para entender as fontes de falha em um sistema RAG, leia o início do artigo 'RAG System Evaluation Guide' da Comet.
Leia a seção 'How RAG Systems Fail (And Why Evaluation Must Be Disaggregated)'. Preste atenção ao exemplo do assistente de RH. Ele ilustra perfeitamente como uma mesma resposta errada pode originar-se de uma falha de recuperação ou de uma falha de geração, exigindo correções totalmente diferentes.
Essa separação é análoga aos testes de software:
- Avaliação do Retriever: Similar a um teste unitário, verifica se um componente específico (a busca semântica) está retornando os dados corretos.
- Avaliação do Generator: Também como um teste unitário, verifica se, dado o contexto correto, o LLM consegue gerar uma resposta precisa e fiel.
- Avaliação End-to-End: Corresponde a um teste de integração, avaliando o desempenho do sistema como um todo.
A imagem abaixo ilustra esses cenários de falha. Mesmo com uma boa geração, a recuperação ruim leva a uma resposta errada. E mesmo com uma boa recuperação, uma alucinação na geração também leva a um erro.

2. A Tríade de Avaliação do RAG
Para estruturar nossa avaliação, podemos usar um framework conhecido como a "Tríade do RAG". Ele se concentra em medir a qualidade de três relações fundamentais no pipeline.
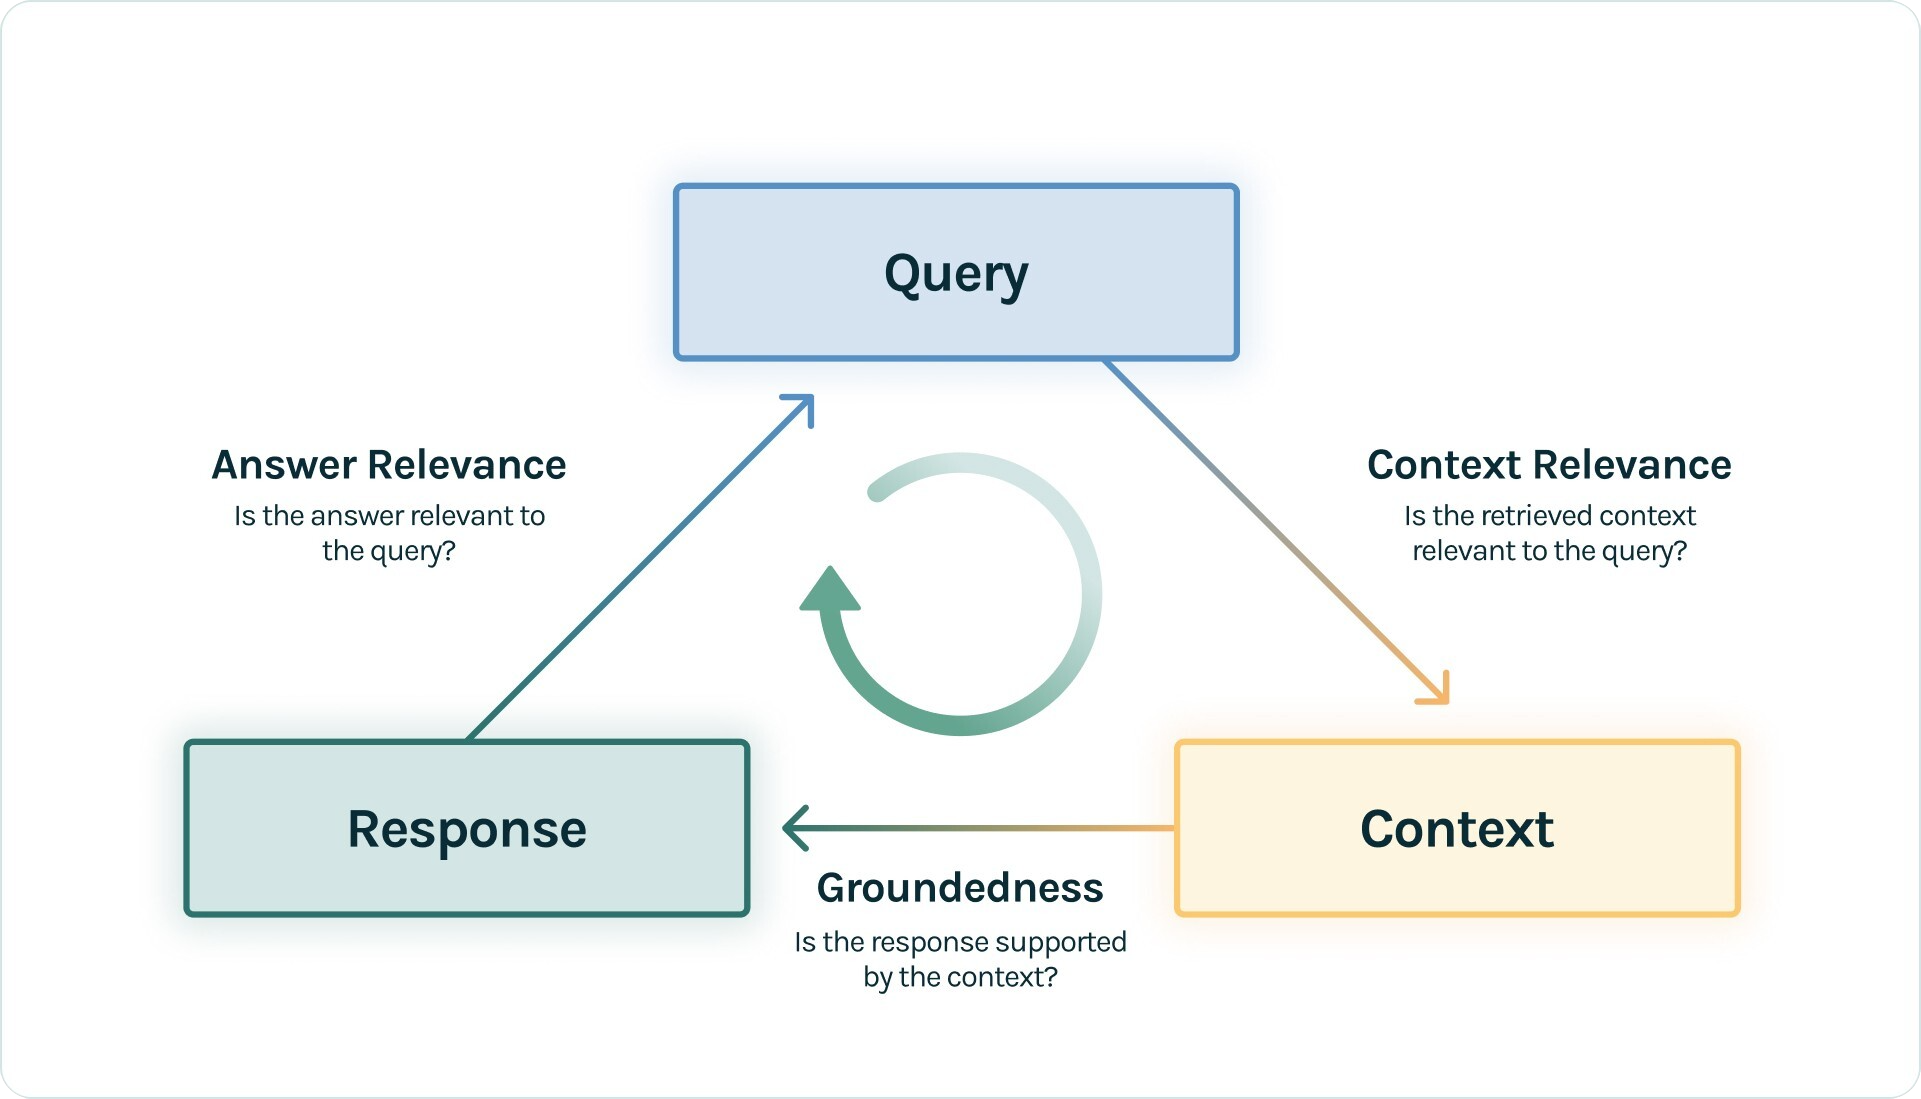
A tríade consiste em:
- Context Relevance (Relevância do Contexto): Avalia a qualidade do seu retriever. Os chunks recuperados são relevantes para a pergunta do usuário?
- Faithfulness/Groundedness (Fidelidade/Fundamentação): Avalia a honestidade do seu generator. A resposta gerada está estritamente baseada no contexto fornecido, sem inventar informações (alucinar)?
- Answer Relevance (Relevância da Resposta): Avalia o resultado final. A resposta gerada, mesmo que fiel ao contexto, de fato responde à pergunta original do usuário?
Vamos agora detalhar as métricas usadas para medir cada um desses aspectos.
3. Métricas de Avaliação
A avaliação de RAG não se baseia em uma única métrica, mas em um conjunto delas, cada uma focada em um aspecto do pipeline. A maioria das métricas modernas utiliza o paradigma LLM-as-a-Judge, onde um LLM poderoso (como o GPT-4) é usado para avaliar a saída do seu sistema com base em critérios definidos.
O vídeo a seguir oferece uma visão geral das métricas mais importantes para as etapas de recuperação e geração.
Key Metrics and Evaluation Methods for RAG
O vídeo 'Key Metrics and Evaluation Methods for RAG' do canal What's AI by Louis-François Bouchard introduz as métricas essenciais que vamos explorar.
Assista aos trechos indicados: A Importância da Avaliação (00:54 - 01:45): Reforça por que a avaliação é crucial para mover um projeto de RAG de um 'demo' para um produto confiável. Métricas de Recuperação (02:17 - 04:20): Apresenta métricas como Precision, Recall, Hit Rate, MRR e NDCG. Focaremos em Precision e Recall. Métricas de Geração (04:20 - 05:16): Introduz Faithfulness, Answer Relevancy e Answer Correctness, que são o cerne da avaliação do gerador.
Vamos nos aprofundar nas métricas mais críticas para diagnosticar problemas.
3.1. Métricas do Retriever
Aqui, nosso objetivo é responder: "O retriever encontrou os chunks de informação corretos e relevantes?". As duas métricas mais importantes são Context Precision e Context Recall.
Para entendê-las, é útil revisitar os conceitos de Verdadeiros/Falsos Positivos/Negativos, que são fundamentais em engenharia e ciência de dados.
AI Agent Evaluation with RAGAS
O vídeo 'AI Agent Evaluation with RAGAS' de James Briggs oferece uma explicação fantástica desses conceitos a partir dos primeiros princípios, tornando-os muito claros.
Assista ao trecho de 09:18 a 15:52. Ele detalha: Fundamentos (09:18 - 11:38): Uma explicação clara das quatro condições possíveis (Verdadeiro Positivo, Verdadeiro Negativo, Falso Positivo, Falso Negativo) no contexto da recuperação de documentos. Context Recall (11:38 - 14:34): Explica como o Recall mede a capacidade do sistema de encontrar todos os documentos relevantes. A fórmula é \frac{\text{Verdadeiros Positivos}}{\text{Verdadeiros Positivos} + \text{Falsos Negativos}}. Context Precision (14:34 - 15:52): Mostra como a Precision mede a proporção de documentos relevantes dentre os que foram recuperados. A fórmula é \frac{\text{Verdadeiros Positivos}}{\text{Verdadeiros Positivos} + \text{Falsos Positivos}}.
Em resumo:
- Context Recall: Mede a completude da busca. Uma pontuação baixa significa que seu retriever está deixando informações importantes para trás.
- Context Precision: Mede a pureza da busca. Uma pontuação baixa significa que seu retriever está trazendo muito "lixo" (chunks irrelevantes), o que pode confundir o LLM e desperdiçar espaço no contexto.
3.2. Métricas do Generator
Aqui, assumimos que o retriever fez seu trabalho e forneceu o contexto correto. A pergunta agora é: "O LLM usou esse contexto para gerar uma resposta boa e precisa?".
As duas métricas principais são:
- Faithfulness (Fidelidade): Mede a factualidade da resposta em relação ao contexto fornecido. Uma pontuação de
1.0significa que cada afirmação na resposta pode ser verificada no contexto. Uma pontuação baixa indica alucinação. - Answer Relevancy (Relevância da Resposta): Mede o quão bem a resposta aborda a pergunta original do usuário. Uma resposta pode ser 100% fiel aos fatos, mas completamente inútil se não responder à pergunta.
RAG Evaluation Metrics: Assessing Answer Relevancy
O artigo 'RAG Evaluation Metrics' da Confident AI fornece uma excelente descrição detalhada dessas métricas de geração, juntamente com exemplos.
Leia a seção 'Generation Evaluation Metrics'. Foque nas subseções 'Answer Relevancy' e 'Faithfulness'. Elas explicam o que cada métrica quantifica e por que são importantes para avaliar o comportamento do LLM.
4. Processo de Avaliação na Prática
Agora que conhecemos as métricas, como as aplicamos? O processo é semelhante a configurar um pipeline de testes para software.
-
Criar um Dataset de Avaliação: Você precisa de um conjunto de teste ("golden dataset") que contenha pares de
(pergunta, resposta_esperada). Para métricas de recuperação, você também pode precisar anotar quais chunks de documentos são relevantes para cada pergunta.- Este dataset pode ser criado por especialistas no domínio (como você e seus colegas), ou você pode usar um LLM avançado para gerar perguntas e respostas a partir dos seus documentos, como sugerido no vídeo de Louis-François Bouchard (recurso LINK, seção 3).
-
Executar o Pipeline RAG: Para cada pergunta no seu dataset, execute seu pipeline RAG e colete as saídas: a
resposta_geradae ocontexto_recuperado. -
Calcular as Métricas: Use um framework de avaliação para calcular as métricas. Ferramentas como Ragas (usada no vídeo de James Briggs) ou DeepEval (do artigo da Confident AI) automatizam isso. Elas pegam a pergunta, a resposta esperada, a resposta gerada e o contexto recuperado, e usam um LLM-juiz para gerar as pontuações.
O vídeo a seguir mostra como isso é feito em código usando Ragas e LangChain. A linguagem é Python, mas a lógica é universal e se aplicaria de forma análoga em C# com Semantic Kernel e uma biblioteca de avaliação.
AI Agent Evaluation with RAGAS
Vamos voltar ao vídeo de James Briggs para ver a implementação prática da avaliação.
Assista ao trecho de 03:33 a 08:55. Não se preocupe com os detalhes da sintaxe Python. Foque na sequência de passos: Extrair os Dados (03:33 - 05:08): O código é configurado para capturar as saídas do pipeline: a resposta final (output) e os chunks de contexto recuperados (intermediate_steps). Formatar o Dataset (05:08 - 06:32): Os dados coletados são organizados em um formato que a biblioteca de avaliação (Ragas) espera. Executar a Avaliação (08:00 - 08:55): Uma única função evaluate é chamada, passando o dataset e a lista de métricas a serem calculadas. O resultado é convenientemente convertido em uma tabela para análise.
5. Diagnosticando Falhas Comuns
O verdadeiro poder das métricas está em usá-las para diagnosticar problemas. Abaixo está um resumo que conecta pontuações baixas em métricas a causas prováveis e correções potenciais.
| Métrica | O que uma Pontuação Baixa Significa? | Causas Comuns | Possíveis Soluções |
|---|---|---|---|
| Context Recall | O retriever não encontrou informações cruciais que existem na base de dados. | Estratégia de chunking inadequada (chunks muito grandes/pequenos), modelo de embedding fraco para o seu domínio, parâmetro top_k muito baixo. |
Ajustar tamanho/sobreposição dos chunks, testar outros modelos de embedding, aumentar o top_k. |
| Context Precision | O retriever trouxe muito ruído (chunks irrelevantes) junto com os úteis. | top_k muito alto, documentos fonte com muito texto genérico, busca semântica capturando significados errados. |
Reduzir o top_k, implementar um passo de reranking para reordenar os resultados, limpar os documentos fonte. |
| Faithfulness | O LLM está alucinando; inventando fatos que não estão no contexto fornecido. | Prompt de sistema fraco (não instrui o modelo a ser fiel), modelo de LLM propenso a alucinar, temperatura do modelo muito alta. | Reforçar o prompt ("Use apenas a informação fornecida..."), usar um modelo mais capaz (ex: GPT-4), diminuir a temperatura para 0. |
| Answer Relevancy | A resposta é factualmente correta, mas não responde à pergunta do usuário. | O LLM se distraiu com detalhes irrelevantes no contexto, o prompt é ambíguo, a pergunta original do usuário era vaga. | Melhorar a Context Precision para reduzir o ruído, refinar o prompt para focar o LLM na tarefa, adicionar um passo de pré-processamento para esclarecer a pergunta do usuário. |
Esses diagnósticos são discutidos em detalhe nos recursos, especialmente nos artigos da Comet (LINK) e Confident AI (LINK).
Conclusão
Nesta lição, você aprendeu a ir além da simples implementação de um pipeline RAG e a entrar no domínio da avaliação de qualidade e diagnóstico de falhas, uma etapa indispensável para construir sistemas de IA robustos.
Principais Pontos:
- A avaliação de RAG deve ser desagregada, testando o retriever e o generator separadamente para um diagnóstico preciso.
- A Tríade do RAG (Context Relevance, Faithfulness, Answer Relevance) fornece um framework conceitual sólido para a avaliação.
- As métricas chave para o retriever são Context Precision e Context Recall, que medem a pureza e a completude da busca.
- As métricas chave para o generator são Faithfulness (anti-alucinação) e Answer Relevancy (utilidade da resposta).
- O processo prático envolve criar um dataset de avaliação, executar o pipeline para coletar resultados e usar frameworks de automação (como Ragas ou DeepEval) para calcular as métricas.
- As pontuações das métricas servem como sinais para diagnosticar problemas específicos no seu pipeline, desde o chunking até o prompting.
Na Próxima Lição:
Com esta lição, concluímos nosso mergulho nos princípios fundamentais dos agentes de IA e do RAG. Agora você tem a base teórica necessária para começar a construir. No próximo módulo, "O Ecossistema de IA da Atlassian: Jira, Forge e Rovo", faremos a transição da teoria para a prática no ambiente específico do seu projeto. Começaremos explorando a arquitetura da plataforma Atlassian e como suas ferramentas de IA se encaixam, preparando o terreno para conectar esses conceitos ao seu objetivo final.