Olá! Bem-vindo de volta.
Na lição anterior, vimos como transformar texto — como o conteúdo de uma tarefa do Jira ou um documento de regras de negócio — em embeddings, que são vetores numéricos que capturam o significado semântico. Agora temos a capacidade de representar "criar um pull request" e "submeter um PR" como vetores que são matematicamente próximos.
Isso nos leva a um desafio de engenharia: para o seu agente encontrar a regra de negócio correta, ele precisará comparar o vetor da tarefa do Jira com os vetores de todos os documentos de regras da sua empresa. Com milhares de documentos, que se tornam dezenas ou centenas de milhares de "chunks" (pedaços de texto), comparar um vetor com todos os outros em tempo real é computacionalmente inviável. Uma varredura linear simples não é escalável.
Nesta lição, vamos explorar a solução para esse problema. O nosso objetivo é explicar a função de um vector store (ou banco de dados de vetores) na indexação, armazenamento e recuperação de embeddings. Veremos como essas ferramentas especializadas tornam a busca por similaridade não apenas possível, mas extremamente rápida.
1. O que é um Vector Store?
Um vector store, ou banco de dados de vetores, é um sistema de banco de dados especializado, projetado desde o início para armazenar, gerenciar e pesquisar grandes volumes de embeddings de vetores de alta dimensão de forma eficiente.
Sua principal diferença em relação aos bancos de dados com os quais você já trabalha (como MySQL, PostgreSQL ou MongoDB) reside no tipo de consulta que eles otimizam:
- Bancos de Dados Tradicionais: São otimizados para consultas estruturadas com correspondências exatas ou baseadas em intervalos. Por exemplo:
SELECT * FROM Issues WHERE status = 'Done'. - Bancos de Dados de Vetores: São otimizados para consultas de similaridade. A consulta não é "encontre o vetor que é igual a este", mas sim "encontre os k vetores mais próximos a este vetor de consulta".
Para entender o papel fundamental de um banco de dados de vetores, assista à introdução do vídeo a seguir.
Understanding How Vector Databases Work!
O vídeo 'Understanding How Vector Databases Work!' do canal The ML Tech Lead, introduz o conceito de banco de dados de vetores e seu papel fundamental no contexto de LLMs e RAG.
Assista do início até 01:43. Preste atenção em como o banco de dados de vetores é posicionado como a ferramenta para armazenar representações vetoriais de dados e como ele é consultado para encontrar vizinhos próximos, que então fornecem contexto para um LLM.
2. O Desafio da Busca: Por que a Eficiência é Crucial
Para entender por que precisamos de um banco de dados especializado, vamos considerar o método de força bruta para encontrar os embeddings mais semelhantes, conhecido como k-Nearest Neighbors (k-NN) exato:
- Pegue o vetor da sua consulta (ex: o embedding da sua tarefa do Jira).
- Calcule a similaridade de cosseno entre o vetor da consulta e todos os outros vetores no seu banco de dados.
- Ordene os resultados pela pontuação de similaridade.
- Retorne os k melhores resultados.
A complexidade computacional desse processo é linear, , onde é o número de vetores e é a dimensionalidade dos vetores. Com milhões de vetores de, digamos, 1536 dimensões (um padrão comum), essa operação se torna lenta demais para aplicações interativas.
A solução para isso é o Approximate Nearest Neighbor (ANN) search. A ideia central do ANN é fazer uma troca inteligente: sacrificamos uma pequena e muitas vezes imperceptível quantidade de precisão para ganhar ordens de magnitude em velocidade de busca. Em vez de garantir que encontraremos o vizinho exatamente mais próximo, os algoritmos ANN nos dão os vizinhos que são muito provavelmente os mais próximos, e fazem isso de forma incrivelmente rápida. Para aplicações de RAG, essa aproximação é perfeitamente aceitável e necessária.
3. Como a Busca Rápida Funciona: Indexação de Vetores
A "mágica" por trás da busca ANN está na indexação. Assim como um índice em um banco de dados relacional acelera as consultas SELECT, um índice de vetor organiza os embeddings de uma forma que permite ao sistema descartar rapidamente vastas porções do espaço de busca.
Vamos explorar conceitualmente duas das técnicas de indexação mais populares.
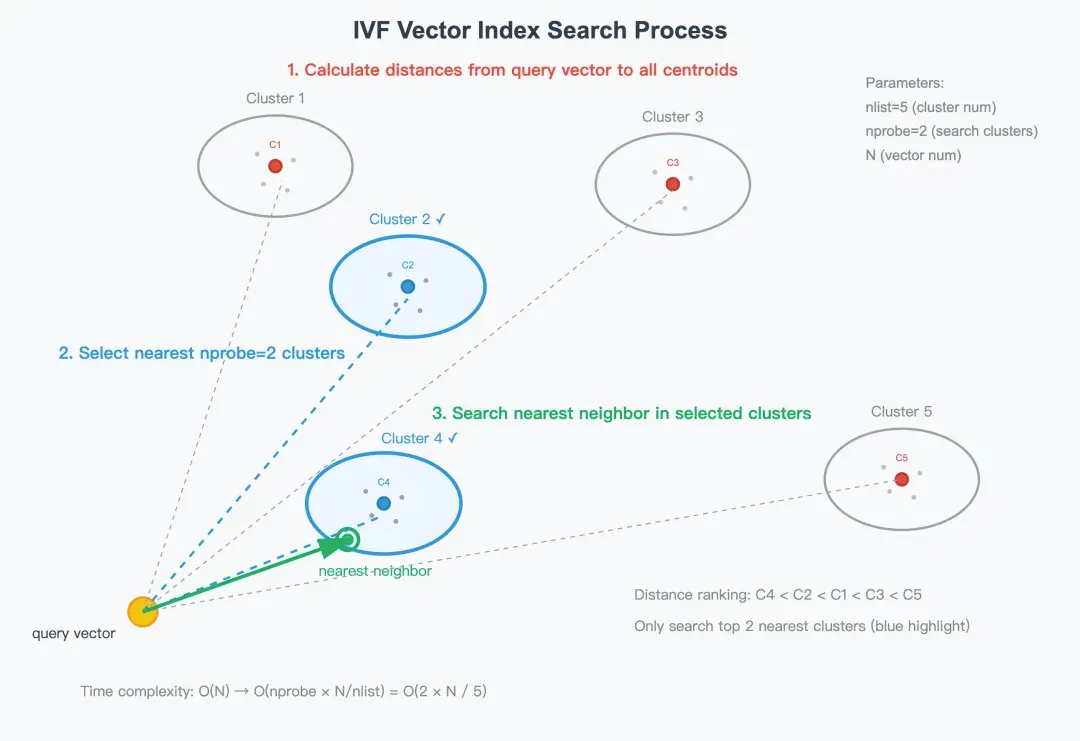
a) Inverted File Index (IVF)
O IVF funciona de forma análoga a organizar arquivos em pastas.
- Treinamento (Clustering): Primeiro, o algoritmo agrupa todos os vetores do banco de dados em um número pré-definido de clusters (agrupamentos) usando um algoritmo como o K-Means. O centro de cada cluster é chamado de centroide. A lista de clusters e os vetores que eles contêm formam o "arquivo invertido".
- Busca: Quando uma nova consulta chega:
- O sistema primeiro compara o vetor da consulta apenas com os centroides dos clusters para encontrar os clusters mais próximos.
- Em seguida, ele realiza a busca por força bruta (k-NN exato) somente dentro desses poucos clusters selecionados, ignorando todos os outros.
Isso reduz drasticamente o número de comparações necessárias.
b) Hierarchical Navigable Small World (HNSW)
O HNSW adota uma abordagem baseada em grafos e é uma das técnicas de maior desempenho disponíveis atualmente.
- Construção: O HNSW constrói um grafo com múltiplas camadas. Os vetores são os nós do grafo.
- Camada Superior: Contém poucos nós com conexões de "longo alcance" que atravessam o espaço vetorial. Pense nisso como um sistema de rodovias interestaduais.
- Camadas Inferiores: São progressivamente mais densas, com conexões de "curto alcance" entre vizinhos próximos. Pense nisso como as ruas e estradas locais.
- Busca: A busca começa em um ponto de entrada na camada superior.
- O algoritmo navega "vorazmente" pelo grafo na camada superior, sempre se movendo para o nó mais próximo do vetor de consulta.
- Quando não consegue encontrar um vizinho mais próximo na camada atual, ele desce para a camada inferior e continua o processo de busca, refinando a sua localização.
- Isso continua até chegar à camada inferior (camada 0), onde a busca final encontra os vizinhos mais próximos.
Essa abordagem hierárquica permite atravessar rapidamente o espaço vetorial nas camadas superiores e, em seguida, fazer uma busca precisa e detalhada nas camadas inferiores.
O vídeo a seguir oferece uma excelente explicação visual e conceitual desses algoritmos de indexação.
Understanding How Vector Databases Work!
Para aprofundar nos mecanismos de indexação, vamos voltar ao vídeo 'Understanding How Vector Databases Work!'. Ele explica de forma clara os conceitos por trás das técnicas de quantização (relacionadas ao IVF) e do HNSW.
Assista aos seguintes trechos: A Necessidade de Indexar (04:08 - 04:49): Reforça por que a busca linear é inviável. Product Quantization (04:49 - 06:37): Explica uma técnica de compressão e clusterização relacionada ao IVF, focando na ideia de aproximar vetores para acelerar a busca. Navigable Small World e HNSW (08:02 - 11:45): Foca na explicação do HNSW. Tente visualizar a estrutura de grafo em camadas e como a busca se move do geral (camadas superiores) para o específico (camadas inferiores).
4. Vector Index vs. Vector Database
É importante fazer uma distinção que será crucial para você como desenvolvedor.
- Uma biblioteca de índice de vetores (como FAISS da Meta) é uma ferramenta que implementa os algoritmos ANN (como IVF e HNSW). É um componente de baixo nível.
- Um banco de dados de vetores (como Pinecone, Weaviate, Milvus, Chroma, etc.) é um sistema completo, construído em torno de um motor de indexação. Ele oferece funcionalidades de um banco de dados de produção que vão muito além da simples busca.
Para um engenheiro de software construindo um sistema robusto, usar um banco de dados de vetores é quase sempre a escolha certa. O artigo a seguir, da Pinecone (um popular banco de dados de vetores), detalha essas diferenças.
What is a Vector Database & How Does it Work?
O artigo 'What is a Vector Database & How Does it Work?' detalha as funcionalidades que diferenciam um banco de dados de vetores de uma simples biblioteca de indexação, tornando-o uma ferramenta pronta para produção.
Leia as seções 'What’s the difference between a vector index and a vector database?' e 'Database Operations'. Preste atenção especial aos seguintes pontos, que são cruciais para aplicações do mundo real: Gerenciamento de dados (CRUD): A capacidade de inserir, atualizar e deletar vetores. Armazenamento e filtragem de metadados: Essencial para o seu projeto. Isso permite consultas híbridas como "encontre documentos sobre autenticação [busca semântica] onde o projeto é 'backend' [filtro de metadados]". Escalabilidade, Backups, Segurança e APIs/SDKs.
5. O Vector Store no Ecossistema RAG
Agora podemos ver claramente onde o vector store se encaixa no pipeline do RAG que estamos construindo.
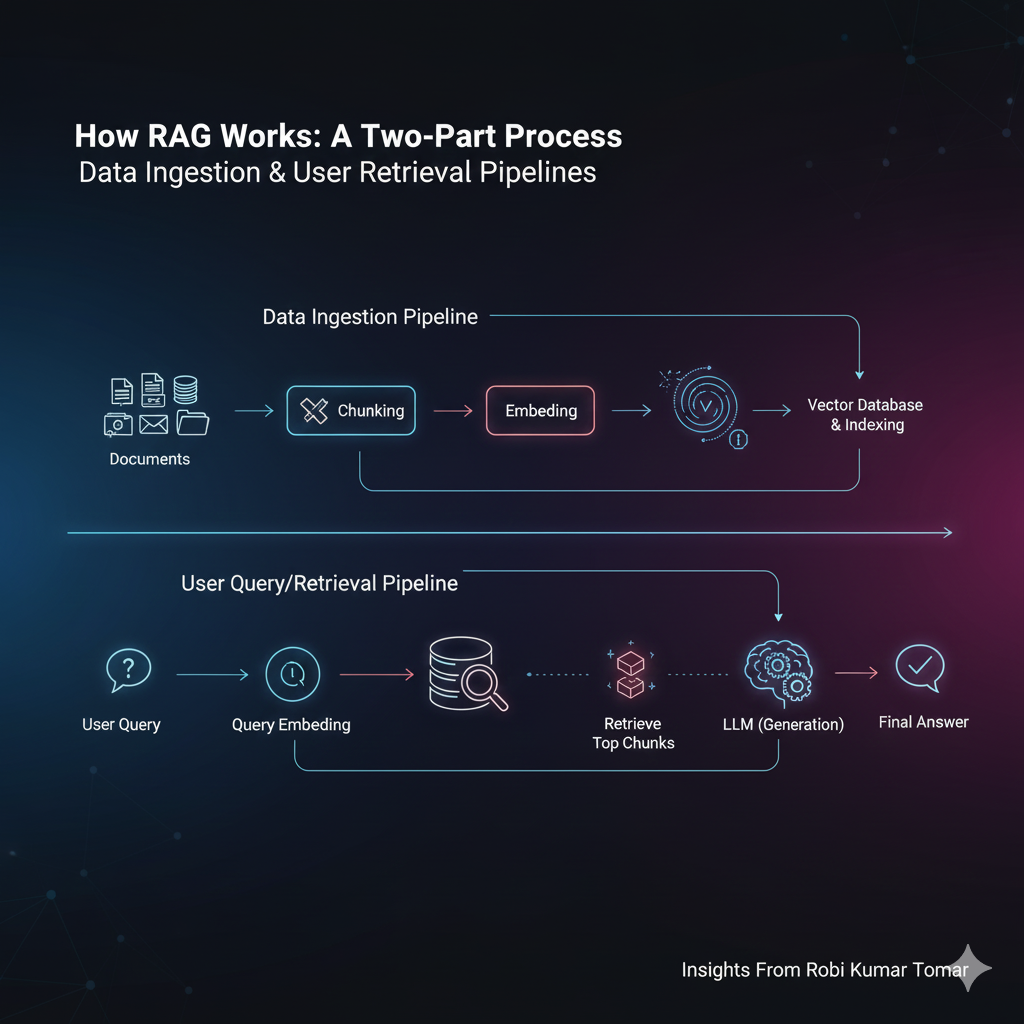
O processo para o seu agente seria:
-
Ingestão de Dados (offline):
- Ler todos os documentos de regras de negócio do Google Drive e os guias de arquitetura dos repositórios Git.
- Dividir esses documentos em
chunks(pedaços menores). (Vamos cobrir isso na próxima lição!) - Para cada
chunk, gerar umembeddingusando um modelo de embedding. - Armazenar cada
embeddinge seusmetadados(ex: origem do arquivo, nome do projeto) no vector store. O vector store irá indexá-los automaticamente.
-
Recuperação (em tempo real):
- O agente lê uma nova tarefa no Jira (ex: "Adicionar login social com Google ao app mobile").
- Gera um
embeddingpara a descrição da tarefa. - Executa uma busca ANN no vector store com este embedding de consulta.
- O vector store retorna os k chunks mais relevantes (ex: trechos de documentos sobre "autenticação Flutter", "OAuth 2.0" e "API de usuários").
- Esses chunks recuperados são inseridos no prompt do LLM para gerar o código.
Conclusão
Nesta lição, desmistificamos como a busca por similaridade em milhões de documentos pode ser feita em milissegundos. Vimos que a força bruta é inviável e que a solução reside nos vector stores, que utilizam algoritmos de Approximate Nearest Neighbor (ANN) para acelerar drasticamente a busca.
Principais Pontos:
- Vector stores são bancos de dados especializados para armazenar e consultar eficientemente embeddings de vetores.
- Eles superam a busca por força bruta usando índices de vetores baseados em algoritmos ANN, como IVF (baseado em cluster) e HNSW (baseado em grafo).
- A busca ANN troca uma precisão mínima por um ganho massivo de velocidade, o que é ideal para RAG.
- Um banco de dados de vetores completo oferece funcionalidades essenciais para produção, como operações CRUD, filtragem por metadados, escalabilidade e segurança, que uma simples biblioteca de indexação não possui.
Na Próxima Lição:
Agora que entendemos como armazenar e recuperar os vetores, precisamos dar um passo atrás e abordar uma questão fundamental no processo de ingestão: como preparamos nossos dados? Se um documento de regras de negócio tem 50 páginas, não podemos simplesmente gerar um único embedding para ele todo — perderíamos toda a granularidade. Precisamos dividi-lo em pedaços significativos. A próxima lição, "Aplicar várias estratégias de chunking para segmentar documentos longos de forma eficaz para RAG", abordará exatamente isso.