Bonjour ! Dans la leçon précédente, vous avez appris à effectuer diverses opérations mathématiques sur les tenseurs PyTorch, qui sont les calculs fondamentaux au cœur des réseaux de neurones. Nous avons vu que chaque opération que vous effectuez, comme une multiplication matricielle ou une addition, fait partie d'une chaîne de calcul.
Aujourd'hui, nous allons découvrir l'une des fonctionnalités les plus puissantes de PyTorch : autograd, son moteur de différentiation automatique. L'objectif de cette leçon est de vous apprendre à utiliser la fonctionnalité autograd de PyTorch pour calculer automatiquement les gradients. Vous comprendrez comment PyTorch enregistre vos opérations pour construire un graphe de calcul dynamique, et comment il utilise ce graphe pour calculer les dérivées nécessaires à l'apprentissage de n'importe quel modèle de deep learning. C'est le mécanisme qui alimente l'algorithme de descente de gradient que vous avez déjà rencontré dans le contexte du machine learning classique.
1. Pourquoi avons-nous besoin de la différentiation automatique ?
Rappelez-vous du module 7 : l'entraînement d'un modèle de machine learning consiste à ajuster ses paramètres (ou "poids") pour minimiser une fonction de perte (loss function). La manière la plus efficace de savoir dans quelle direction ajuster ces poids est de calculer le gradient de la fonction de perte par rapport à chaque paramètre. Ce gradient nous indique la direction de la plus forte pente, et en allant dans la direction opposée (descente de gradient), nous nous rapprochons du minimum de la perte.
Pour des modèles simples, on pourrait calculer ces dérivées à la main. Mais pour les réseaux de neurones profonds, qui peuvent contenir des millions de paramètres et des dizaines de fonctions imbriquées, cette tâche devient humainement impossible. C'est là que la différentiation automatique entre en jeu.
La vidéo suivante explique très clairement le concept de la différentiation automatique (autodiff) et pourquoi elle est si bien adaptée au deep learning, en la comparant à d'autres méthodes.
What is Automatic Differentiation?
Cette vidéo offre une excellente intuition conceptuelle sur la différentiation automatique.
Concentrez-vous sur les parties suivantes : Introduction : Pourquoi les dérivées sont essentielles pour l'optimisation. Comparaison des méthodes : Une présentation des alternatives (manuelle, numérique, symbolique) et de leurs limites. Cela vous aidera à apprécier la puissance d'autodiff. Reverse Mode Autodiff : C'est la méthode utilisée par PyTorch. Notez bien la mention que l'algorithme de rétropropagation (backpropagation) est un cas particulier du mode reverse. C'est le point de connexion fondamental avec l'entraînement des réseaux de neurones.
Comme vous l'avez vu, le mode "reverse" est incroyablement efficace lorsque nous avons de nombreux paramètres (entrées) et une seule sortie à optimiser (la perte), ce qui est exactement le cas en deep learning.
2. Comment fonctionne autograd : le graphe de calcul
PyTorch implémente la différentiation automatique via son module autograd. Lorsque vous effectuez des opérations sur des tenseurs pour lesquels le suivi des gradients est activé, PyTorch construit un graphe de calcul dynamique. Ce graphe est un enregistrement de toutes les opérations effectuées.
Pour qu'un tenseur soit inclus dans ce graphe, son attribut requires_grad doit être défini sur True.
import torch


# Par défaut, requires_grad est False
x = torch.tensor([2.0, 3.0])
print(x.requires_grad)  # Output: False


# Activons le suivi
w = torch.tensor([5.0, 1.0], requires_grad=True)
print(w.requires_grad)  # Output: True
Chaque fois que vous effectuez une opération avec un tenseur qui requiert un gradient, le tenseur résultant aura un attribut grad_fn. Cet attribut fait référence à une fonction qui a créé le tenseur et contient un lien vers les tenseurs d'entrée. C'est ainsi que PyTorch construit le graphe, en chaînant les grad_fn les uns aux autres.

L'article officiel de PyTorch ci-dessous explique très bien cette mécanique.
Ce document est la référence sur autograd. Il explique à la fois la théorie et la pratique.
Commencez par lire les deux premières sections : What Do We Need Autograd For? : Cette section récapitule la connexion entre la règle de la chaîne (chain rule) du calcul différentiel et la nécessité d'autograd pour calculer les gradients à travers un réseau. A Simple Example : Suivez cet exemple pas à pas. Il vous montre comment requires_grad=True active le suivi et comment le grad_fn est créé et chaîné.
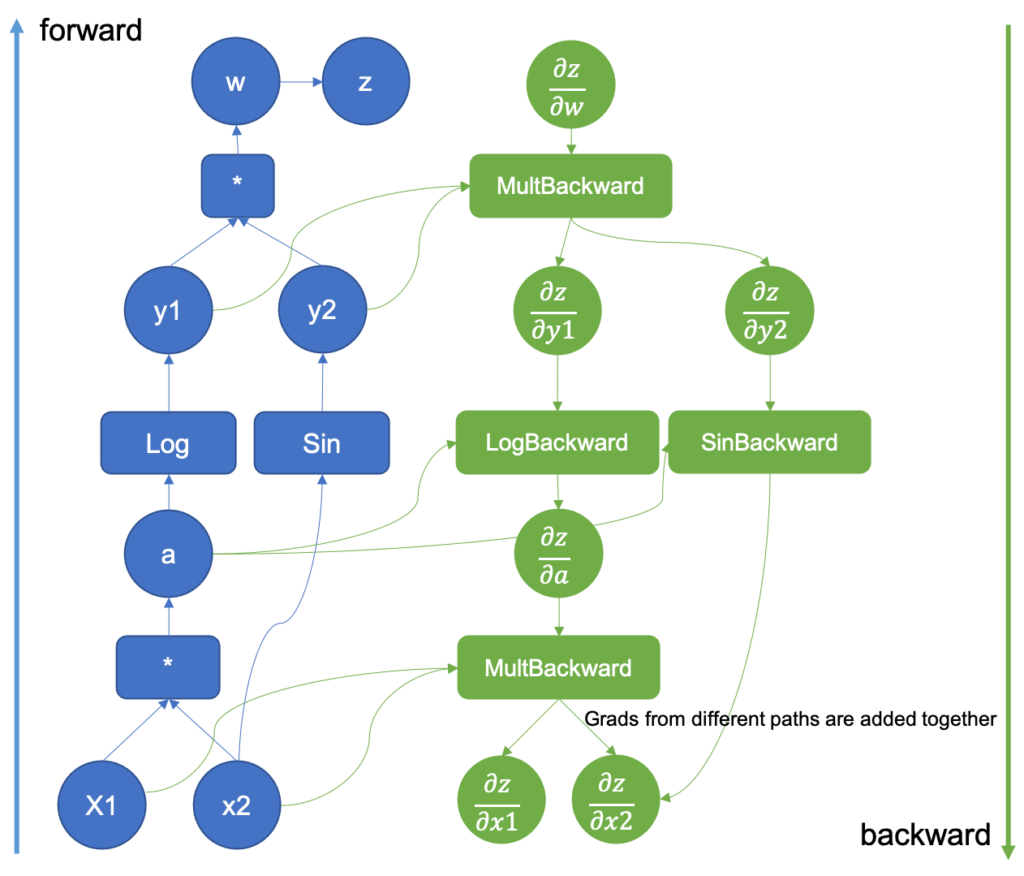
Le processus se déroule en deux temps, comme illustré ci-dessous :
- Forward pass (passe avant) : Vous exécutez vos opérations pour calculer la sortie (par exemple, la perte). PyTorch construit le graphe de calcul en même temps.
- Backward pass (passe arrière) : Vous appelez la méthode
.backward()sur le tenseur de sortie (qui doit être un scalaire, comme la perte). PyTorch parcourt le graphe à l'envers, de la sortie vers les entrées, et calcule les gradients en utilisant la règle de la chaîne.
3. Utilisation pratique d'autograd
La meilleure façon de comprendre est de le faire soi-même. La vidéo suivante de Patrick Loeber est un excellent tutoriel pratique qui vous guidera à travers les étapes essentielles.
PyTorch Tutorial 03 - Gradient Calculation With Autograd
Ce tutoriel est un guide pas à pas très clair pour utiliser autograd.
Suivez les étapes présentées dans la vidéo : Activer les gradients : Voyez comment créer un tenseur avec requires_grad=True. Le graphe de calcul : Observez comment les opérations créent des tenseurs avec un attribut grad_fn. Calculer les gradients : Apprenez à appeler .backward() sur la sortie et à inspecter les gradients stockés dans l'attribut .grad du tenseur d'entrée. Notez la distinction importante faite à partir de l'appel à .backward() : la méthode .backward() est généralement appelée sur un tenseur scalaire (un seul élément), ce qui est le cas pour une fonction de perte.
Voici un résumé en code de ce que vous avez vu :
# Tenseur d'entrée (par exemple, les poids d'un modèle)
w = torch.tensor([2.0], requires_grad=True)


# Simuler une passe avant
x = torch.tensor([3.0])
y = w * x  # y = 6.0
loss = (y - 5.0)**2  # loss = (6-5)^2 = 1.0


# `loss` est le résultat d'une chaîne d'opérations
# loss = ((w * x) - 5.0)^2
print(loss.grad_fn)  # <PowBackward0 object at ...>


# Passe arrière : Calculer les gradients
loss.backward()


# Inspecter le gradient
# d(loss)/dw = 2 * (y - 5.0) * d(y)/dw
# d(y)/dw = x = 3.0
# d(loss)/dw = 2 * (6.0 - 5.0) * 3.0 = 6.0
print(w.grad)  # tensor([6.])
4. L'importance de la remise à zéro des gradients
C'est l'une des erreurs les plus courantes pour les débutants. Par défaut, PyTorch accumule les gradients chaque fois que vous appelez .backward(). Cela signifie que les nouveaux gradients calculés sont ajoutés aux gradients déjà existants dans l'attribut .grad.
C'est utile dans certains scénarios avancés, mais pour un cycle d'entraînement standard, vous devez remettre les gradients à zéro avant chaque nouvelle itération. Sinon, les gradients de plusieurs passes s'additionneraient, conduisant à des mises à jour de poids incorrectes.
PyTorch Tutorial 03 - Gradient Calculation With Autograd
Cette partie de la vidéo est cruciale pour une mise en œuvre correcte.
Regardez attentivement la section qui explique l'accumulation des gradients. L'exemple de la boucle for montre clairement comment les gradients s'additionnent si vous ne les remettez pas à zéro.
Dans une boucle d'entraînement typique, vous verrez ce schéma :
# Supposons que `optimizer` est un objet qui gère la mise à jour des poids
# (nous verrons cela en détail plus tard)


# for epoch in range(num_epochs):
#   ...
#   loss = ...
#   loss.backward()  # Calcule les gradients pour l'itération actuelle
#   optimizer.step() # Met à jour les poids en utilisant les gradients
#   optimizer.zero_grad() # REMET LES GRADIENTS À ZÉRO pour la prochaine itération
5. Désactiver le suivi des gradients
Il y a des moments où vous ne voulez PAS que PyTorch suive les opérations, principalement pour deux raisons :
- Inférence (Évaluation du modèle) : Lorsque vous utilisez un modèle entraîné pour faire des prédictions, vous n'avez pas besoin des gradients. Désactiver leur calcul rend le processus plus rapide et moins gourmand en mémoire.
- Mise à jour des poids : L'étape de mise à jour des poids elle-même (
poids_nouveau = poids_ancien - learning_rate * gradient) ne doit pas être suivie parautograd.
PyTorch offre plusieurs façons de désactiver le suivi des gradients.
Cette section de la documentation officielle détaille les méthodes pour contrôler autograd.
Lisez la section Turning Autograd Off and On. Elle présente les trois principales approches.
Voici un résumé des méthodes les plus courantes :
-
with torch.no_grad():
C'est la méthode la plus utilisée. C'est un gestionnaire de contexte qui désactive le calcul des gradients pour tout le bloc de code qu'il contient. Idéal pour une boucle d'évaluation.print(w.requires_grad) # True with torch.no_grad(): y = w * 2 print(y.requires_grad) # False print(w.requires_grad) # True (le paramètre original n'est pas affecté) -
.detach()
Cette méthode crée une copie d'un tenseur qui est "détachée" du graphe de calcul. Le nouveau tenseur a les mêmes données mais ne requiert plus de gradient. C'est utile si vous voulez utiliser un tenseur pour un calcul non lié au graphe, comme le convertir en NumPy pour le tracer avec Matplotlib.y = w * 3 print(y.requires_grad) # True y_detached = y.detach() print(y_detached.requires_grad) # False
Conclusion
Vous avez maintenant exploré le moteur d'apprentissage de PyTorch. autograd est ce qui permet aux modèles de s'améliorer itérativement en se basant sur leurs erreurs, en automatisant le processus complexe du calcul de gradients.
Points clés à retenir :
autogradest le moteur de différentiation automatique de PyTorch.- Il fonctionne en construisant un graphe de calcul dynamique qui enregistre toutes les opérations.
- L'attribut
requires_grad=Trueindique à PyTorch de suivre les opérations sur un tenseur. - La méthode
.backward()est appelée sur une perte scalaire pour calculer les gradients à travers le graphe. - Les gradients calculés sont stockés dans l'attribut
.graddes tenseurs feuilles (ceux que vous avez créés avecrequires_grad=True). - Il est essentiel de remettre les gradients à zéro (par ex.
optimizer.zero_grad()) après chaque étape d'optimisation pour éviter l'accumulation. - Utilisez
with torch.no_grad():pour désactiver le suivi des gradients pendant l'inférence afin d'améliorer les performances.
Dans la prochaine leçon, nous allons assembler ces concepts. Nous définirons la structure d'un neurone artificiel, l'unité de base d'un réseau de neurones, et verrons le rôle de ses poids et de son biais. Vous comprendrez enfin comment les gradients que vous venez d'apprendre à calculer sont utilisés pour ajuster ces poids et biais.