Bonjour ! Dans les leçons précédentes, nous avons exploré les composants fondamentaux d'un réseau de neurones : les neurones eux-mêmes, avec leurs poids et biais, et les fonctions d'activation qui introduisent la non-linéarité essentielle. Nous avons également acquis les outils de programmation nécessaires en Python, notamment les classes et l'héritage. Il est temps d'assembler toutes ces pièces.
L'objectif de cette leçon est de vous apprendre à construire un modèle de réseau de neurones simple en créant une classe qui hérite de torch.nn.Module. C'est la méthode standard et professionnelle pour créer des modèles de toute complexité dans PyTorch. En maîtrisant cette structure, vous disposerez du plan de base pour construire n'importe quelle architecture de deep learning, de la plus simple à la plus avancée.
1. torch.nn.Module : Le plan de tout modèle PyTorch
En PyTorch, chaque modèle de réseau de neurones, qu'il s'agisse d'une simple couche ou d'un réseau complexe de plusieurs millions de paramètres, est une classe Python. Plus précisément, c'est une classe qui hérite de la classe de base torch.nn.Module.
Pourquoi l'héritage est-il si important ici ? En héritant de nn.Module, notre classe de modèle personnalisée reçoit gratuitement une quantité énorme de fonctionnalités. nn.Module s'occupe de tâches complexes en coulisses, comme le suivi de tous les poids et biais de notre réseau, la mise à zéro de leurs gradients, et bien plus encore. Pensez à nn.Module comme le châssis et le moteur d'une voiture de course : PyTorch nous les fournit, et nous nous concentrons sur la conception de la carrosserie et l'agencement intérieur (nos couches et la manière dont elles sont connectées).
La vidéo suivante explique très bien ce concept fondamental.
Build PyTorch CNN - Object Oriented Neural Networks
Cette vidéo explique comment la programmation orientée objet est au cœur de la construction de modèles dans PyTorch.
Regardez la section POO dans PyTorch. L'orateur explique que les couches et les réseaux sont tous deux représentés par des classes qui héritent (qui "étendent") la classe nn.Module. C'est le concept clé qui justifie l'approche que nous apprenons aujourd'hui.
2. Les deux méthodes essentielles : __init__ et forward
Pour construire un modèle personnalisé qui hérite de nn.Module, nous devons implémenter deux méthodes spéciales. C'est un patron de conception que vous retrouverez dans absolument tous les modèles PyTorch.
-
__init__(self)(le constructeur) : C'est ici que nous définissons les briques de notre réseau. On y déclare toutes les couches que le réseau utilisera (couches linéaires, couches de convolution, fonctions d'activation, etc.). Cette méthode est exécutée une seule fois, lors de la création de l'objet modèle. C'est l'étape de "planification". -
forward(self, x)(la passe avant) : C'est ici que nous définissons le flux des données. On y décrit comment une donnée d'entréextraverse les différentes couches définies dans__init__. C'est le "calcul" ou la "logique" du modèle. Cette méthode est appelée chaque fois que nous passons des données au modèle pour obtenir une prédiction.
Le point le plus important ? Nous n'avons besoin de définir que la passe avant. Grâce au mécanisme d'autograd de PyTorch que nous avons vu précédemment, PyTorch est capable de calculer automatiquement la passe arrière (backward pass) pour la descente de gradient, à partir de la définition de notre forward.
Cette vidéo résume parfaitement ces étapes.
Build PyTorch CNN - Object Oriented Neural Networks
Cette section résume les trois étapes clés pour créer n'importe quel réseau dans PyTorch.
Regardez attentivement ce court résumé des trois étapes clés. Mémorisez-les : 1) Créer une classe qui hérite de nn.Module. 2) Définir les couches dans le constructeur __init__. 3) Définir le calcul dans la méthode forward.
3. Anatomie d'un modèle PyTorch
Voyons comment ces deux méthodes s'articulent dans un exemple concret. L'image ci-dessous décompose un modèle de régression linéaire simple. C'est la forme la plus basique d'un réseau de neurones.
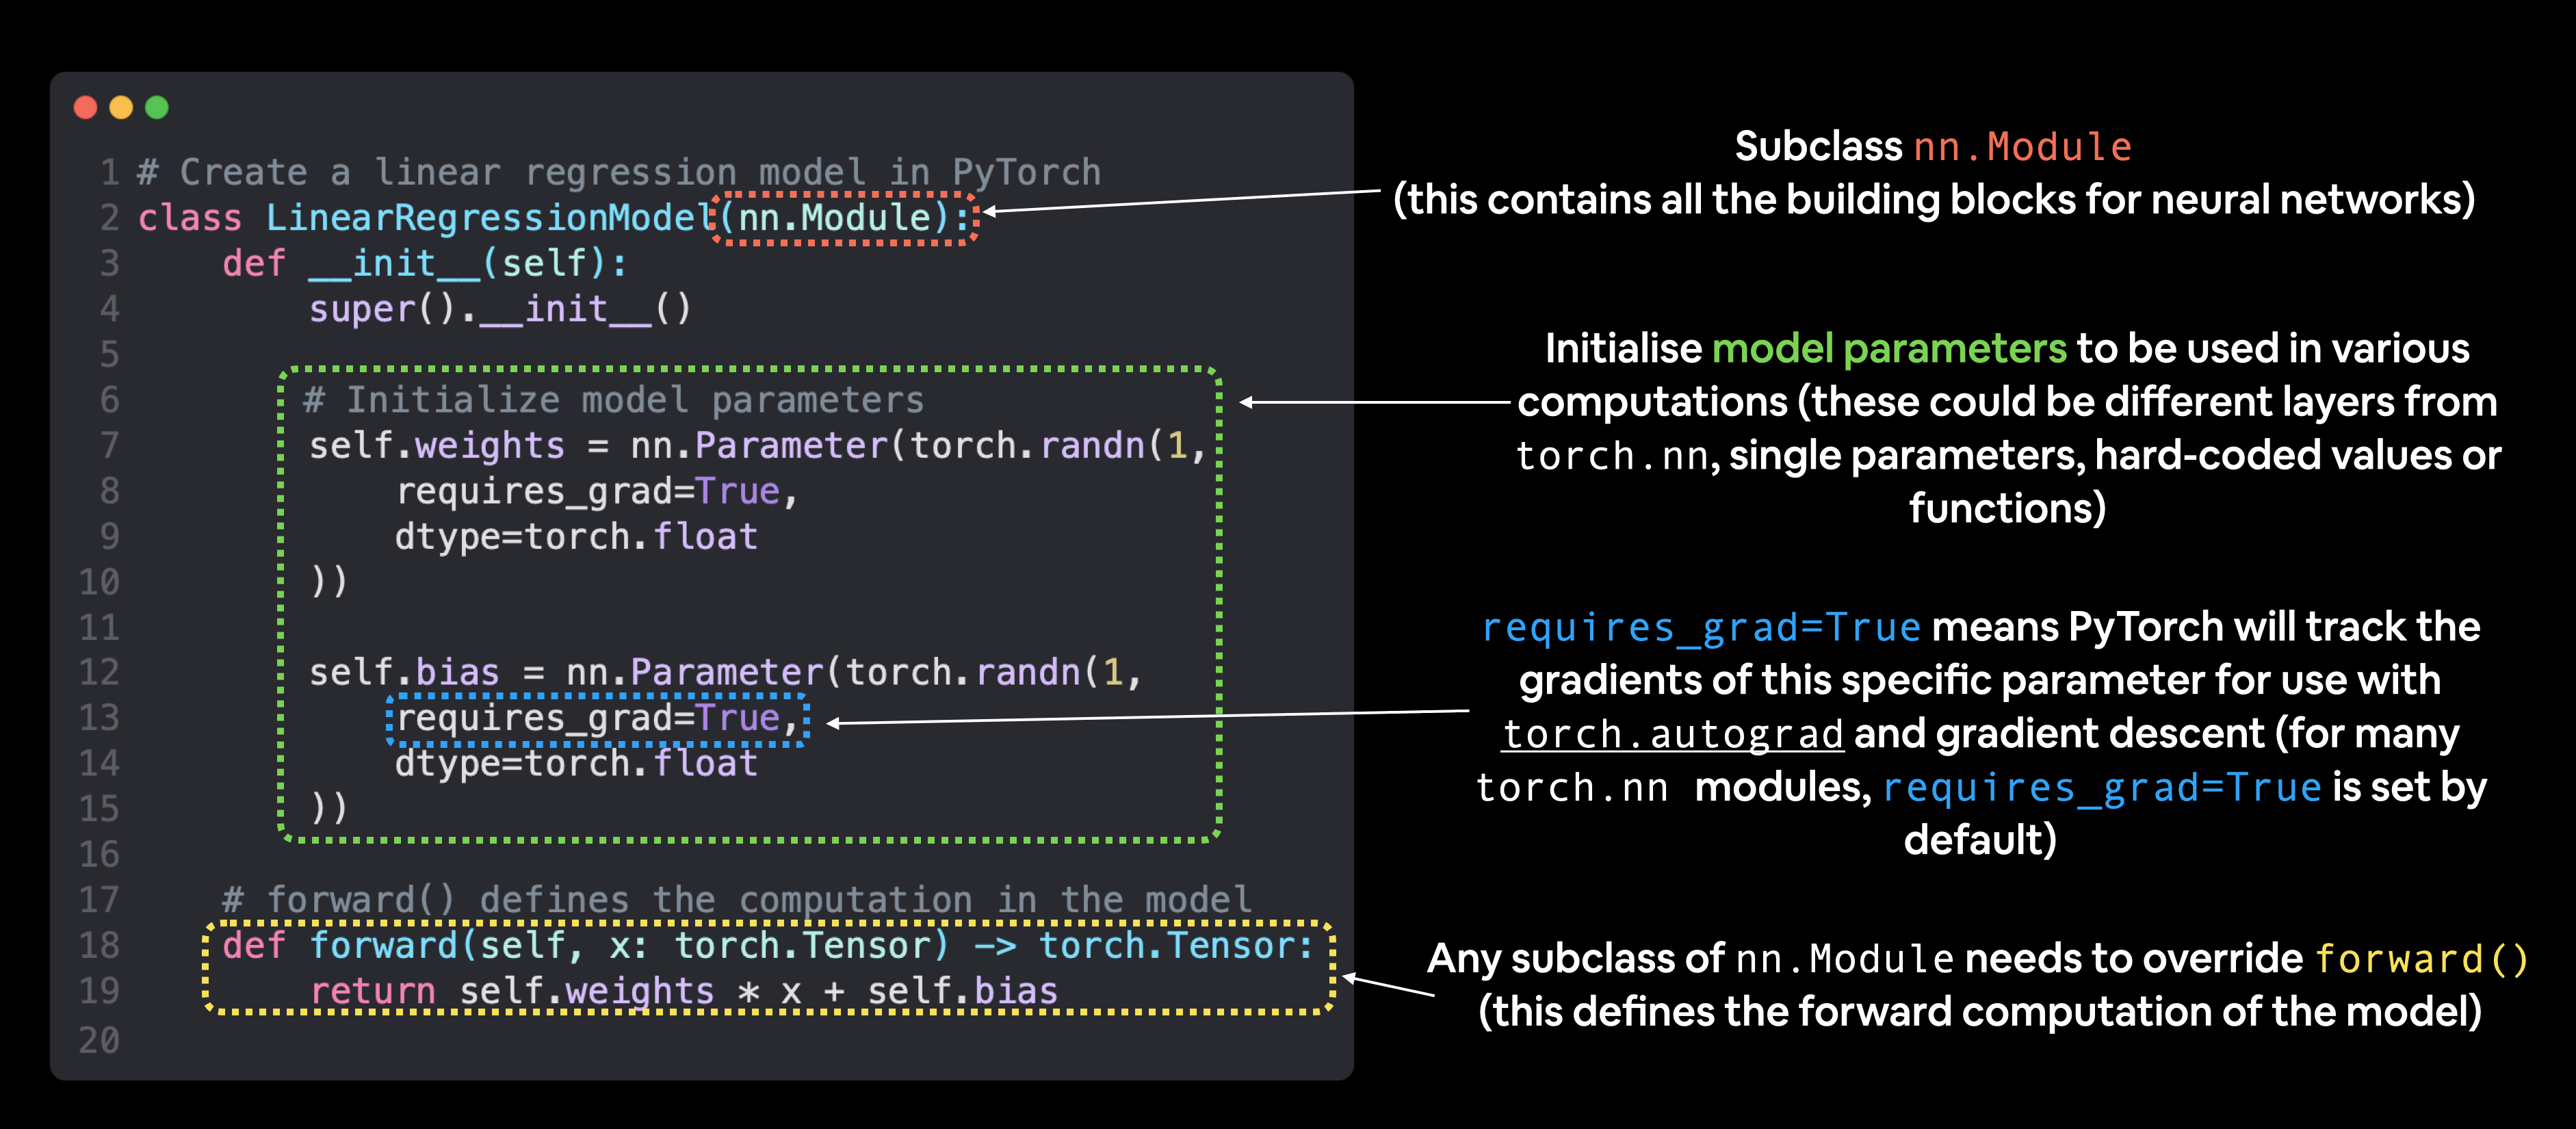
Analysons ce code, car il contient tous les éléments fondamentaux :
-
Ligne 2 :
class LinearRegressionModel(nn.Module):
C'est la déclaration de notre classe. Elle hérite denn.Module, ce qui lui donne accès à toutes les fonctionnalités de PyTorch. -
Ligne 3-4 :
def __init__(self):etsuper().__init__()
C'est le constructeur. La lignesuper().__init__()est obligatoire. Elle appelle le constructeur de la classe parente (nn.Module) pour s'assurer que tout est initialisé correctement en coulisses. -
Lignes 7-15 :
self.weights = nn.Parameter(...)etself.bias = nn.Parameter(...)
Ici, nous définissons les paramètres apprenables du modèle.nn.Parameterest un type de tenseur spécial qui signale à PyTorch que ces valeurs doivent être optimisées pendant l'entraînement. L'argumentrequires_grad=Trueactive le calcul automatique du gradient pour ces paramètres.Note : Pour des couches plus complexes comme
nn.Linear, PyTorch crée ces paramètres pour nous. Mais il est utile de voir comment cela se fait manuellement au moins une fois. -
Ligne 18 :
def forward(self, x: torch.Tensor) -> torch.Tensor:
C'est la définition de la passe avant. Elle prend une entréex(un tenseur) et doit retourner une sortie (un autre tenseur). -
Ligne 19 :
return self.weights * x + self.bias
C'est le calcul effectif. On applique la formule de la régression linéaire, , en utilisant les paramètres que nous avons définis dans__init__.
4. Construire un réseau de neurones multicouches
Maintenant, généralisons cette structure pour construire un réseau de neurones plus standard, avec des couches cachées. Au lieu de définir les poids et les biais manuellement, nous utiliserons la couche nn.Linear de PyTorch, qui encapsule cette logique pour nous.
L'article suivant, en français, est une excellente ressource qui montre exactement comment faire cela.
Construire des réseaux de neurones avec nn.Module en PyTorch
Cet article en français résume parfaitement la structure d'un modèle PyTorch et vous servira de référence principale pour cette leçon.
Lisez la première partie de l'article, en vous concentrant sur la section Structure de base d’un modèle. Analysez l'exemple de la classe SimpleNet. Remarquez comment les couches nn.Linear et la fonction d'activation nn.ReLU sont d'abord définies comme des attributs dans __init__, puis utilisées dans forward pour traiter les données séquentiellement.
Comme vous l'avez vu dans l'article, le processus est très similaire :
-
Dans
__init__, nous initialisons les couches dont nous avons besoin. Par exemple :self.fc1 = nn.Linear(input_size, hidden_size) # fc = fully connected self.relu = nn.ReLU() self.fc2 = nn.Linear(hidden_size, output_size) -
Dans
forward, nous les enchaînons pour définir le calcul :x = self.fc1(x) x = self.relu(x) x = self.fc2(x) return x
La vidéo suivante détaille un processus presque identique, en utilisant nn.Sequential pour regrouper les couches, ce qui est une autre technique courante.
Dive into Deep Learning – Lec 6: Basics of Object-Oriented Programming in PyTorch (torch.nn.Module)
Cette vidéo montre la construction d'un réseau de neurones avec nn.Module de manière très détaillée, en partant des principes de la programmation orientée objet.
Regardez ces deux segments clés : Définir la classe du réseau : Observez comment le présentateur définit une classe NeuralNetwork qui hérite de nn.Module. Portez une attention particulière à la méthode __init__ où il définit les couches et à la méthode forward où il définit le flux des données. Notez sa remarque très importante : vous n'avez pas besoin de définir la passe arrière (backward), PyTorch s'en charge ! Instancier et inspecter le modèle : Cette partie montre comment créer un objet (une "instance") à partir de la classe et utiliser print() pour voir son architecture.
5. Utiliser le modèle
Une fois notre classe de modèle définie, l'utiliser est très simple :
-
Instanciation : On crée un objet à partir de notre classe.
# Les tailles sont des exemples model = SimpleNet(input_size=784, hidden_size=128, output_size=10) -
Inspection : On peut l'imprimer pour vérifier son architecture.
print(model)PyTorch nous donnera une belle représentation de toutes les couches que nous avons définies.
-
Prédiction : On lui passe un tenseur d'entrée. Cela appelle automatiquement la méthode
forward.input_tensor = torch.randn(64, 784) # Un batch de 64 exemples logits = model(input_tensor) # Appelle model.forward(input_tensor) print(logits.shape)
Conclusion
Aujourd'hui, nous avons franchi une étape décisive. Nous avons appris à structurer un réseau de neurones complet dans PyTorch en utilisant son outil le plus fondamental : la classe nn.Module.
Points clés à retenir :
- Tout modèle PyTorch est une classe Python qui hérite de
torch.nn.Module. - Cette classe doit implémenter deux méthodes essentielles :
__init__(self): pour définir les couches du réseau (les briques). N'oubliez pas l'appelsuper().__init__().forward(self, x): pour décrire le flux des données à travers ces couches (le calcul).
- PyTorch gère automatiquement la passe arrière (
backward pass) pour l'entraînement, grâce àautograd. - Une fois la classe définie, on crée une instance du modèle, que l'on peut ensuite utiliser pour faire des prédictions.
Maintenant que nous savons comment construire l'architecture d'un modèle, la question suivante est : comment l'entraîner ? Dans la prochaine leçon, nous entamerons un nouveau module sur l'entraînement des réseaux de neurones. Nous commencerons par la toute première étape : préparer nos données pour l'entraînement à l'aide des classes TensorDataset et DataLoader de PyTorch.