Bonjour ! Dans la leçon précédente, nous avons vu comment la régularisation (Ridge et Lasso) nous aide à contrôler la complexité de nos modèles de régression pour éviter le surapprentissage. Jusqu'à présent, notre objectif a toujours été de prédire une valeur continue, comme un prix ou une température. Il est maintenant temps de nous tourner vers un autre type de problème fondamental en apprentissage automatique : la classification.
Dans cette leçon, vous apprendrez à entraîner un classifieur par régression logistique pour des tâches de classification binaire. L'objectif est de prédire une catégorie discrète, comme "oui" ou "non", "spam" ou "non spam", ou "malin" ou "bénin". Bien que le mot "régression" figure dans son nom, la régression logistique est l'un des algorithmes de classification les plus fondamentaux et les plus utilisés. Comprendre son fonctionnement vous fournira une base solide pour aborder des classifieurs plus complexes plus tard.
1. Du Linéaire à la Probabilité : Pourquoi un Nouveau Modèle ?
Imaginons que nous voulions prédire si une tumeur est maligne (classe 1) ou bénigne (classe 0) en fonction de sa taille. Si nous essayions d'utiliser le modèle de régression linéaire que nous connaissons bien, nous nous heurterions à plusieurs problèmes.
Regardez le graphique suivant. La ligne bleue représente un modèle de régression linéaire ajusté à des données de classification binaire.
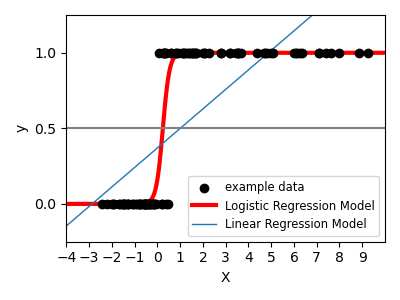
Comme vous pouvez le voir, le modèle linéaire produit des prédictions qui peuvent être supérieures à 1 ou inférieures à 0. Que signifierait une prédiction de 1.5 ou de -0.2 ? Cela n'a pas de sens si nous voulons interpréter la sortie comme une probabilité. De plus, la ligne est très sensible aux points de données extrêmes (outliers), ce qui peut déplacer le seuil de décision de manière erratique.
La vidéo suivante illustre très bien pourquoi la régression linéaire n'est pas adaptée à la classification.
Machine Learning Tutorial Python - 8: Logistic Regression (Binary Classification)
Le présentateur de la chaîne codebasics explique visuellement les limites de la régression linéaire pour un problème de classification.
Regardez la section qui montre le problème qui se pose lorsqu'on essaie d'appliquer la régression linéaire à des données où la sortie est soit 0, soit 1.
Nous avons besoin d'une fonction qui transforme la sortie de notre modèle linéaire en une valeur comprise entre 0 et 1, que nous pourrons alors interpréter comme une probabilité.
2. La Fonction Sigmoïde : Le Cœur de la Régression Logistique
La solution à notre problème est d'utiliser une fonction spéciale appelée fonction sigmoïde (ou fonction logistique). Sa formule mathématique est :
Où est la base du logarithme naturel (environ 2.718). Cette fonction prend n'importe quel nombre réel en entrée et le "compresse" dans un intervalle [0, 1].
Andrew Ng, dans sa spécialisation en Machine Learning, offre une explication très claire de cette fonction et de son rôle.
#32 Machine Learning Specialization [Course 1, Week 3, Lesson 1]
Cette vidéo de DeepLearningAI explique le concept de la fonction sigmoïde et comment elle est intégrée dans le modèle de régression logistique.
D'abord, regardez l'explication de la fonction sigmoïde elle-même. Notez sa forme en "S" et comment elle mappe n'importe quelle entrée à une sortie entre 0 et 1. Ensuite, voyez comment cette fonction est combinée avec un modèle linéaire pour former le modèle de régression logistique complet.
L'idée est simple mais puissante. Nous prenons la sortie de notre modèle linéaire habituel, que nous appellerons :
Puis nous appliquons la fonction sigmoïde à pour obtenir notre prédiction finale, :
Cette sortie, , est maintenant un nombre entre 0 et 1, que nous pouvons interpréter comme la probabilité que la classe soit 1 étant donné les entrées . Autrement dit : .
3. De la Probabilité à la Décision
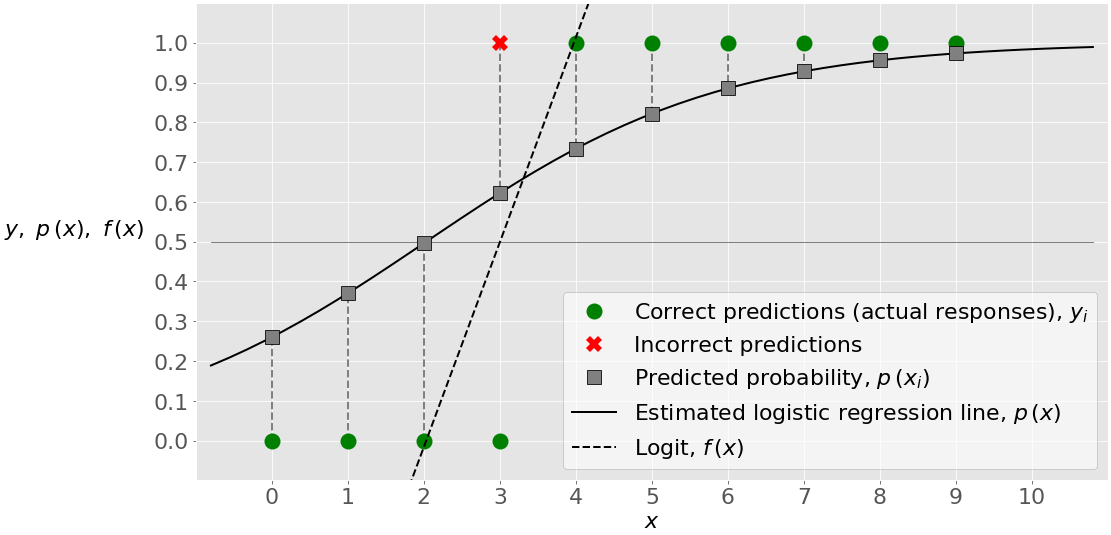
Maintenant que notre modèle produit une probabilité, comment décidons-nous de la classe finale ? Nous utilisons un seuil de décision. Par défaut, ce seuil est fixé à 0.5.
- Si , nous prédisons la classe 1.
- Si , nous prédisons la classe 0.
Comme la fonction sigmoïde est égale à 0.5 lorsque son entrée , ce seuil correspond directement à la ligne (ou à l'hyperplan dans des dimensions supérieures) où . Cette ligne est appelée la frontière de décision.
L'image ci-dessous illustre ce processus. La courbe en S est la probabilité prédite. Pour un point donné sur l'axe des x, nous projetons vers le haut jusqu'à la courbe pour obtenir la probabilité, puis nous la comparons au seuil de 0.5 pour faire une prédiction.
Pour en savoir plus sur les fondements mathématiques, y compris la fonction de coût, je vous encourage à lire la première partie de cet article.
Mastering Logistic Regression with Scikit-Learn
Cet article de DigitalOcean offre un excellent résumé des mathématiques derrière la régression logistique.
Lisez la section Mathematical Foundation. Concentrez-vous sur les sous-sections "The Sigmoid Function" pour revoir ce que nous venons de discuter, et "Cost Function (Log Loss)" pour comprendre comment le modèle est entraîné. Le Log Loss pénalise le modèle pour les prédictions incorrectes et confiantes, le forçant à apprendre les bons paramètres w et b.
4. Mise en Pratique avec Scikit-learn
Passons maintenant à l'implémentation. Grâce à Scikit-learn, l'entraînement d'un modèle de régression logistique est très similaire à ce que nous avons fait pour la régression linéaire. Nous allons suivre un flux de travail standard en utilisant le jeu de données "Breast Cancer Wisconsin", qui est directement intégré à Scikit-learn.
L'article de DigitalOcean propose un exemple de code complet et clair.
Mastering Logistic Regression with Scikit-Learn
Cette section vous guide à travers un exemple pratique complet.
Lisez et étudiez le code dans la section Binary Classification Example. Faites attention aux étapes suivantes : Chargement des données (load_breast_cancer). Séparation des données en ensembles d'entraînement et de test (train_test_split). Initialisation du modèle LogisticRegression. Entraînement du modèle avec la méthode .fit(). Réalisation de prédictions avec .predict(). Évaluation simple à l'aide de accuracy_score.
Voici un résumé du code que vous avez vu, qui constitue un modèle de base pour tout projet de classification :
from sklearn.datasets import load_breast_cancer
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import accuracy_score
from sklearn.preprocessing import StandardScaler


# 1. Charger et préparer les données
data = load_breast_cancer()
X, y = data.data, data.target


# 2. Séparer les données
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)


# 3. Mettre les caractéristiques à l'échelle (une bonne pratique !)
scaler = StandardScaler()
X_train_scaled = scaler.fit_transform(X_train)
X_test_scaled = scaler.transform(X_test)


# 4. Initialiser et entraîner le modèle
# Notez les paramètres de régularisation que nous avons vus dans la leçon précédente !
model = LogisticRegression(penalty='l2', C=1.0)
model.fit(X_train_scaled, y_train)


# 5. Faire des prédictions
y_pred = model.predict(X_test_scaled)


# 6. Évaluer le modèle
accuracy = accuracy_score(y_test, y_pred)
print(f"Précision du modèle : {accuracy:.2f}")


# Vous pouvez aussi prédire des probabilités
probabilities = model.predict_proba(X_test_scaled)
print("\nProbabilités pour les 5 premiers échantillons de test :")
print(probabilities[:5])


# Chaque ligne a 2 valeurs : P(classe 0) et P(classe 1)
5. Connexion à la Régularisation
Vous avez peut-être remarqué les paramètres penalty='l2' et C=1.0 lors de l'initialisation de LogisticRegression. Cela devrait vous rappeler notre leçon précédente ! Tout comme pour la régression linéaire, nous pouvons (et devrions) appliquer une régularisation à la régression logistique pour éviter le surapprentissage.
penalty: Peut être'l1'(Lasso),'l2'(Ridge), ou'elasticnet'.C: Est l'inverse de la force de régularisation. UnCplus petit signifie une régularisation plus forte (plus de pénalité). C'est l'inverse de l'hyperparamètrealpha() que nous avons vu.
Il est crucial de toujours mettre vos données à l'échelle (StandardScaler) avant d'appliquer la régularisation, car la pénalité est sensible à l'échelle des coefficients.
L'article de DigitalOcean contient une excellente section qui détaille ces paramètres.
Mastering Logistic Regression with Scikit-Learn
Cette section explique les principaux hyperparamètres de la classe LogisticRegression de Scikit-learn.
Parcourez la section Parameters and Solvers. Concentrez-vous sur la compréhension des paramètres penalty et C, qui sont directement liés à ce que vous avez appris sur la régularisation. Le paramètre solver fait référence à l'algorithme d'optimisation utilisé pour minimiser la fonction de coût.
Conclusion
Félicitations ! Vous avez franchi une étape majeure en passant de la régression à la classification. La régression logistique est un outil puissant et interprétable qui sert de fondation à de nombreux concepts plus avancés en apprentissage automatique et en apprentissage profond.
Points clés à retenir :
- La régression logistique est un algorithme de classification binaire, malgré son nom.
- Elle utilise la fonction sigmoïde pour transformer une sortie linéaire en une probabilité comprise entre 0 et 1.
- La prédiction finale est déterminée en comparant cette probabilité à un seuil de décision (généralement 0.5).
- Le modèle est entraîné en minimisant la fonction de coût Log Loss (ou entropie croisée binaire).
- L'implémentation dans Scikit-learn est simple et vous pouvez appliquer les techniques de régularisation (L1, L2) que vous connaissez déjà.
Dans cette leçon, nous avons utilisé l'exactitude (accuracy) pour une première évaluation rapide. Cependant, pour les problèmes de classification, l'exactitude seule peut être trompeuse, surtout si les classes sont déséquilibrées. Dans la prochaine leçon, nous explorerons en détail un ensemble complet de métriques d'évaluation, notamment la matrice de confusion, la précision, le rappel et le score F1, qui vous donneront une image beaucoup plus complète de la performance de votre modèle.