Bonjour ! Dans la leçon précédente, nous avons conclu notre exploration de la réduction de dimensionnalité en apprenant à appliquer l'Analyse en Composantes Principales (ACP) avec Scikit-learn et, surtout, à interpréter la variance expliquée pour choisir le bon nombre de composantes. Vous avez vu que des étapes comme la standardisation (StandardScaler) et l'ACP sont des étapes de prétraitement cruciales.
Jusqu'à présent, nous avons appliqué ces étapes manuellement, l'une après l'autre. Ce processus peut devenir fastidieux, source d'erreurs, et surtout, il présente un risque subtil mais important appelé "fuite de données" (data leakage), où des informations de l'ensemble de test influencent involontairement l'entraînement.
Dans cette dernière leçon du module sur le machine learning classique, nous allons assembler toutes les pièces du puzzle. L'objectif est de construire un pipeline de machine learning complet avec Scikit-learn. Vous apprendrez à enchaîner les étapes de prétraitement et l'entraînement du modèle en un seul objet élégant et robuste. C'est une compétence essentielle qui rendra votre travail de modélisation plus propre, plus fiable et beaucoup plus efficace.
1. Qu'est-ce qu'un Pipeline et pourquoi en utiliser un ?
En machine learning, un projet typique implique une séquence d'étapes : nettoyage des données, imputation des valeurs manquantes, encodage des variables catégorielles, mise à l'échelle des variables numériques, et enfin, l'entraînement d'un modèle. Un pipeline Scikit-learn formalise cette séquence.
Fondamentalement, Scikit-learn distingue deux types d'objets :
- Les Transformers : Ils transforment les données. Ils possèdent des méthodes
.fit()(pour apprendre les paramètres de transformation, ex: la moyenne et l'écart-type pourStandardScaler) et.transform()(pour appliquer la transformation)..fit_transform()est un raccourci pratique. - Les Estimators : Ils estiment des paramètres à partir des données, typiquement un modèle. Ils possèdent une méthode
.fit()(pour entraîner le modèle) et une méthode.predict()(pour faire des prédictions).
Un Pipeline est un objet qui permet d'enchaîner plusieurs "transformers" et de terminer par un "estimator".
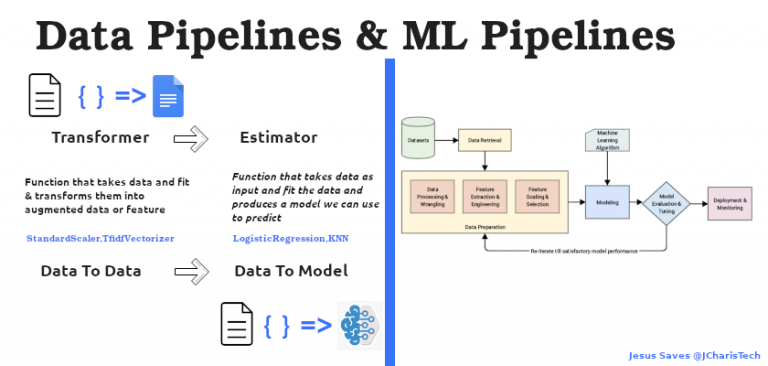
Les principaux avantages de l'utilisation des pipelines sont :
- Propreté du code : Il regroupe une séquence complexe d'opérations en un seul objet.
- Prévention des fuites de données : Le pipeline garantit que les transformations sont apprises uniquement sur les données d'entraînement et simplement appliquées aux données de test.
- Facilité d'expérimentation : Il est très simple de changer une étape du pipeline (par exemple, essayer un autre modèle) sans réécrire tout le code.
- Optimisation simplifiée : Comme nous le verrons, il permet de rechercher les meilleurs hyperparamètres pour toutes les étapes du pipeline en même temps à l'aide de
GridSearchCV. - Déploiement facile : Vous pouvez sauvegarder l'intégralité du pipeline entraîné (prétraitement + modèle) en un seul fichier.
2. Construire un Pipeline pour des données mixtes
Le cas le plus courant est celui où votre jeu de données contient différents types de colonnes (numériques, catégorielles) qui nécessitent des traitements différents. On ne peut pas appliquer StandardScaler à une colonne de texte, par exemple. C'est là qu'intervient le ColumnTransformer.
Le ColumnTransformer est un outil puissant qui applique des transformateurs spécifiés à des colonnes spécifiques de votre jeu de données. La stratégie est la suivante :
- Créer un petit pipeline pour les colonnes numériques (par exemple : imputer les valeurs manquantes, puis mettre à l'échelle).
- Créer un autre petit pipeline pour les colonnes catégorielles (par exemple : imputer, puis encoder en one-hot).
- Utiliser un
ColumnTransformerpour appliquer ces pipelines aux bonnes colonnes. Cet objet devient notre "préprocesseur" global. - Créer un pipeline final qui enchaîne ce "préprocesseur" et notre modèle (l'estimateur).
La vidéo suivante, bien qu'en anglais, est un guide pas à pas exceptionnel qui met en œuvre exactement cette logique.
Machine Learning Pipelines in Python: Step-by-Step Guide with Scikit-Learn
La vidéo "Code with Josh" propose un excellent guide pratique pour construire un préprocesseur complexe.
D'abord, regardez la section où il crée les pipelines séparés. Il construit un numerical_pipeline (avec imputation et mise à l'échelle) et un categorical_pipeline (avec imputation et encodage one-hot). Notez les différentes stratégies d'imputation (mean pour les nombres, most_frequent pour les catégories). Ensuite, regardez la partie cruciale où il joint les pipelines avec ColumnTransformer. Cet objet, qu'il nomme preprocessor, est la clé pour appliquer des traitements distincts à des sous-ensembles de colonnes différents.
Le schéma ci-dessous représente parfaitement la structure que nous sommes en train de construire. On y voit bien les deux branches de traitement (catégorielle et numérique) qui sont gérées par un ColumnTransformer, dont le résultat est ensuite envoyé au modèle de régression logistique.

3. Assembler le Pipeline final
Une fois que notre preprocessor (le ColumnTransformer) est créé, il agit lui-même comme un seul et unique "transformer". L'étape finale consiste à le placer dans un Pipeline global, suivi de notre estimateur (le modèle de machine learning).
A Comprehensive Guide For scikit-learn Pipelines
L'article du "MJ Blog" illustre cette construction de manière très structurée et claire.
Lisez la section sur le ColumnTransformer. Elle montre comment assembler les pipelines de prétraitement individuels (pour les variables nominales, ordinales et numériques) en un seul preprocessing_pipeline. Ensuite, lisez la section "Adding the model to the pipeline". Vous verrez comment ce preprocessing_pipeline est simplement ajouté comme première étape dans un complete_pipeline final, suivi par l'estimateur (le modèle). C'est l'étape qui finalise notre flux de travail.
Le code final ressemble à quelque chose comme ça :
from sklearn.pipeline import Pipeline
from sklearn.linear_model import LogisticRegression


# 'preprocessor' est le ColumnTransformer que nous avons créé à l'étape précédente
# 'LogisticRegression()' est notre modèle

final_pipeline = Pipeline(steps=[
    ('preprocessor', preprocessor),
    ('classifier', LogisticRegression())
])


# Entraîner le pipeline complet sur les données brutes
final_pipeline.fit(X_train, y_train)


# Faire des prédictions
predictions = final_pipeline.predict(X_test)
La beauté de cette approche est sa simplicité. Vous n'interagissez qu'avec l'objet final_pipeline, qui gère toute la complexité en interne.
4. La puissance cachée des Pipelines : L'optimisation d'hyperparamètres
L'un des avantages les plus significatifs de l'utilisation des pipelines apparaît lorsque l'on souhaite optimiser les hyperparamètres avec GridSearchCV. Un pipeline vous permet de rechercher simultanément les meilleurs hyperparamètres pour les étapes de prétraitement et pour le modèle.
Par exemple, vous pourriez vouloir tester si l'imputation par la moyenne est meilleure que par la médiane, tout en testant différentes valeurs pour l'hyperparamètre C de votre régression logistique. Avec un pipeline, c'est possible. Il suffit de définir la grille de paramètres en utilisant une syntaxe spéciale : nom_etape__parametre.
Cette vidéo en arabe explique très bien ce concept.
Pipelines in Scikit-learn - بالعربي
La vidéo de la chaîne "Ons أنس" illustre de manière très claire comment combiner pipelines, ColumnTransformer et GridSearchCV.
Regardez d'abord comment il construit un pipeline complet avec un ColumnTransformer imbriqué, très similaire à ce que nous venons de décrire. Ensuite, portez une attention particulière à la section sur le Grid Search. L'auteur explique comment définir une grille de paramètres qui cible des étapes à l'intérieur du pipeline. Notez la syntaxe spéciale nom_etape__nom_sous_etape__parametre (avec deux tirets bas __) pour accéder aux hyperparamètres des composants imbriqués. C'est une technique extrêmement puissante.
Par exemple, pour changer la stratégie d'imputation dans la branche numérique (num) de notre préprocesseur (preprocessor), le paramètre dans la grille de GridSearchCV serait :'preprocessor__num__imputer__strategy': ['mean', 'median']
Pour changer l'hyperparamètre C du classifieur :'classifier__C': [0.1, 1, 10]
GridSearchCV testera alors toutes les combinaisons pour trouver la meilleure configuration globale du pipeline.
Enfin, une fois votre pipeline optimal trouvé et entraîné, vous pouvez le sauvegarder sur disque en un seul fichier avec la bibliothèque joblib.
import joblib


# Sauvegarder le pipeline entraîné
joblib.dump(final_pipeline, 'mon_modele_complet.pkl')


# Charger le pipeline plus tard pour faire des prédictions
loaded_pipeline = joblib.load('mon_modele_complet.pkl')
predictions_nouvelles_donnees = loaded_pipeline.predict(nouvelles_donnees)
Conclusion
Cette leçon conclut notre parcours dans le monde du machine learning classique avec Scikit-learn. Vous avez maintenant une boîte à outils complète pour aborder une grande variété de problèmes.
Points clés à retenir :
- Les pipelines (
Pipeline) enchaînent des étapes de transformation de données et se terminent par un modèle (estimateur). - Le
ColumnTransformerest essentiel pour gérer les données à types mixtes, en appliquant différents pipelines de prétraitement à différentes colonnes. - L'assemblage de ces outils crée un objet unique et robuste qui simplifie l'entraînement, la prédiction et le déploiement.
- Les pipelines préviennent les fuites de données en appliquant correctement les transformations
fitsur l'ensemble d'entraînement ettransformsur l'ensemble de test. - Ils débloquent une optimisation d'hyperparamètres puissante et globale via
GridSearchCVen utilisant la syntaxeetape__parametre.
Dans le prochain module, nous allons changer de cap pour jeter les bases de l'apprentissage profond (deep learning) avec PyTorch. Nous commencerons par un concept fondamental de la programmation moderne : la Programmation Orientée Objet (POO) en Python, et plus particulièrement les classes. Cette idée d'encapsuler des données et des fonctionnalités dans des "objets", que vous venez d'expérimenter de manière conceptuelle avec les Pipelines, est absolument centrale à la conception des frameworks de deep learning comme PyTorch.