Bonjour ! Dans la leçon précédente, nous avons exploré en détail le broadcasting, le mécanisme puissant de NumPy qui permet d'effectuer des opérations sur des tableaux de formes différentes. Vous avez appris les règles qui régissent ce mécanisme et comment l'utiliser pour écrire du code plus concis et efficace.
Aujourd'hui, nous allons mettre à profit cette connaissance des opérations sur les tableaux pour aborder un sujet fondamental en analyse de données et en machine learning : les calculs statistiques. L'objectif de cette leçon est de vous apprendre à utiliser les fonctions NumPy pour les calculs statistiques de base (moyenne, écart-type, somme, minimum, maximum). Ces opérations, appelées agrégations, sont essentielles pour résumer et comprendre de grands ensembles de données. Elles constituent la première étape de quasi toute analyse exploratoire et sont au cœur de nombreuses métriques de performance en apprentissage automatique.
1. Qu'est-ce qu'une Agrégation ?
En analyse de données, une agrégation est une opération qui réduit un ensemble de valeurs à une seule valeur de résumé. Par exemple, calculer la somme ou la moyenne d'une liste de nombres sont des agrégations. NumPy excelle dans ce domaine en fournissant des fonctions d'agrégation rapides et efficaces qui opèrent directement sur les ndarray.
Pour commencer, voici une "cheat sheet" qui résume de nombreuses fonctions NumPy, y compris celles que nous allons voir aujourd'hui. Gardez-la comme référence rapide.

Les fonctions statistiques de base que nous allons explorer sont :
np.sum(): Calcule la somme des éléments.np.min(): Trouve la valeur minimale.np.max(): Trouve la valeur maximale.np.mean(): Calcule la moyenne arithmétique.np.std(): Calcule l'écart-type (une mesure de la dispersion des données autour de la moyenne).
Commençons par voir comment elles s'appliquent à un tableau simple.
2. Agrégations sur des Tableaux 1D
Le cas le plus simple est d'agréger toutes les valeurs d'un tableau unidimensionnel.
import numpy as np

arr = np.array([0, 1, 2, 3, 4, 5, 6, 7, 8, 9])


# Calculer la somme de tous les éléments
somme_totale = np.sum(arr)
print(f"Somme : {somme_totale}") # Affiche 45


# Calculer la moyenne
moyenne = np.mean(arr)
print(f"Moyenne : {moyenne}") # Affiche 4.5


# Trouver le minimum et le maximum
val_min = np.min(arr)
val_max = np.max(arr)
print(f"Min: {val_min}, Max: {val_max}") # Affiche Min: 0, Max: 9


# Calculer l'écart-type
ecart_type = np.std(arr)
print(f"Écart-type : {ecart_type:.2f}") # Affiche 2.87
Il est important de noter que NumPy propose deux syntaxes pour ces opérations : la fonction (np.sum(arr)) et la méthode de l'objet tableau (arr.sum()). Les deux sont équivalentes en termes de résultat et de performance.
print(f"Somme (méthode) : {arr.sum()}")
print(f"Moyenne (méthode) : {arr.mean()}")
L'un des avantages majeurs de NumPy est sa performance. Ces opérations sont exécutées en code C compilé, ce qui est beaucoup plus rapide que d'utiliser les fonctions Python natives (comme sum()) sur de grands ensembles de données.
Pour approfondir ce point et voir une liste plus complète des fonctions, je vous invite à lire l'extrait suivant du Python Data Science Handbook.
Aggregations: Min, Max, and Everything In Between
Ce texte présente les fonctions d'agrégation de base, explique leur avantage en termes de performance par rapport à Python, et fournit une table de référence très utile.
Commencez par lire l'introduction pour bien saisir le concept de "summary statistics". Poursuivez avec les sections Summing, Minimum, and Maximum. Notez la comparaison de vitesse entre la fonction sum de Python et np.sum. Enfin, parcourez la table dans la section Other aggregation functions. Elle liste les fonctions que nous voyons (sum, mean, std, etc.) et leurs équivalents "NaN-safe", qui ignorent les valeurs manquantes.
3. Agrégations sur des Axes Spécifiques
La véritable puissance des agrégations NumPy apparaît avec les tableaux multidimensionnels. Ici, le concept d'axe, que nous avons abordé dans la leçon sur le broadcasting, devient crucial. On peut choisir d'agréger le tableau entier ou de le faire le long d'un axe spécifique.
Considérons une matrice 2D représentant, par exemple, les notes de 3 étudiants à 4 examens.
notes = np.array([[80, 85, 90, 92],  # Étudiant 0
                  [75, 88, 94, 89],  # Étudiant 1
                  [91, 93, 87, 95]]) # Étudiant 2
Si nous appliquons une fonction d'agrégation sans spécifier d'axe, NumPy calcule la statistique sur l'ensemble des 12 notes.
moyenne_globale = np.mean(notes)
print(f"Moyenne globale de la classe : {moyenne_globale:.2f}") # Affiche 88.67
C'est utile, mais on souhaite souvent des statistiques plus fines. Par exemple, quelle est la note moyenne de chaque étudiant ? Ou quel a été l'examen le plus difficile (celui avec la moyenne la plus basse) ? Pour cela, nous utilisons le paramètre axis.
axis=0: Opère "vers le bas", en agrégeant les valeurs de chaque colonne. Le résultat aura autant d'éléments qu'il y a de colonnes.axis=1: Opère "à travers", en agrégeant les valeurs de chaque ligne. Le résultat aura autant d'éléments qu'il y a de lignes.
Exemple : Moyenne par examen (colonne)
Pour obtenir la moyenne de chaque examen, nous agrégeons le long de l'axe 0.
moyenne_par_examen = np.mean(notes, axis=0)
print(f"Moyenne par examen : {moyenne_par_examen}")


# Affiche [82.         88.66666667 90.33333333 92.        ]
# L'examen 0 a été le plus difficile en moyenne.
Exemple : Moyenne par étudiant (ligne)
Pour obtenir la moyenne de chaque étudiant, nous agrégeons le long de l'axe 1.
moyenne_par_etudiant = np.mean(notes, axis=1)
print(f"Moyenne par étudiant : {moyenne_par_etudiant}")


# Affiche [86.75 86.5  91.5 ]
# L'étudiant 2 a la meilleure moyenne.
La vidéo suivante explique ce concept d'axe de manière très claire, en montrant comment les opérations "s'effondrent" (collapse) le long de la dimension choisie.
Learn NumPy in 40 Minutes - Python NumPy Tutorial
Cette vidéo de Tech With Tim offre une excellente décomposition de ce que signifient les dimensions et les axes, puis montre comment les utiliser pour effectuer des opérations statistiques ciblées.
Regardez d'abord l'explication conceptuelle des dimensions et des axes. Ensuite, concentrez-vous sur l'exemple pratique de somme sur les axes 0 et 1. Il illustre parfaitement comment les calculs sont effectués et la forme du tableau résultant.
4. Application en Machine Learning : Calcul d'Erreur
Ces fonctions sont omniprésentes en machine learning. Un exemple fondamental est le calcul d'une fonction de coût (ou loss function), qui mesure à quel point les prédictions d'un modèle sont "fausses" par rapport aux vraies valeurs.
Une des fonctions de coût les plus courantes est l'Erreur Quadratique Moyenne (Mean Squared Error - MSE). Sa formule est :
Où est le nombre d'exemples.
Grâce à NumPy, le calcul est incroyablement simple. Supposons que nous ayons deux tableaux : y_vrai (les vraies valeurs) et y_predit (les prédictions de notre modèle).
- Calculer la différence :
erreur = y_vrai - y_predit(opération vectorisée) - Élever au carré :
erreur_carree = np.square(erreur) - Calculer la moyenne :
mse = np.mean(erreur_carree)
Voici un exemple complet :
y_vrai = np.array([1, 2, 3, 4, 5])
y_predit = np.array([1.1, 2.3, 2.8, 4.3, 5.1])


# On peut enchaîner les opérations pour un code concis
mse = np.mean(np.square(y_vrai - y_predit))

print(f"Erreur Quadratique Moyenne (MSE) : {mse:.2f}") # Affiche 0.08
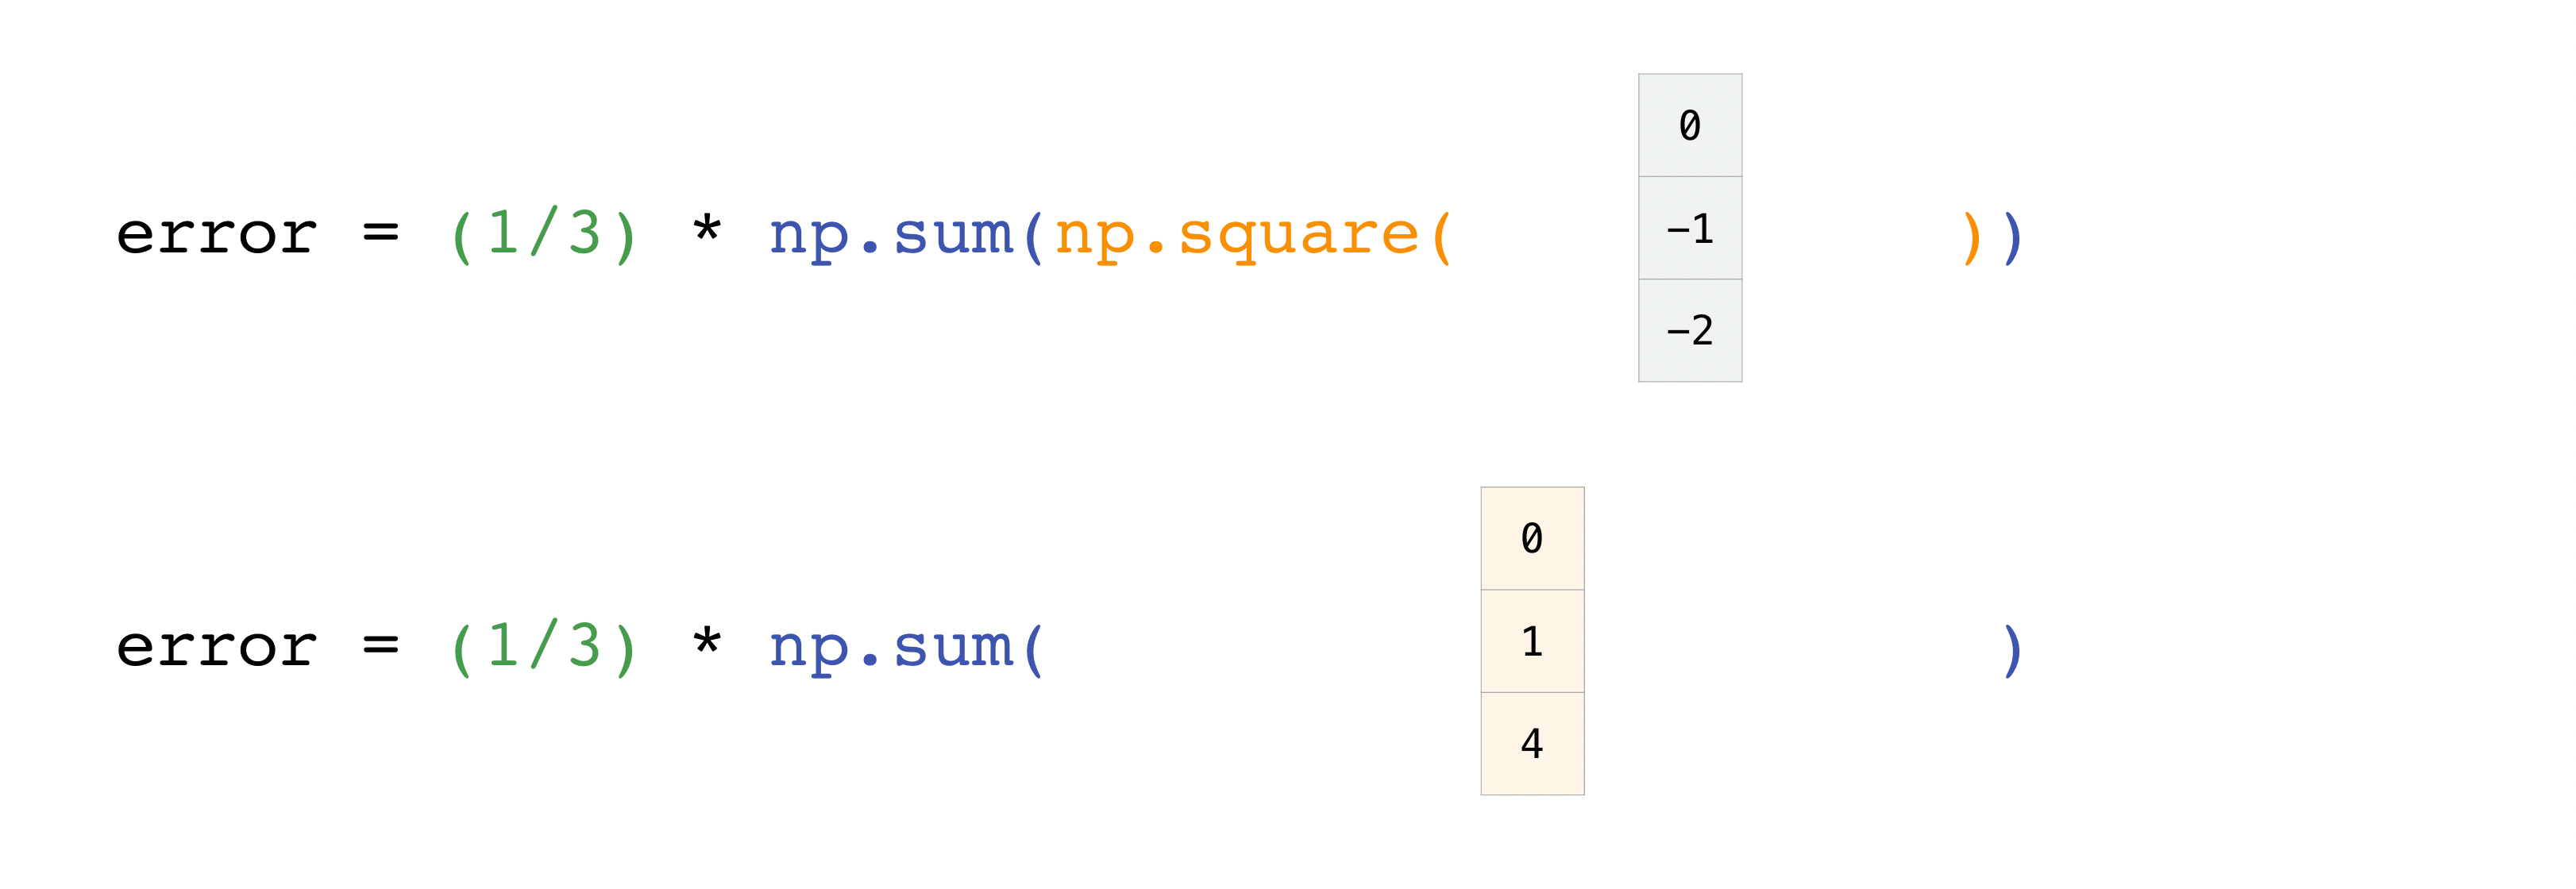
L'image suivante illustre cette séquence d'opérations. D'abord, on élève au carré les différences, puis on somme (ou ici, on prend la moyenne) les résultats.
Exercice Pratique
Vous avez reçu des données de capteurs sur 5 jours, avec 4 mesures par jour. Ces données sont stockées dans un tableau NumPy 2D où chaque ligne représente un jour et chaque colonne une heure de mesure.
donnees_capteur = np.array([[19, 21, 22, 20],   # Jour 0
                            [18, 20, 21, 21],   # Jour 1
                            [22, 23, 24, 23],   # Jour 2
                            [24, 25, 25, 24],   # Jour 3
                            [20, 21, 22, 22]])  # Jour 4
En utilisant les fonctions d'agrégation de NumPy, calculez :
- La température maximale enregistrée sur toute la période de 5 jours.
- La température minimale enregistrée chaque jour.
- La température moyenne pour chaque heure de mesure (c'est-à-dire la moyenne de chaque colonne).
- L'écart-type de la température pour chaque jour (pour voir les jours avec le plus de variation).
Solutions
import numpy as np

donnees_capteur = np.array([[19, 21, 22, 20],
                            [18, 20, 21, 21],
                            [22, 23, 24, 23],
                            [24, 25, 25, 24],
                            [20, 21, 22, 22]])


# 1. Température maximale sur toute la période
temp_max_globale = np.max(donnees_capteur)
print(f"1. Température maximale globale : {temp_max_globale}")


# 2. Température minimale chaque jour (min de chaque ligne)
temp_min_par_jour = np.min(donnees_capteur, axis=1)
print(f"2. Température minimale par jour : {temp_min_par_jour}")


# 3. Température moyenne pour chaque heure de mesure (moyenne de chaque colonne)
temp_moyenne_par_heure = np.mean(donnees_capteur, axis=0)
print(f"3. Température moyenne par heure : {temp_moyenne_par_heure}")


# 4. Écart-type pour chaque jour (std de chaque ligne)
std_par_jour = np.std(donnees_capteur, axis=1)
print(f"4. Écart-type par jour : {std_par_jour}")
Conclusion
Vous savez maintenant comment utiliser les principales fonctions d'agrégation de NumPy pour obtenir des statistiques descriptives à partir de vos données. Cette compétence est un pilier de l'analyse de données et du machine learning.
Points clés à retenir :
- Les fonctions d'agrégation comme
np.sum(),np.mean(),np.std(),np.min(),np.max()permettent de résumer des données. - Elles sont beaucoup plus performantes que les équivalents Python sur des tableaux NumPy.
- L'argument
axisest essentiel pour effectuer des calculs sur des lignes (axis=1) ou des colonnes (axis=0) spécifiques dans un tableau 2D. - Ces fonctions sont fondamentales pour des tâches pratiques comme le calcul des métriques d'erreur en machine learning.
Dans la prochaine leçon, nous continuerons à explorer les capacités de NumPy en nous concentrant sur les opérations matricielles. Vous apprendrez à effectuer le produit matriciel (produit scalaire), à calculer la transposée et l'inverse d'une matrice, des opérations directement issues de l'algèbre linéaire et indispensables pour de nombreux algorithmes.