Bonjour ! Dans la leçon précédente, nous avons examiné de près le bloc de construction fondamental des réseaux de neurones pour la vision par ordinateur : la couche de convolution. Vous avez appris comment elle utilise des filtres pour détecter des caractéristiques locales dans une image, un processus à la fois puissant et efficace.
Aujourd'hui, nous allons assembler les pièces du puzzle. Une couche de convolution seule ne constitue pas un réseau. L'objectif de cette leçon est de décrire l'architecture d'un Réseau de Neurones Convolutif (CNN) complet, y compris les couches de pooling. Nous allons voir comment les couches de convolution sont combinées avec d'autres types de couches essentielles pour créer un système capable de passer d'une image brute à une prédiction finale.
1. Les trois composants principaux d'un CNN
Un CNN typique est composé d'une séquence de trois types de couches, chacune ayant un rôle distinct :
- Couches de Convolution (Convolutional Layers) : Comme nous l'avons vu, leur rôle est d'extraire des caractéristiques (contours, textures, formes...) de l'image. C'est la partie "feature extraction" du réseau.
- Couches de Pooling (Pooling Layers) : Leur but est de réduire la taille des cartes de caractéristiques, ce qui diminue le nombre de calculs et rend le réseau plus robuste aux petites variations.
- Couches Entièrement Connectées (Fully-Connected Layers) : Situées à la fin du réseau, elles agissent comme un classifieur qui prend les caractéristiques de haut niveau extraites par les couches précédentes et produit le résultat final (par exemple, la classe de l'image).
L'article suivant donne un excellent aperçu de ces composants avant que nous ne les examinions en détail.
Convolutional Neural Network (CNN) Architecture Explained in ...
Cet article de "Towards Data Science" présente clairement les blocs de construction qui composent un CNN.
Lisez les courtes sections Layers in a CNN et Operations in a CNN. Cela vous donnera une vue d'ensemble des trois principaux types de couches que nous allons maintenant explorer en détail.
2. La couche de Pooling : Réduire et Stabiliser
Après avoir appliqué une couche de convolution (généralement suivie d'une fonction d'activation comme ReLU), nous obtenons une ou plusieurs cartes de caractéristiques. Ces cartes peuvent encore être assez grandes. C'est là qu'intervient la couche de pooling (ou sous-échantillonnage).
Le pooling a deux objectifs principaux :
- Réduire la dimension spatiale des cartes de caractéristiques. Une carte de 24x24 peut devenir une carte de 12x12, ce qui réduit considérablement le nombre de paramètres et la charge de calcul pour les couches suivantes.
- Rendre la détection de caractéristiques plus robuste. En résumant les informations sur une petite zone, le réseau devient moins sensible à la position exacte de la caractéristique. Qu'un œil soit détecté un pixel plus à gauche ou à droite n'aura pas d'impact majeur sur la sortie du pooling.
La vidéo suivante, par Andrew Ng, est une introduction parfaite au concept.
Cette vidéo de la chaîne DeepLearningAI explique de manière très claire la motivation et le mécanisme des couches de pooling.
Regardez d'abord l'introduction qui explique le but du pooling. Ensuite, suivez attentivement son exemple pas à pas du max pooling, la méthode la plus courante, de son calcul. Enfin, écoutez son intuition sur l'efficacité de cette méthode : elle préserve une caractéristique si elle est détectée n'importe où dans une région.
Comme vous l'avez vu, le Max Pooling est simple : on fait glisser une fenêtre (par exemple, 2x2) sur la carte de caractéristiques et, pour chaque position, on ne conserve que la valeur maximale de cette fenêtre.
Il existe une autre méthode, moins courante, appelée Average Pooling, qui calcule la moyenne des valeurs dans la fenêtre au lieu du maximum. Le max pooling est généralement préféré car il préserve les caractéristiques les plus fortes (les activations les plus élevées).
Visual Guide to Applied Convolution Neural Networks
Cet article de Pinecone approfondit le rôle du pooling et compare les deux principaux types.
Lisez la section "Pooling Layers". Portez une attention particulière à la manière dont le pooling aide à rendre le réseau moins sensible à la localisation exacte des caractéristiques, et à la différence entre l'average et le max pooling.
L'image ci-dessous illustre bien l'effet visuel des deux types de pooling.

Un point crucial à retenir est qu'une couche de pooling n'a aucun paramètre à apprendre. C'est une opération fixe définie par ses hyperparamètres (la taille de la fenêtre et le pas, ou stride). Le réseau n'apprend rien durant cette étape ; il ne fait que réduire la dimension.
Revenons à la vidéo d'Andrew Ng pour résumer les propriétés des couches de pooling.
Regardez le résumé à partir de hyperparameters for pooling. L'information la plus importante est qu'une couche de pooling a des hyperparamètres (comme la taille du filtre et le pas), mais aucun paramètre à apprendre.
3. Les étapes finales : Aplatissement et Couches Entièrement Connectées
Après plusieurs paires de couches CONV -> POOL, le réseau a produit un ensemble de cartes de caractéristiques de petite taille mais riches en information, représentant des motifs complexes de l'image.
Pour passer de ces cartes (qui sont des matrices 2D ou des tenseurs 3D) à une décision de classification finale (par exemple, "chat", "chien", "voiture"), nous devons revenir à une structure de réseau de neurones classique.
Cela se fait en deux temps :
- L'opération d'Aplatissement (Flattening) : On transforme simplement les cartes de caractéristiques multidimensionnelles en un unique et long vecteur 1D.
- Les couches Entièrement Connectées (Fully-Connected Layers) : Ce vecteur est ensuite passé à une ou plusieurs couches entièrement connectées, exactement comme celles que nous avons étudiées dans les modules précédents. La dernière couche aura généralement autant de neurones que de classes à prédire, avec une fonction d'activation Softmax pour obtenir une distribution de probabilité.
L'article suivant illustre parfaitement cette transition.
Convolutional Neural Network (CNN) Architecture Explained in ...
Cet article montre clairement la transition des cartes de caractéristiques à la tête de classification finale.
Lisez d'abord la section "Flatten operation" pour voir comment la sortie multidimensionnelle des couches de pooling est transformée en un vecteur 1D. Ensuite, lisez la brève section sur les "Fully connected (dense) layers" pour comprendre leur rôle de classifieur final.
4. L'Architecture Complète
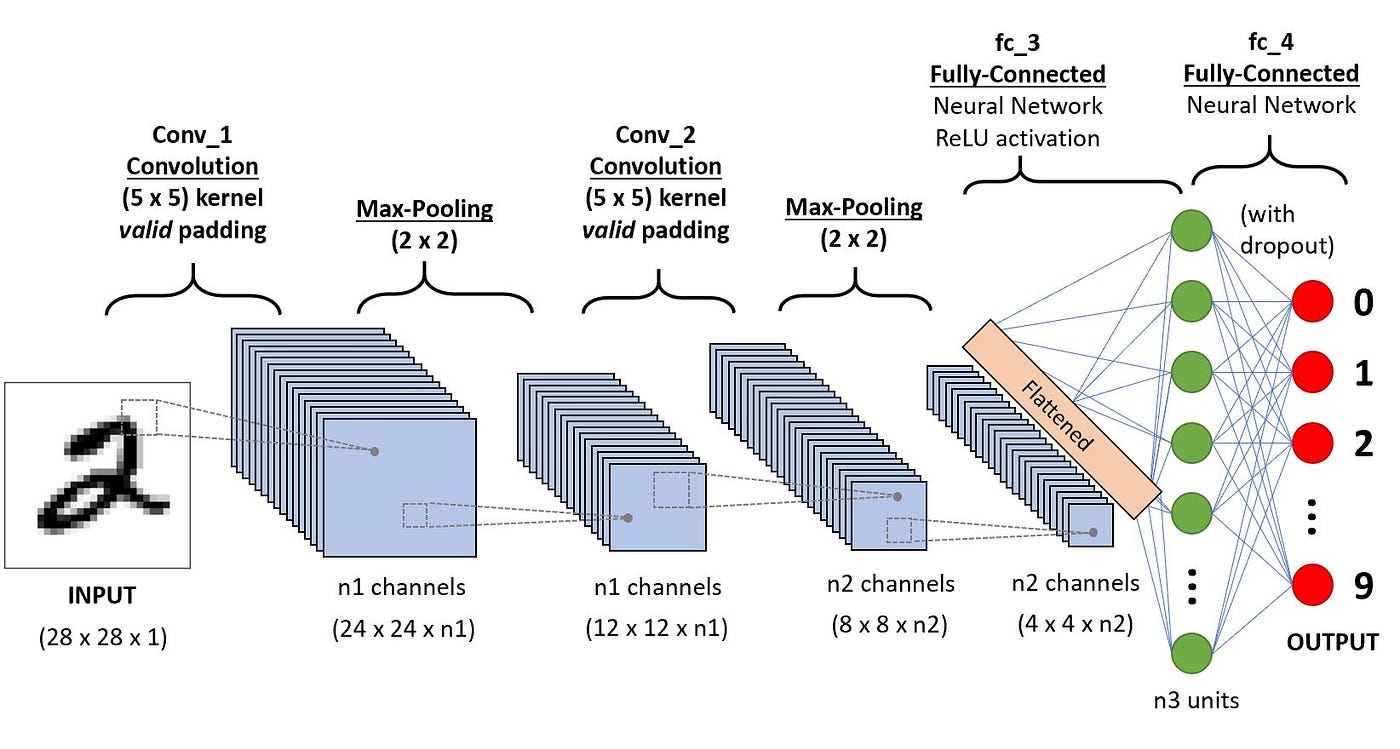
Nous pouvons maintenant assembler tous ces éléments pour former un CNN complet. L'architecture typique est une séquence :
INPUT -> [CONV -> RELU -> POOL] -> [CONV -> RELU -> POOL] -> ... -> FLATTEN -> FC -> RELU -> FC (OUTPUT)
Cette structure crée une hiérarchie de caractéristiques :
- Les premières couches convolutives apprennent à détecter des caractéristiques très simples (contours, couleurs, gradients).
- Les couches suivantes combinent ces caractéristiques simples pour en détecter de plus complexes (des yeux, des nez, des formes rondes).
- Les dernières couches convolutives détectent des parties d'objets (un visage, une roue de voiture).
- Enfin, les couches entièrement connectées prennent ces informations de haut niveau et décident de la classe de l'objet.
La vidéo suivante résume parfaitement ce pipeline.
Simple explanation of convolutional neural network | Deep Learning Tutorial 23 (Tensorflow & Python)
Cette vidéo de la chaîne codebasics offre un excellent résumé de la manière dont tous les composants d'un CNN s'articulent.
Regardez la section qui présente l'architecture complète. Elle montre le motif répétitif CONV -> RELU -> POOL pour l'extraction de caractéristiques, suivi par l'aplatissement et un réseau entièrement connecté pour la classification. C'est la structure classique d'un CNN.
Le diagramme ci-dessous illustre une architecture typique pour la reconnaissance de chiffres manuscrits, comme la fameuse architecture LeNet.
Conclusion
Dans cette leçon, vous avez découvert comment les différents blocs de construction s'assemblent pour former une architecture de Réseau de Neurones Convolutif complète et fonctionnelle.
Points clés à retenir :
- Un CNN est principalement composé de trois types de couches : Convolution, Pooling, et Entièrement Connectée.
- Les couches de convolution (avec activation ReLU) sont responsables de l'extraction de caractéristiques de manière hiérarchique.
- Les couches de pooling (généralement Max Pooling) réduisent la taille des cartes de caractéristiques, ce qui diminue la charge de calcul et rend le modèle plus robuste. Elles n'ont pas de paramètres apprenables.
- Les couches entièrement connectées agissent comme la "tête" du réseau, prenant les caractéristiques extraites et réalisant la tâche de classification finale.
- L'opération Flatten est le pont qui permet de passer des cartes de caractéristiques 2D/3D au format vecteur 1D requis par les couches entièrement connectées.
Maintenant que vous maîtrisez la théorie de l'architecture des CNNs, la prochaine étape est de passer à la pratique. Dans la prochaine leçon, nous allons construire et entraîner notre tout premier CNN en utilisant PyTorch pour classifier des images.